 Coach
Un alineamiento de dos secuencias las escribe una sobre la otra, con huecos (–) insertados de modo que las columnas emparejen un residuo con un residuo o un residuo con un hueco, y ninguna columna empareje dos huecos. Su puntuación es la suma, sobre las columnas, de una puntuación de sustitución por cada par de residuos y de una penalización por hueco por cada hueco: una penalización lineal por posición de hueco o, de forma más realista, una penalización afín por una tirada de huecos, con un coste de apertura mayor que el coste de extensión , ya que una sola inserción de varios residuos es un único suceso evolutivo. Un alineamiento global cubre ambas secuencias de extremo a extremo; un alineamiento local halla el par de subcadenas de mayor puntuación e ignora el resto, que es lo que uno quiere cuando un dominio compartido se sitúa en dos proteínas por lo demás no emparentadas.
Ejemplos
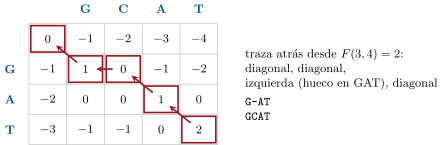
Ejemplo 5.3 (Una tabla de cuatro por tres)
Alinéese GAT con GCAT, puntuando una coincidencia, una discrepancia y . Los bordes son a lo largo de la fila superior y por el lado. Rellenando fila a fila: , , , ; , , , ; , , , . El óptimo es , y siguiendo hacia atrás — diagonal desde (T,T), diagonal desde (A,A), luego a la izquierda de (G,C) a (G,G) y después diagonal — se obtiene
tres coincidencias y un hueco: .
Ejemplo 5.10 (Leer un valor E)
Una consulta de residuos contra una base de datos de residuos tiene . Un acierto con una puntuación en bits de tiene : es homólogo con certeza prácticamente absoluta. Un acierto con tiene : se esperan once puntuaciones así por azar, y el acierto no significa nada. El mismo alineamiento, con la misma puntuación en bits, buscado en una base de datos diez veces mayor, tiene un diez veces mayor — la significación es una propiedad de la búsqueda, no del par. El umbral de uso común es para un homólogo fiable; – merece una segunda mirada con un método de perfil.