 Coach
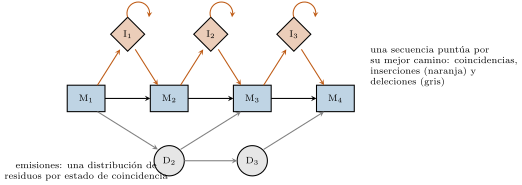
Un alineamiento múltiple de secuencias dispone una familia de secuencias en columnas de residuos homólogos. La programación dinámica exacta sobre secuencias cuesta y es imposible más allá de tres; los programas prácticos alinean de forma progresiva, primero el par más próximo según un árbol guía y luego secuencias y grupos al alineamiento creciente, con rondas de refinamiento. Un alineamiento terminado se resume en un perfil: para cada columna, la frecuencia de cada residuo y de los huecos. Un modelo oculto de Markov de perfil formaliza esto como una cadena de estados de coincidencia, uno por columna conservada, cada uno emitiendo residuos con sus propias probabilidades, con estados de inserción y de deleción que permiten residuos adicionales o ausentes en cada posición; el modelo de una familia (una entrada de Pfam) puntúa una secuencia nueva por la probabilidad del mejor camino a través de los estados, y encuentra homólogos muy por debajo de la zona crepuscular de la comparación por pares, porque una columna que solo tolera residuos hidrófobos lo dice, mientras que una secuencia aislada no puede.
Ejemplos
Ejemplo 5.7 (Identidad, similitud y la zona crepuscular)
Dos secuencias de proteína aleatorias alineadas de forma óptima con huecos alcanzan por azar entre el de identidad. Por encima del de identidad a lo largo de cien residuos, dos proteínas son casi con seguridad homólogas; entre el y el está la zona crepuscular, donde la identidad por sí sola no decide y debe hacerlo la estadística de más abajo. Los homólogos pueden caer muy por debajo de la zona: las subunidades de la hemoglobina y la mioglobina comparten un de identidad, la lisozima y la -lactalbúmina un , y muchos pares de proteínas con el mismo plegamiento comparten menos del , detectable solo comparando perfiles o estructuras.
Ejemplo 5.10 (Leer un valor E)
Una consulta de residuos contra una base de datos de residuos tiene . Un acierto con una puntuación en bits de tiene : es homólogo con certeza prácticamente absoluta. Un acierto con tiene : se esperan once puntuaciones así por azar, y el acierto no significa nada. El mismo alineamiento, con la misma puntuación en bits, buscado en una base de datos diez veces mayor, tiene un diez veces mayor — la significación es una propiedad de la búsqueda, no del par. El umbral de uso común es para un homólogo fiable; – merece una segunda mirada con un método de perfil.