Biología universitaria — tercer año · Bachelor Year 3
5Bioinformática y análisis de secuencias
Un biólogo que acaba de secuenciar un gen de un gusano abisal pega sus aminoácidos en un formulario web y, tres segundos después, descubre que la proteína es prima lejana de una quinasa humana, con un de identidad a lo largo de residuos y una probabilidad de de que el parecido sea azar. Detrás de esos tres segundos hay un algoritmo de programación dinámica de 1970, una teoría estadística de los alineamientos aleatorios, matrices de sustitución destiladas de miles de familias de proteínas y una base de datos de unos cien mil millones de residuos. Este capítulo trata del razonamiento que hay dentro de la caja: cómo se alinean dos secuencias de manera que el alineamiento sea demostrablemente el mejor, cómo se logra que la puntuación signifique algo, cómo se distingue una coincidencia de una casualidad y cómo se encuentran patrones en un genoma que nadie ha mirado antes. La matemática es elemental — una recurrencia, un logaritmo, una distribución de Poisson — y conviene conocerla, porque toda conclusión extraída de una comparación de secuencias descansa en ella.
5.1 Alinear dos secuencias
Definición 5.1 (Alineamiento y puntuación)
Un alineamiento de dos secuencias las escribe una sobre la otra, con huecos (–) insertados de modo que las columnas emparejen un residuo con un residuo o un residuo con un hueco, y ninguna columna empareje dos huecos. Su puntuación es la suma, sobre las columnas, de una puntuación de sustitución por cada par de residuos y de una penalización por hueco por cada hueco: una penalización lineal por posición de hueco o, de forma más realista, una penalización afín por una tirada de huecos, con un coste de apertura mayor que el coste de extensión , ya que una sola inserción de varios residuos es un único suceso evolutivo. Un alineamiento global cubre ambas secuencias de extremo a extremo; un alineamiento local halla el par de subcadenas de mayor puntuación e ignora el resto, que es lo que uno quiere cuando un dominio compartido se sitúa en dos proteínas por lo demás no emparentadas.
Teorema 5.2 (Needleman–Wunsch)
Sean e , con penalización lineal por hueco . Defínase como la mejor puntuación de un alineamiento global de los prefijos e . Entonces , y, para ,
es la puntuación global óptima, un alineamiento óptimo se recupera siguiendo hacia atrás desde las decisiones que produjeron cada máximo, y todo el cálculo cuesta pasos. La variante de Smith–Waterman para el alineamiento local añade como cuarta opción del máximo, pone los bordes a y lee la respuesta en la mayor entrada de la tabla.
Demostración. Considérese la última columna de cualquier alineamiento de los dos prefijos. Es una de tres cosas: sobre , sobre un hueco o un hueco sobre . Quitarla deja un alineamiento de , de o de respectivamente, cuya puntuación es como mucho de ese par; y, a la inversa, cada uno de esos alineamientos óptimos puede extenderse con la última columna correspondiente. Así que la mejor puntuación que termina en cada tipo de columna es del par más corto más la puntuación de la columna, y el óptimo es el mayor de los tres. Los bordes están forzados (contra un prefijo vacío solo caben huecos). La inducción sobre rellena la tabla; el número de celdas es . Para el alineamiento local la opción adicional significa “empiécese aquí un alineamiento nuevo”, lo que hace de la mejor puntuación de un alineamiento que termina en , y el mejor alineamiento local termina en algún sitio. ∎
Ejemplo 5.3 (Una tabla de cuatro por tres)
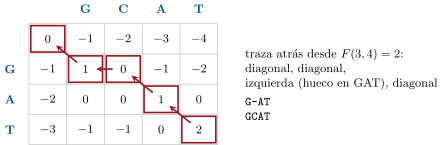
Alinéese GAT con GCAT, puntuando una coincidencia, una discrepancia y . Los bordes son a lo largo de la fila superior y por el lado. Rellenando fila a fila: , , , ; , , , ; , , , . El óptimo es , y siguiendo hacia atrás — diagonal desde (T,T), diagonal desde (A,A), luego a la izquierda de (G,C) a (G,G) y después diagonal — se obtiene
tres coincidencias y un hueco: .
Método 5.4 (Alinear dos secuencias)
(1) Elíjase la puntuación: una matriz de sustitución adecuada a la divergencia esperada (BLOSUM62 para proteínas de distancia desconocida; coincidencia y discrepancia para el ADN) y penalizaciones afines por hueco (típicamente apertura y extensión con BLOSUM62). (2) Decídase global o local: global para dos secuencias que se creen homólogas en toda su longitud, y local en los demás casos. (3) Rellénese la tabla con la recurrencia, guardando en cada celda un puntero a la decisión que dio su máximo. (4) Trácese hacia atrás desde (en el global) o desde la celda máxima hasta un cero (en el local), escribiendo el alineamiento de derecha a izquierda. (5) Júzguese el resultado no por su puntuación bruta sino por su significación estadística (más abajo), y mírese: los huecos largos, las tiradas de baja complejidad y los alineamientos confinados a una repetición son avisos.
5.2 Puntuar: cuánto vale una coincidencia
Definición 5.5 (Matrices de sustitución)
Una matriz de sustitución da para cada par de aminoácidos como una puntuación de log-verosimilitudes:
donde es la frecuencia con la que y aparecen alineados en alineamientos fiables de proteínas emparentadas, la frecuencia con la que se emparejarían por azar y una escala elegida para que las entradas sean enteros cómodos. Una puntuación positiva significa que el par aparece más a menudo en homólogos que por azar; las puntuaciones de identidad son mayores para los aminoácidos raros (triptófano , cisteína en BLOSUM62) y menores para los frecuentes (leucina , alanina ), y las sustituciones conservadoras (isoleucina–valina ) puntúan positivo mientras que las radicales (triptófano–glicina ) puntúan negativo. Las matrices PAM (Dayhoff, 1978) se dedujeron de proteínas muy próximas y se extrapolaron a distancias mayores por multiplicación de matrices; las matrices BLOSUM (Henikoff y Henikoff, 1992) se contaron directamente en bloques de secuencias alineadas agrupadas a una identidad dada — BLOSUM62 a partir de bloques al — y son las predeterminadas porque se midieron, en lugar de extrapolarse, a la distancia a la que se usan.
Proposición 5.6 (Por qué log-verosimilitudes)
Para que un esquema de puntuación pueda usarse en alineamiento local, la puntuación esperada de una columna emparejada al azar, , ha de ser negativa, y algunas puntuaciones han de ser positivas; de lo contrario los alineamientos aleatorios crecerían sin límite y el segmento de mayor puntuación sería la secuencia entera. Dado eso, todo esquema de esa clase es equivalente a un esquema de log-verosimilitudes para algunas frecuencias objetivo — los alineamientos que encontrará como óptimos son aquellos cuyos pares de residuos se distribuyen como . Elegir la matriz es por tanto elegir la divergencia que se espera detectar: una matriz para parientes próximos (BLOSUM80, PAM30) tiene positivos más marcados y negativos más duros, y una para parientes lejanos (BLOSUM45, PAM250) es más plana.
Demostración. Admitido a este nivel. ∎
Ejemplo 5.7 (Identidad, similitud y la zona crepuscular)
Dos secuencias de proteína aleatorias alineadas de forma óptima con huecos alcanzan por azar entre el de identidad. Por encima del de identidad a lo largo de cien residuos, dos proteínas son casi con seguridad homólogas; entre el y el está la zona crepuscular, donde la identidad por sí sola no decide y debe hacerlo la estadística de más abajo. Los homólogos pueden caer muy por debajo de la zona: las subunidades de la hemoglobina y la mioglobina comparten un de identidad, la lisozima y la -lactalbúmina un , y muchos pares de proteínas con el mismo plegamiento comparten menos del , detectable solo comparando perfiles o estructuras.
5.3 Buscar en una base de datos
Definición 5.8 (BLAST)
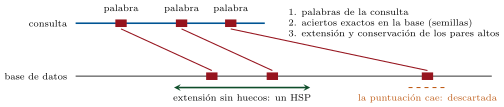
Alinear una consulta de residuos contra una base de datos de por programación dinámica completa costaría actualizaciones de celda por búsqueda. BLAST (Altschul y colaboradores, 1990) cambia un poco de sensibilidad por mil veces más velocidad en tres pasos: (1) se listan las palabras de la consulta (tres residuos para proteínas, once bases para ADN) y sus vecinas de alta puntuación; (2) se rastrea la base de datos en busca de coincidencias exactas de palabra — las semillas; (3) se extiende cada semilla en ambas direcciones sin huecos hasta que la puntuación cae una cantidad fijada por debajo de su máximo, conservando los pares de segmentos de alta puntuación (HSP), y luego se unen los HSP próximos con programación dinámica con huecos en una banda estrecha. Un homólogo verdadero contiene casi siempre al menos una palabra exacta de tres residuos en común; un parecido casual rara vez la tiene, y nunca se extiende.
Teorema 5.9 (La estadística de un acierto por azar)
Para una consulta de longitud buscada en una base de datos de longitud total , con un esquema de puntuación de esperanza negativa, el número de alineamientos locales sin huecos que puntúan al menos y que surgen por azar sigue una Poisson de media
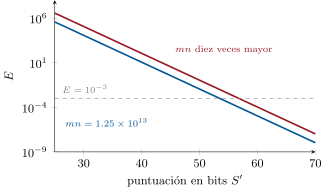
donde y solo dependen del esquema de puntuación y de las frecuencias de residuos ( es la escala de la matriz de log-verosimilitudes). es el valor esperado de la puntuación . Escribiendo la puntuación en bits, , la fórmula queda , y la probabilidad de que al menos un alineamiento por azar alcance es , que vale cuando es pequeño.
Demostración parcial. La cola exponencial es el teorema de Karlin–Altschul y se admite: la puntuación máxima de un segmento en un paseo aleatorio con deriva negativa tiene una distribución cuya cola decae como , con la raíz positiva de — que es exactamente la ecuación que hace coherente la matriz de log-verosimilitudes. Dada esa cola, el resto es contar. Los segmentos de alta puntuación pueden empezar en cualquiera de los pares de posiciones, son raros y son casi independientes; el número de los que superan sigue por tanto una Poisson de media proporcional a y a la probabilidad de la cola, . La probabilidad de que no haya ninguno es . La sustitución por la puntuación en bits es álgebra: . Para los alineamientos con huecos vale la misma forma con y estimados por simulación. ∎
Ejemplo 5.10 (Leer un valor E)
Una consulta de residuos contra una base de datos de residuos tiene . Un acierto con una puntuación en bits de tiene : es homólogo con certeza prácticamente absoluta. Un acierto con tiene : se esperan once puntuaciones así por azar, y el acierto no significa nada. El mismo alineamiento, con la misma puntuación en bits, buscado en una base de datos diez veces mayor, tiene un diez veces mayor — la significación es una propiedad de la búsqueda, no del par. El umbral de uso común es para un homólogo fiable; – merece una segunda mirada con un método de perfil.
5.4 Perfiles, estados ocultos y motivos
Definición 5.11 (Alineamiento múltiple y perfiles)
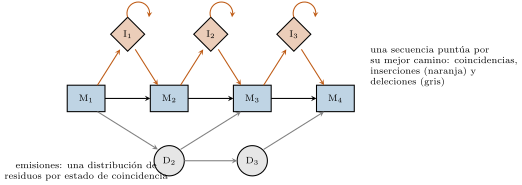
Un alineamiento múltiple de secuencias dispone una familia de secuencias en columnas de residuos homólogos. La programación dinámica exacta sobre secuencias cuesta y es imposible más allá de tres; los programas prácticos alinean de forma progresiva, primero el par más próximo según un árbol guía y luego secuencias y grupos al alineamiento creciente, con rondas de refinamiento. Un alineamiento terminado se resume en un perfil: para cada columna, la frecuencia de cada residuo y de los huecos. Un modelo oculto de Markov de perfil formaliza esto como una cadena de estados de coincidencia, uno por columna conservada, cada uno emitiendo residuos con sus propias probabilidades, con estados de inserción y de deleción que permiten residuos adicionales o ausentes en cada posición; el modelo de una familia (una entrada de Pfam) puntúa una secuencia nueva por la probabilidad del mejor camino a través de los estados, y encuentra homólogos muy por debajo de la zona crepuscular de la comparación por pares, porque una columna que solo tolera residuos hidrófobos lo dice, mientras que una secuencia aislada no puede.
Definición 5.12 (Motivos y contenido de información)
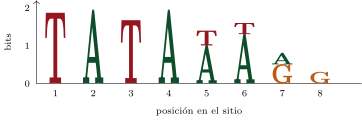
Un motivo es un patrón corto — un sitio de factor de transcripción, una señal de corte, un sitio de fosforilación — representado por una matriz de pesos por posición con la frecuencia de cada base o residuo en cada posición . El contenido de información de la posición es bits para el ADN, donde es su entropía: bits para una base invariante y para una posición en la que las cuatro son igualmente probables. El total se dibuja como un logotipo de secuencia, con cada posición una pila de letras cuya altura total es y cuyas letras se dimensionan por frecuencia.
Proposición 5.13 (Cuánta información necesita un sitio)
Un sitio que debe encontrarse veces en un genoma de posiciones, y en ningún otro sitio, necesita unos bits de contenido de información: el motivo ha de reducir las posiciones candidatas a las verdaderas, y cada bit reduce a la mitad las candidatas. Los motivos observados de los reguladores bacterianos bien estudiados coinciden con esta predicción — los sitios de E. coli de un represor que se une a unas pocas decenas de lugares en un genoma de llevan bits —; los motivos de los factores de transcripción eucariotas, con bits en un genoma de , no pueden especificar sus dianas por sí solos, y de ahí que actúen en combinaciones y en la cromatina abierta del Capítulo 1.
Demostración. Una posición al azar coincide con un motivo de contenido de información con probabilidad cercana a (cada bit de especificidad reduce a la mitad la probabilidad), de modo que el número esperado de coincidencias por azar en posiciones es . Para que los sitios verdaderos destaquen, esto ha de ser del orden de o menos: , es decir, . ∎
Ejemplo 5.14 (Coincidencias esperadas por azar)
Un sitio de restricción de seis bases fijas tiene bits y coincide con una posición al azar con probabilidad : unas veces en un genoma de E. coli de leído en ambas hebras (el sitio es palindrómico, de modo que una vez por posición), y veces en el genoma humano. Un factor eucariota cuyo motivo lleve bits coincide con millones de posiciones del genoma humano, varios miles de veces más que los genes que regula. Un motivo por sí solo es un predictor débil en un genoma grande; lo que permite una predicción son el estado de la cromatina, los motivos vecinos y la conservación del sitio entre especies.
5.5 De la secuencia a la función
Método 5.15 (Anotar una proteína desconocida)
Dada una secuencia codificante nueva: (1) tradúzcase en el marco correcto y búsquense un péptido señal, segmentos transmembranarios y regiones de baja complejidad; (2) búsquese en las bases de datos de proteínas con BLAST y léanse los aciertos con , anotando si el alineamiento cubre toda la proteína (un ortólogo verdadero) o un segmento (un dominio compartido); (3) búsquese en las bases de datos de dominios con HMM de perfil, que encuentran familias que BLAST pierde y reparten la proteína en dominios; (4) infiérase ortología, y no mera similitud, comprobando que el mejor acierto en el otro genoma tiene la consulta como su mejor acierto (mejores aciertos recíprocos) o situando la proteína en un árbol génico (Capítulo 25); (5) transfiérase la función de los ortólogos con cautela — un residuo catalítico conservado apoya que la química se conserve, y uno ausente lo desmiente — y predígase la estructura; (6) trátese toda predicción como una hipótesis para el laboratorio.
Proposición 5.16 (La estructura a partir de la secuencia)
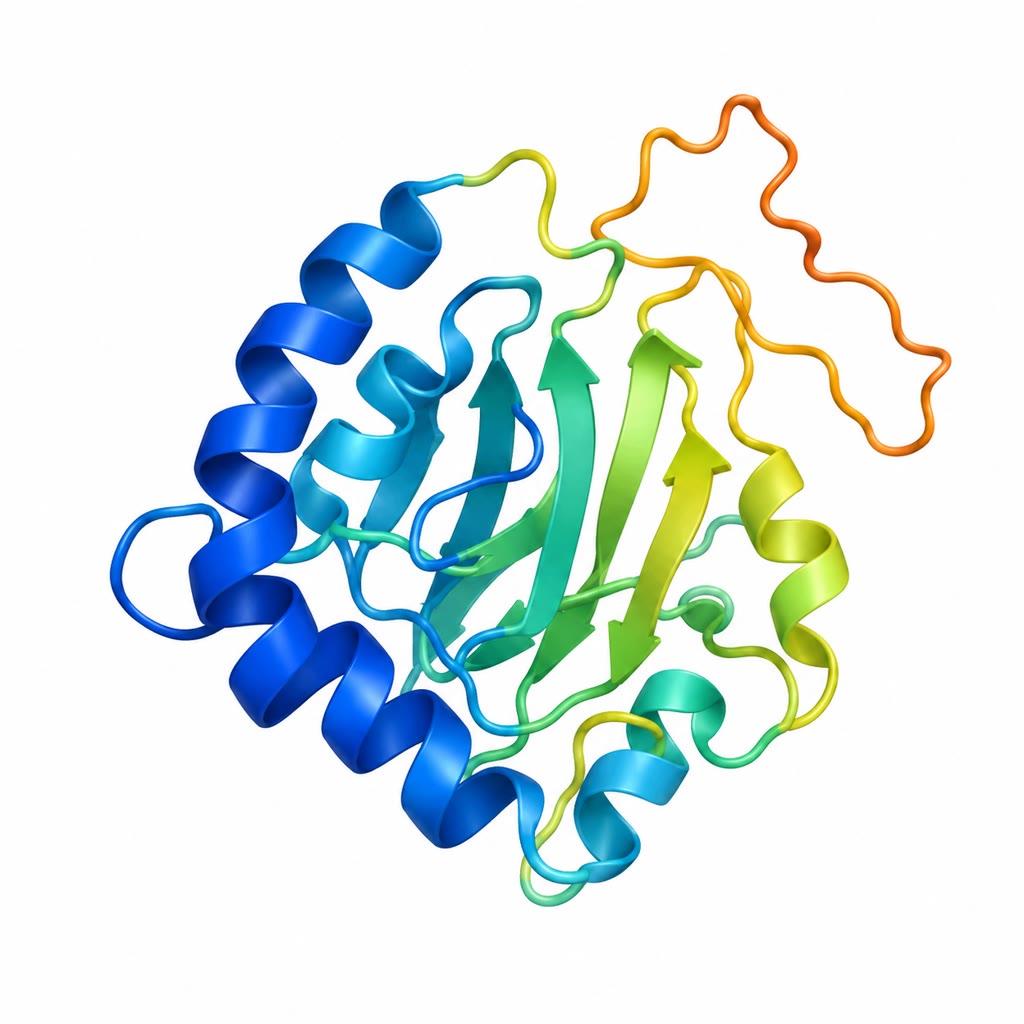
El plegamiento de una proteína lo determina su secuencia (Capítulo 7), y calcularlo a partir de la secuencia fue durante cincuenta años el problema central sin resolver del campo. Tres enfoques lo consiguieron, uno tras otro. El modelado por homología construye la estructura de una proteína sobre la de un homólogo resuelto, de forma fiable por encima del de identidad. El análisis de coevolución aprovecha que dos residuos en contacto en el plegamiento tienden a mutar juntos a lo largo de un alineamiento múltiple profundo, de modo que los pares de columnas acoplados estadísticamente son contactos predichos, y con suficientes contactos queda definido un plegamiento. Los métodos de aprendizaje profundo, entrenados con las cien mil estructuras resueltas y con esos alineamientos, predicen hoy la mayoría de las estructuras de proteínas globulares con una exactitud casi experimental (las evaluaciones CASP de 2020), y las bases de datos guardan una estructura predicha para prácticamente toda secuencia de proteína conocida. Lo que predicen peor es lo que una sola estructura no capta: las regiones desordenadas, las conformaciones alternativas, el efecto de una mutación puntual y los complejos.
Observación 5.17 (Los límites de la inferencia)
La mayoría de las anotaciones funcionales de las bases de datos nunca se pusieron a prueba; se transfirieron de un homólogo, que a su vez había sido anotado por transferencia. Los errores se propagan y se multiplican, y una anotación equivocada en una proteína bien conectada puede infectar a toda una familia. Los remedios son los de más arriba: distíngase la ortología de la homología, léase el alineamiento, búsquense los residuos catalíticos y recuérdese que “proteína hipotética” es una etiqueta honrada que un tercio de los genes de la mayoría de los genomas todavía merece.
5.6 Ejercicios
Ejercicio 5.1 ★
Defínanse el alineamiento global y el local y dese una situación biológica que reclame cada uno.
Solución
Solución de Ejercicio 5.1.
Global: las dos secuencias alineadas de extremo a extremo, con todo residuo en una columna — para dos proteínas que se creen homólogas en toda su longitud, como los ortólogos de una enzima constitutiva. Local: el par de subcadenas de mejor puntuación, ignorando el resto — para encontrar un dominio compartido (un dominio SH2 en dos proteínas de señalización por lo demás no emparentadas), o un gen en una secuencia genómica larga.
Ejercicio 5.2 ★
Rellénese la tabla de Needleman–Wunsch de AGC contra AAC con coincidencia , discrepancia y hueco , y dense el alineamiento óptimo y su puntuación.
Solución
Solución de Ejercicio 5.2.
Bordes en ambos sentidos. Fila A: . Fila G: . Fila C: . Óptimo : AGC sobre AAC sin huecos (coincidencia, discrepancia, coincidencia: ).
Ejercicio 5.3 ★
En BLOSUM62, triptófano–triptófano puntúa y leucina–leucina . Explíquese a partir de la fórmula de log-verosimilitudes por qué la identidad del residuo más raro vale más.
Solución
Solución de Ejercicio 5.3.
. El triptófano es raro (), de modo que la probabilidad de que dos triptófanos se alineen al azar, , es minúscula, y un par de triptófanos conservado es un indicio de homología mucho más fuerte que un par de leucinas conservado (); la razón de log-verosimilitudes es proporcionalmente mayor.
Ejercicio 5.4 ★
¿Qué es un valor E? Una búsqueda devuelve un acierto con . ¿Qué significa ese número, y es homólogo el acierto?
Solución
Solución de Ejercicio 5.4.
El valor E es el número de alineamientos con una puntuación al menos tan alta que cabría esperar por azar en una búsqueda de esta consulta contra una base de datos de este tamaño. significa que se esperan tres puntuaciones así por azar: el acierto no es prueba de homología (puede serlo de todos modos, pero la búsqueda no lo puede decir).
Ejercicio 5.5 ★★
Se busca una consulta de residuos contra residuos. Calcúlense los valores E de los aciertos con puntuaciones en bits , y . ¿Qué puntuación en bits da ? ¿Cómo cambia la respuesta si la consulta mide residuos?
Solución
Solución de Ejercicio 5.5.
. ; ; . exige bits. Una consulta de residuos tiene un diez veces menor, : bastan bits — pero una consulta corta rara vez llega siquiera a eso.
Ejercicio 5.6 ★★
Calcúlese el contenido de información de un motivo cuyas cuatro posiciones tienen frecuencias de bases (A, C, G, T) de , , y . ¿Cuántas coincidencias por azar tiene en un genoma de ?
Solución
Solución de Ejercicio 5.6.
Contenidos de información: , , , y con , o sea . Total bits. Coincidencias por azar: posiciones en dos hebras — el motivo es casi inútil por sí solo.
Ejercicio 5.7 ★★
Explíquese por qué las penalizaciones afines por hueco son más realistas que las lineales, y por qué una penalización de apertura muy alta y una muy baja dan las dos malos alineamientos.
Solución
Solución de Ejercicio 5.7.
Una inserción de varios residuos es un solo suceso mutacional, de modo que su coste no debería crecer linealmente con su longitud: un coste de apertura más un pequeño coste de extensión lo modela. Una penalización de apertura demasiado alta fuerza discrepancias donde corresponde un hueco y desalinea todo lo que sigue a una inserción real; una demasiado baja esparce huecos por todas partes, empareja residuos por azar e infla la identidad.
Ejercicio 5.8 ★★
Una búsqueda BLAST de una proteína humana contra una base de datos de mosca da un mejor acierto con que cubre los residuos 50–180 de la consulta de residuos. ¿Es la proteína de la mosca el ortólogo de la humana? ¿Qué prueba adicional se haría?
Solución
Solución de Ejercicio 5.8.
No necesariamente: el alineamiento cubre un segmento de residuos, que es la firma de un dominio compartido más que la de un ortólogo alineado en toda su longitud. Prueba: búsquese la proteína de la mosca contra el proteoma humano (¿es la consulta su mejor acierto, en toda la longitud?), identifíquese el dominio con un HMM de perfil y constrúyase un árbol génico de la familia en varias especies.
Ejercicio 5.9 ★★
¿Por qué los métodos de perfil detectan homólogos que el alineamiento por pares pierde? Dese un ejemplo de patrón de columna que un perfil capta y una secuencia aislada no.
Solución
Solución de Ejercicio 5.9.
Un perfil registra, columna a columna, lo que la familia tolera: una posición que es siempre hidrófoba pero nunca el mismo residuo, un residuo catalítico invariante, una posición que es siempre un hueco en la mitad de la familia. Un alineamiento por pares puntúa cada residuo contra otro único residuo y no puede saber que una valina en la posición 40 es “tan buena como” la isoleucina que hay ahí en la consulta. El perfil además pondera las columnas conservadas, de modo que una similitud débil concentrada allí donde la familia está conservada se vuelve significativa.
Ejercicio 5.10 ★★★
Muéstrese que, bajo un esquema de puntuación de esperanza positiva, el alineamiento local de Smith–Waterman de dos secuencias aleatorias largas tiene una puntuación que crece linealmente con su longitud, y explíquese por qué esto hace fracasar la teoría del valor E. ¿Qué implica para alinear ADN con coincidencia y discrepancia a un de contenido de GC?
Solución
Solución de Ejercicio 5.10.
Con una puntuación esperada positiva por columna, la puntuación acumulada a lo largo de la diagonal de dos secuencias aleatorias es un paseo aleatorio con deriva positiva: tras columnas vale unos , de modo que el mejor alineamiento local es esencialmente el todo y su puntuación crece como y no como . La teoría de Karlin–Altschul, que exige una deriva negativa para que las puntuaciones altas sean excursiones raras, no se aplica y no existe ningún . Para ADN al de GC la probabilidad de una coincidencia es , de modo que la puntuación esperada es : sigue siendo negativa y la estadística vale; pero un esquema como coincidencia y discrepancia tendría esperanza y daría todo el genoma como un solo alineamiento.
Ejercicio 5.11 ★★★
La tabla de Needleman–Wunsch necesita celdas de memoria; para dos cromosomas de son . Descríbanse dos ideas con las que los alineadores de genomas lo evitan (semillas y encadenamiento; bandas), y a qué renuncia cada una.
Solución
Solución de Ejercicio 5.11.
Semillas y encadenamiento: se buscan coincidencias exactas o casi exactas de -meros entre las dos secuencias con una tabla de dispersión, se conservan las que se alinean en diagonales coherentes, se encadenan y se aplica programación dinámica solo en los huecos entre semillas encadenadas; se renuncia a los alineamientos en regiones sin semilla (tramos muy divergentes). Bandas: si se sabe que las dos secuencias son casi colineales, se calculan solo las celdas de una banda de anchura alrededor de la diagonal, a un coste en lugar de ; se renuncia a cualquier alineamiento con una inserción mayor que la banda.
Ejercicio 5.12 ★★★
Un modelo oculto de Markov de búsqueda de genes para bacterias tiene estados para las tres posiciones del codón y para el ADN no codificante. Explíquese cómo el modelo puede distinguir la secuencia codificante de la no codificante sin información alguna sobre codones de parada (considérese el uso de codones), y por qué el mismo enfoque es mucho más difícil en un genoma humano.
Solución
Solución de Ejercicio 5.12.
La secuencia codificante tiene un período de tres: las tres posiciones del codón tienen composiciones de bases distintas (la tercera es la más sesgada), y el uso de codones es desigual en cada especie. Un modelo con tres estados codificantes en serie, cada uno emitiendo bases con la composición de esa posición del codón, asigna al ADN codificante una probabilidad mayor que el estado no codificante, a lo largo de una ventana de unas pocas decenas de codones, incluso sin paradas. En un genoma humano los exones son cortos () y están separados por intrones de kilobases, de modo que la señal codificante es breve e interrumpida; el modelo debe reconocer además los sitios de corte, que son señales débiles, y la enorme cantidad de secuencia no codificante produce muchos segmentos codificantes falsos.
5.7 Problema: una secuencia del fondo del mar
Problema 5.1
Problema de fin de semana — una proteína desconocida alineada a mano, buscada en las bases de datos con su significación calculada, su motivo regulador pesado en bits y su gen contrastado con la estadística de los marcos de lectura abiertos aleatorios, hasta llegar al valor E del mejor acierto, a los bits que necesita un sitio y a la longitud que ha de tener un marco de lectura para creérselo
Datos: una proteína de residuos de un anélido abisal. Base de datos de proteínas: residuos. Genoma del gusano: , de GC. Puntuación de los alineamientos a mano: coincidencia , discrepancia , hueco . Puntuación en bits del mejor acierto BLAST: ; del décimo acierto: .
Parte I — A mano.
- Alinéense los péptidos KQT y KAQT con la recurrencia de Needleman–Wunsch: escríbase la tabla y dense el alineamiento óptimo y su puntuación.
- Repítase con Smith–Waterman (local) para GATCAT contra ACAT: hállense el mejor alineamiento local y su puntuación.
- ¿Cuántas actualizaciones de celda cuesta un alineamiento global de la proteína de residuos contra una proteína de residuos? ¿Y contra toda la base de datos?
- Si un ordenador ejecuta actualizaciones por segundo, ¿cuánto tarda el alineamiento de la pregunta 3 contra toda la base de datos? ¿Por qué se usa BLAST en su lugar?
- Una puntuación de identidad de BLOSUM62 es para la alanina () y para el triptófano (). Con (unidades de medio bit), calcúlense la frecuencia objetivo y y la razón de cada una. Interprétese.
- Dos proteínas comparten el de identidad a lo largo de residuos. Dígase por qué la identidad por sí sola no puede zanjar aquí la homología y qué sí podría.
Parte II — La búsqueda.
- Calcúlense para la consulta contra la base de datos y .
- Calcúlense el valor E del mejor acierto () y el del décimo acierto ().
- ¿Qué puntuación en bits corresponde a en esta búsqueda? ¿Y a ?
- El mismo mejor acierto se encuentra cuando la base de datos ha crecido hasta residuos. ¿Su valor E?
- El décimo acierto alinea los residuos 200–260 de la consulta con un de identidad a lo largo de residuos. Usando el valor E, dígase si es prueba de homología y qué podría añadir una búsqueda por perfil.
- El mejor acierto es una quinasa humana, alineada a lo largo de los residuos 10–290. Su mejor acierto en el proteoma del gusano es la consulta. ¿Qué establece esta prueba recíproca, y qué no?
Parte III — Un motivo.
- Aguas arriba del gen hay un sitio candidato de factor de transcripción de ocho posiciones con contenidos de información bits. ¿ total?
- ¿Cuántas coincidencias por azar tiene el motivo en el genoma de (ambas hebras, posiciones)?
- El factor regula unos genes. ¿Cuántos bits necesitaría un motivo para especificar sitios por sí solo en este genoma?
- ¿Cuánto del déficit podría aportar un segundo motivo contiguo de bits, si los dos han de aparecer juntos con un espaciado fijo?
- Una posición con frecuencias para (A, C, G, T): calcúlense su entropía y su contenido de información.
- Explíquese, con el argumento de la información, por qué los factores de transcripción bacterianos suelen tener sitios más largos y más conservados que los eucariotas.
Parte IV — El gen mismo.
- En ADN aleatorio de composición de bases uniforme, ¿cuál es la probabilidad de que un codón sea de parada? ¿Cuál es el número esperado de codones antes de que aparezca una parada (una distribución geométrica)?
- El genoma del gusano tiene un de GC. Recalcúlense la probabilidad de que un codón al azar sea de parada (TAA, TAG, TGA) con las frecuencias de bases reales y la longitud esperada del marco de lectura. ¿En qué sentido empuja un contenido de GC bajo a la búsqueda de genes?
- ¿Cuál es la probabilidad de que un marco de lectura abierto al azar tenga al menos codones? ¿Y al menos ?
- En el genoma de , seis marcos en dos hebras dan unos inicios de codón. ¿Cuántos marcos de lectura abiertos al azar de al menos codones se esperan? ¿Y de al menos ?
- Explíquese por qué “marco de lectura abierto de más de codones” es un buscador de genes utilizable en una bacteria pero no en este genoma, y qué usa en su lugar un buscador de genes eucariota.
- El gen del gusano tiene seis exones de de media. Explíquese cómo las lecturas de secuenciación de ARN resuelven la estructura de exones que la secuencia genómica por sí sola deja ambigua.
- Resúmase: el valor E del mejor acierto (pregunta 8), los bits necesarios para especificar sitios (pregunta 15) y el número esperado de marcos de lectura al azar de codones en el genoma (pregunta 22).
Solución
Solución de Problema 5.1.
1. Filas K, Q, T; columnas K, A, Q, T; bordes y . Fila K: ; fila Q: ; fila T: . Óptimo : K-QT sobre KAQT. 2. Mejor puntuación local : CAT contra CAT (residuos 4–6 de GATCAT con 2–4 de ACAT); ATCAT contra A-CAT también puntúa . 3. actualizaciones; contra la base de datos, . 4. s, diez horas por consulta; las semillas de BLAST se saltan casi toda la tabla y responden en segundos. 5. . Alanina: , , razón . Triptófano: , , razón . Un par de triptófanos alineado es veces más frecuente en homólogos que por azar, y un par de alaninas solo cuatro veces; aun así los pares de alaninas son más frecuentes en términos absolutos porque la alanina es frecuente. 6. El cae en la zona crepuscular, donde los alineamientos aleatorios alcanzan el ; lo zanjarían el valor E del alineamiento, unos motivos conservados en las posiciones correctas, una coincidencia con un HMM de perfil de una familia conocida o un plegamiento compartido. 7. ; . 8. ; . 9. con bits; con bits. 10. Diez veces : , aún abrumador. 11. Con , el décimo acierto es lo que produce el azar; un de identidad a lo largo de residuos no es prueba. Una búsqueda por perfil de los residuos 200–260 contra la base de datos de dominios podría mostrar si ese segmento es un dominio conocido, con una estadística de la que carece la comparación por pares. 12. Los mejores aciertos recíprocos en toda la longitud son compatibles con una ortología uno a uno; no la demuestran — una duplicación en un linaje posterior a la separación da dos coortólogos, y la pérdida del ortólogo verdadero puede dejar un parálogo como mejor acierto. La prueba es un árbol génico con varias especies. 13. bits. 14. coincidencias por azar. 15. bits. 16. La coaparición con un espaciado fijo suma los bits: , lo que aporta de los que faltan; unos bits (un factor de en las coincidencias por azar) han de venir de otro sitio — la accesibilidad de la cromatina, más compañeros. 17. bit; bit. 18. Un factor bacteriano ha de encontrar sus pocos sitios en un genoma de sin ayuda de la cromatina: necesita unos bits, y sus sitios son largos y conservados. Un genoma eucariota es mil veces mayor y exige diez bits más, y sin embargo sus factores tienen sitios cortos; consiguen la especificidad por combinación y por la restricción a la cromatina accesible, lo que además hace la regulación más evolucionable, ya que un sitio corto se gana o se pierde con facilidad. 19. ; el número esperado de codones antes de una parada es . 20. , : , ; total , longitud esperada del marco, codones. El ADN rico en AT está lleno de paradas, de modo que los marcos abiertos al azar son más cortos y los largos destacan más. 21. ; . 22. Cada marco abierto maximal termina en una parada, y inicios de codón contienen paradas: unos marcos al azar de al menos codones, y de al menos . 23. Una bacteria de tiene unas paradas y por tanto unos marcos por azar de codones pero casi ninguno de ; sus genes promedian codones y el del ADN es codificante, de modo que un marco abierto largo es casi siempre un gen. En el gusano codifica el del ADN, los exones promedian codones — menos que el umbral del azar — y un millón de marcos al azar de codones los sepultan. Los buscadores de genes eucariotas usan señales de sitios de corte, el sesgo de codones en un modelo oculto de Markov, la homología con proteínas conocidas y, sobre todo, los transcritos secuenciados. 24. Una lectura de un mensajero cortado y empalmado se alinea con el genoma en dos trozos separados por un intrón: la partición marca los dos sitios de corte hasta la base; la cobertura de lecturas delimita los exones y las lecturas emparejadas enlazan exones sucesivos en un solo transcrito, lo que resuelve cuál de varios sitios de corte candidatos se usa. 25. para el mejor acierto; unos bits para especificar sitios en el genoma; y unos marcos de lectura por azar de codones en todo el genoma.