 Coach
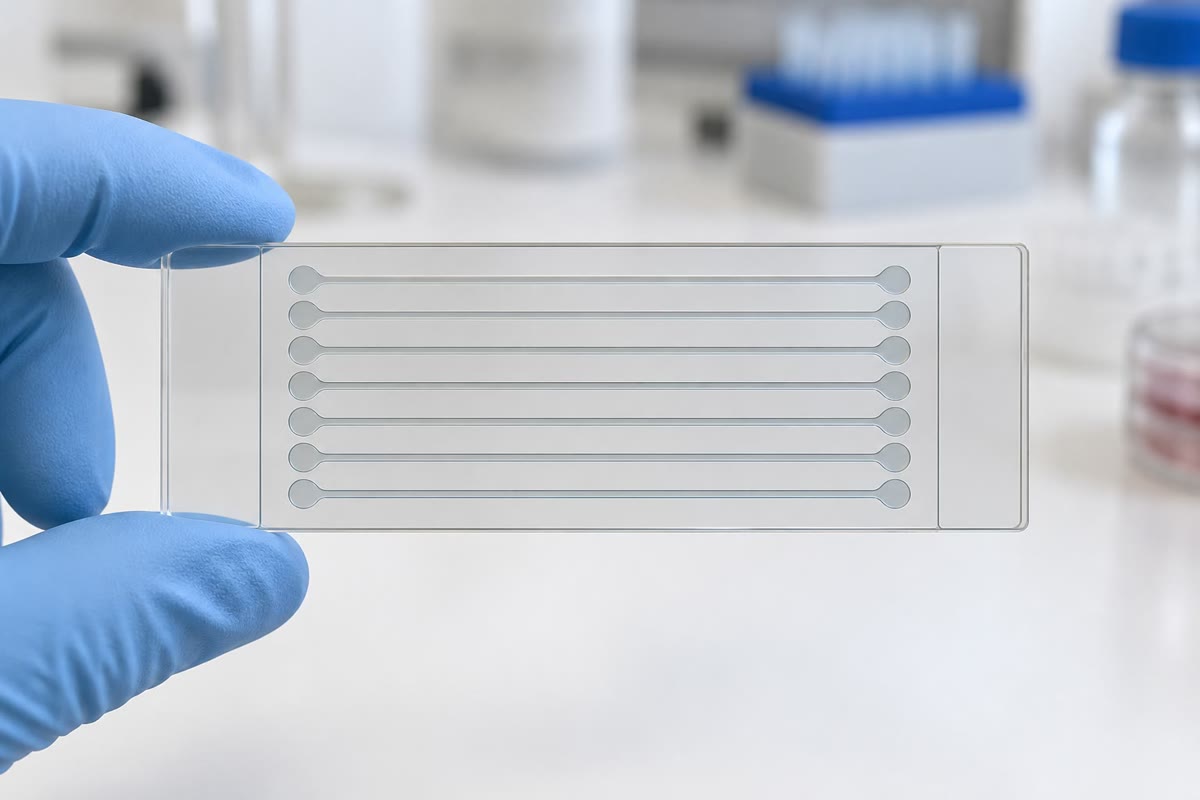
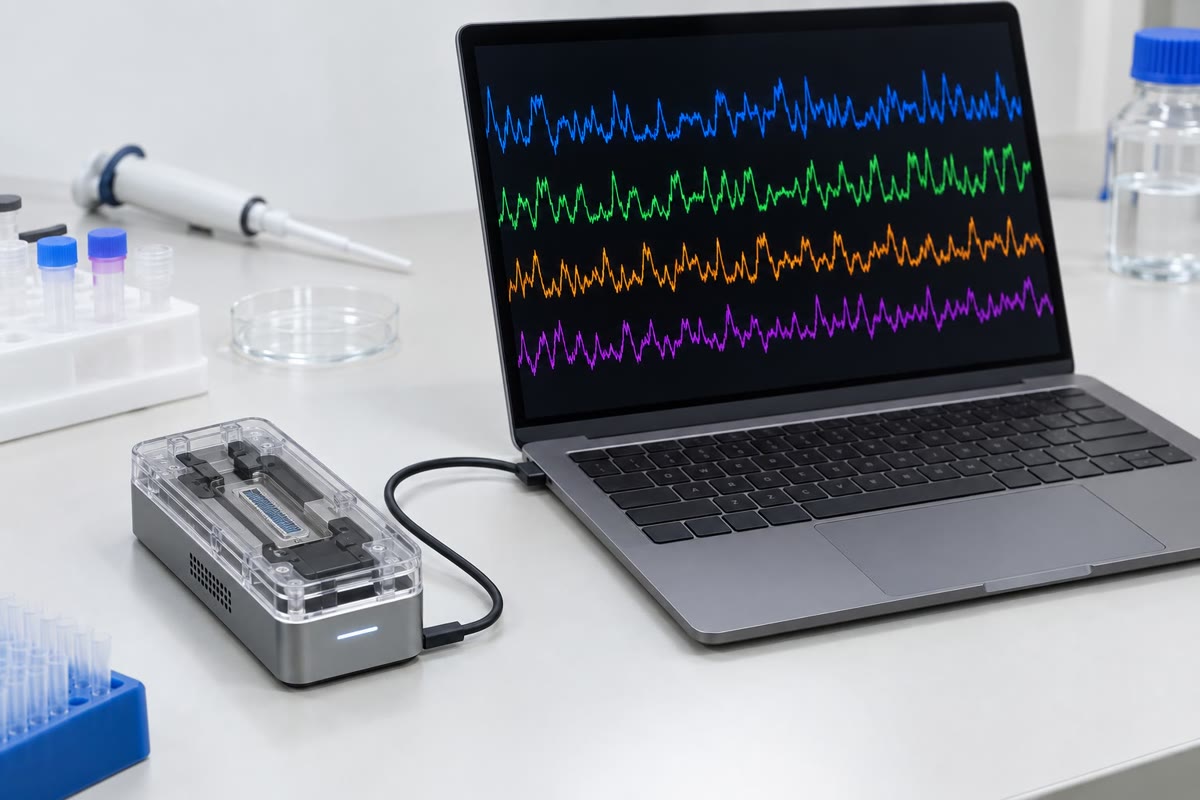
Los instrumentos de segunda generación leen de millones a miles de millones de fragmentos a la vez. En la secuenciación por síntesis los fragmentos, con adaptadores ligados a sus extremos, se fijan a una celda de flujo de vidrio y se amplifican in situ en agrupaciones de moléculas idénticas; las agrupaciones se alargan luego una base por ciclo con nucleótidos fluorescentes y bloqueados de forma reversible, se fotografían, se desbloquean y se vuelven a alargar, de modo que cada ciclo añade una base a la lectura de cada agrupación. Las lecturas son de , casi siempre desde los dos extremos de un fragmento (extremos emparejados), con una tasa de error de unos por base, y una carrera rinde hasta bases. Los instrumentos de tercera generación, de lectura larga, leen moléculas sueltas sin amplificación: observando cómo una polimerasa incorpora nucleótidos fluorescentes en tiempo real, o haciendo pasar el ADN por un nanoporo proteico y registrando la corriente iónica, que cada secuencia de bases modula a su manera. Las lecturas de y más abarcan las repeticiones que las lecturas cortas no pueden, con una tasa bruta de error mayor que el consenso reduce.
Ejemplos
Ejemplo 4.4 (Cuánto basta)
Con la fracción sin secuenciar es — para un genoma de , veinte millones de bases en algunas decenas de miles de huecos. Con es , en total. Los genomas humanos se secuencian de rutina a , no por los huecos de cobertura (), sino porque cada base ha de leerse varias veces en cada uno de los dos cromosomas para llamar con confianza una variante heterocigótica frente a una tasa de error de por lectura. Los genomas bacterianos se secuencian a – por la misma razón y porque es barato. La fórmula muestra además lo que la cobertura no puede arreglar: una repetición más larga que una lectura es un punto donde el grafo de solapamientos se ramifica, y ninguna cantidad de lecturas cortas lo resuelve. Para eso están las lecturas largas.