Biología universitaria — tercer año · Bachelor Year 3
4Genómica y secuenciación
El primer genoma completo de un organismo de vida libre, las de una bacteria, se publicó en 1995 tras un año de trabajo de un equipo de cuarenta personas. El genoma humano, mil millones de pares de bases, le costó a un consorcio internacional trece años y unos tres mil millones de dólares, y se declaró terminado en 2003. Hoy una máquina de sobremesa lee un genoma humano en una noche por unos pocos centenares de dólares, un hospital secuencia el tumor de un paciente para elegir un fármaco y un museo extrae y lee el genoma de un hueso de cuarenta mil años. La tecnología que ha hecho esto posible, la matemática que convierte millones de lecturas cortas en un genoma y lo que los genomas terminados han enseñado sobre el tamaño, el contenido y la historia de nuestro ADN son el asunto de este capítulo. El capítulo siguiente retoma los algoritmos que comparan las secuencias ya obtenidas.
4.1 Leer el ADN
Definición 4.1 (Secuenciación por terminación de cadena)
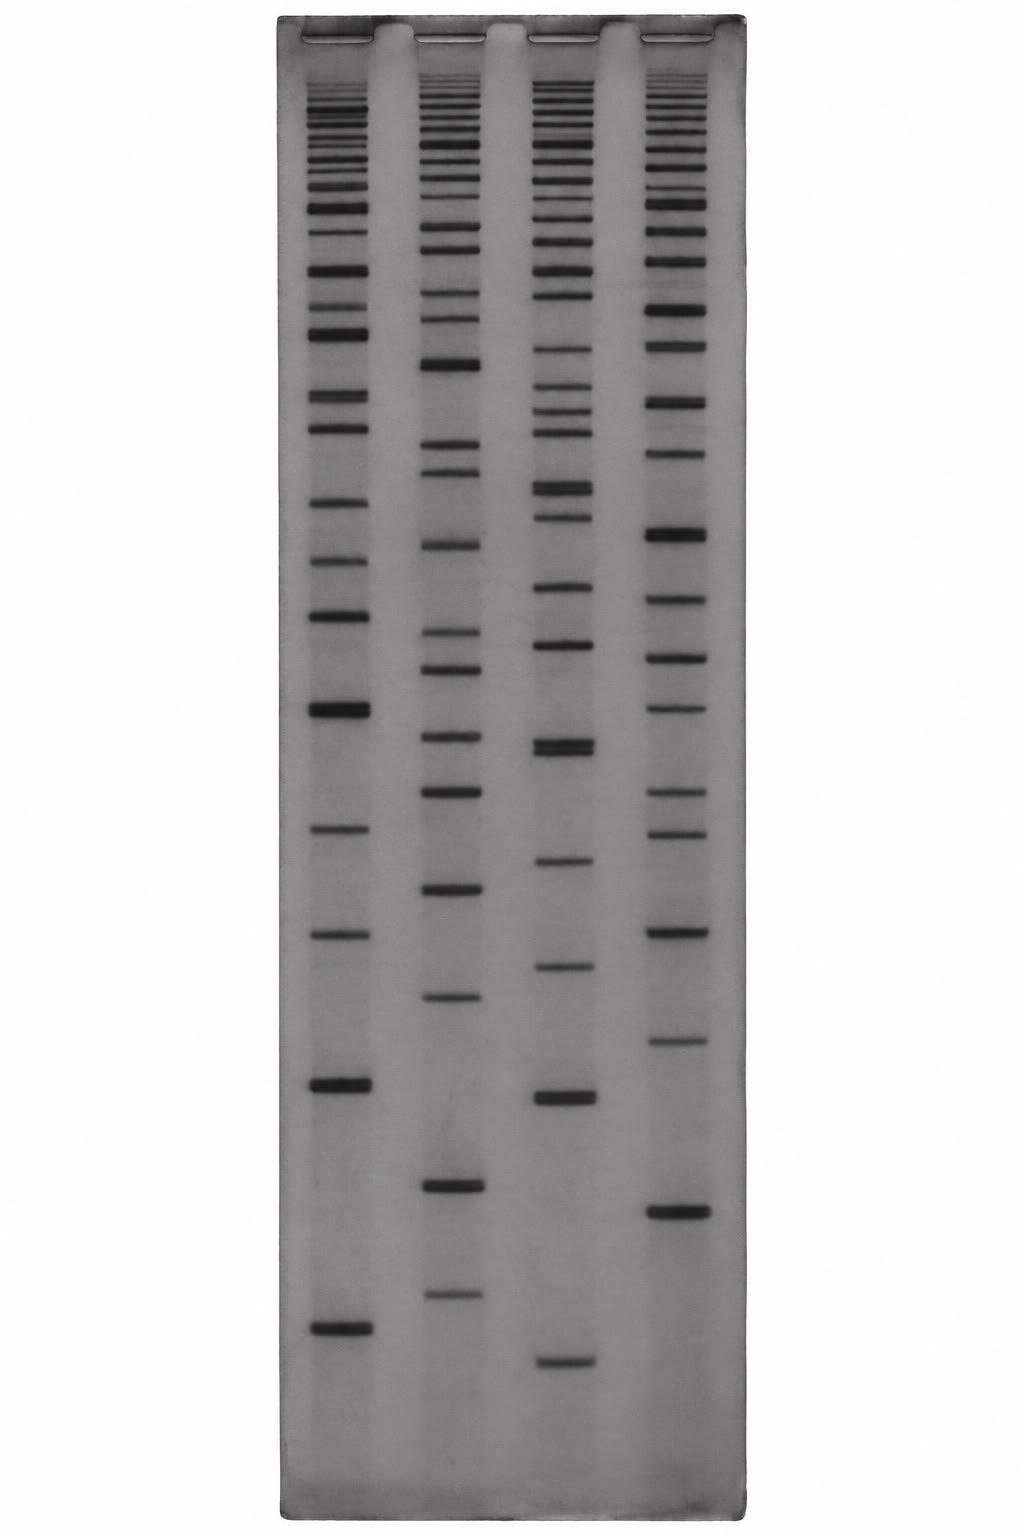
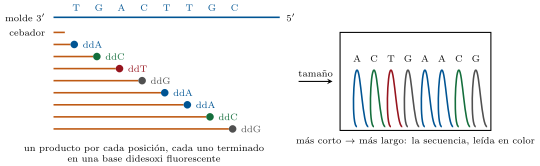
La secuenciación de Sanger copia un molde de hebra sencilla a partir de un cebador con ADN-polimerasa en presencia de los cuatro nucleótidos normales y de una pequeña proporción de didesoxinucleótidos, que carecen del hidroxilo 3 y terminan por tanto la cadena allí donde se incorporan. Cada didesoxinucleótido lleva un fluoróforo distinto. El producto es una mezcla de fragmentos, uno por cada posición del molde, y cada uno acaba en una base de identidad conocida; separados por tamaño en un capilar de gel, pasan por un detector en orden de longitud, y la secuencia de colores es la secuencia del molde. Una carrera lee con una tasa de error por debajo de ; sigue siendo el método para verificar una construcción o un solo gen.
Evidencia. Sanger, Nicklen y Coulson publicaron el método en 1977 y lo usaron ese mismo año para leer los del fago X174 — el primer genoma de ADN completo — y en 1981 los de la mitocondria humana. Fleischmann y colaboradores (1995) leyeron las de Haemophilus influenzae rompiendo todo el genoma en fragmentos al azar, secuenciando de ellos y ensamblando las lecturas por ordenador — la estrategia de escopetazo del genoma completo que todos los proyectos posteriores ampliaron. ∎
Definición 4.2 (Secuenciación masiva en paralelo)
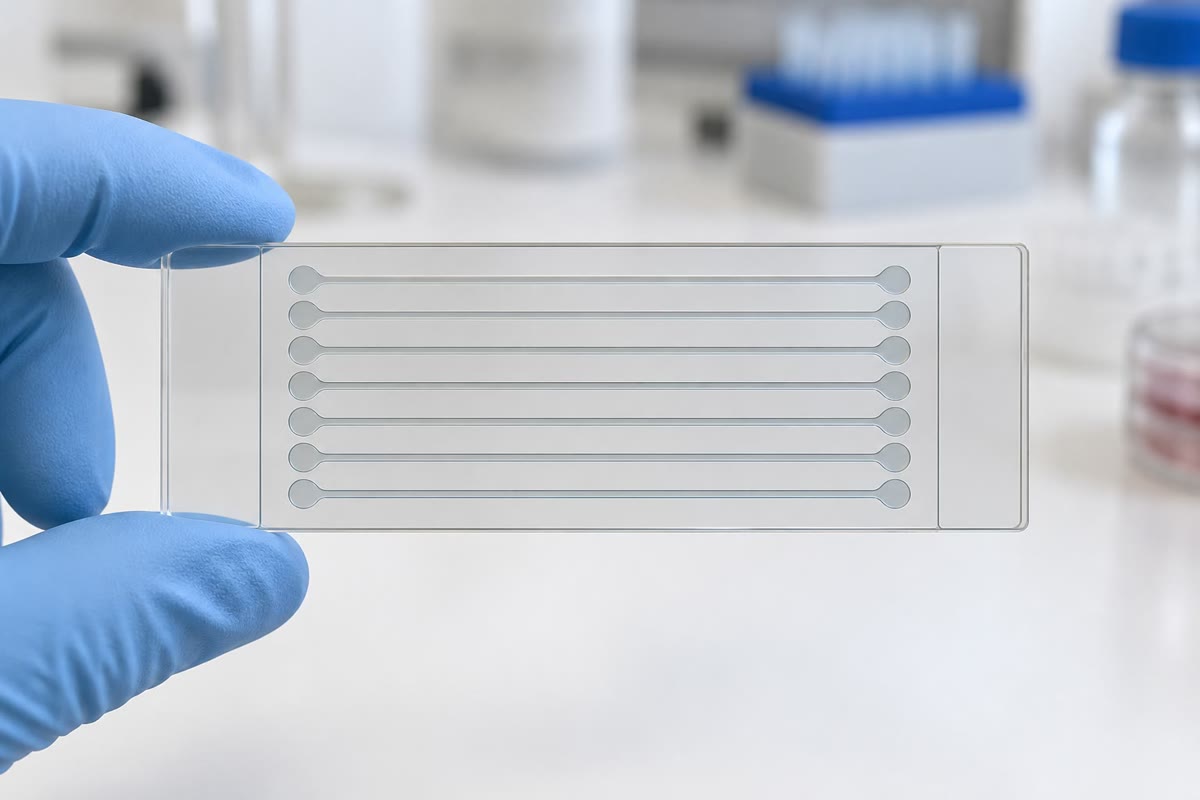
Los instrumentos de segunda generación leen de millones a miles de millones de fragmentos a la vez. En la secuenciación por síntesis los fragmentos, con adaptadores ligados a sus extremos, se fijan a una celda de flujo de vidrio y se amplifican in situ en agrupaciones de moléculas idénticas; las agrupaciones se alargan luego una base por ciclo con nucleótidos fluorescentes y bloqueados de forma reversible, se fotografían, se desbloquean y se vuelven a alargar, de modo que cada ciclo añade una base a la lectura de cada agrupación. Las lecturas son de , casi siempre desde los dos extremos de un fragmento (extremos emparejados), con una tasa de error de unos por base, y una carrera rinde hasta bases. Los instrumentos de tercera generación, de lectura larga, leen moléculas sueltas sin amplificación: observando cómo una polimerasa incorpora nucleótidos fluorescentes en tiempo real, o haciendo pasar el ADN por un nanoporo proteico y registrando la corriente iónica, que cada secuencia de bases modula a su manera. Las lecturas de y más abarcan las repeticiones que las lecturas cortas no pueden, con una tasa bruta de error mayor que el consenso reduce.
Teorema 4.3 (Cobertura y huecos en un proyecto de escopetazo)
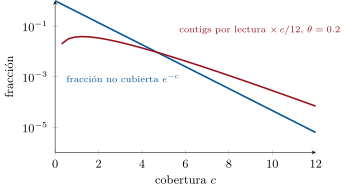
Tómense lecturas de longitud en posiciones aleatorias de un genoma de longitud , y sea la cobertura, el número medio de lecturas que cubren una base. El número de lecturas que cubre una base dada sigue entonces una Poisson de media : la fracción del genoma que queda sin secuenciar es
y si dos lecturas se reconocen como solapadas solo cuando comparten al menos bases, de modo que , el número esperado de contigs (islas de lecturas solapadas) es
y su longitud media es , aproximadamente.
Demostración. Los puntos de inicio de las lecturas caen al azar con densidad por base. Una base la cubren las lecturas que empiezan en las bases anteriores; el número de inicios en una ventana de longitud sigue una Poisson de media , y la probabilidad de que no haya ninguno es . Una lectura es la más a la derecha de su contig si ninguna otra empieza dentro de las bases posteriores a su propio inicio (una lectura que empezara más tarde se solaparía con ella en menos de y no se uniría); esa probabilidad es , y, como cada contig tiene exactamente una lectura más a la derecha, el número esperado de contigs es . La longitud media de un contig se sigue de dividido por el número de contigs, corregido por la fracción no cubierta. ∎
Ejemplo 4.4 (Cuánto basta)
Con la fracción sin secuenciar es — para un genoma de , veinte millones de bases en algunas decenas de miles de huecos. Con es , en total. Los genomas humanos se secuencian de rutina a , no por los huecos de cobertura (), sino porque cada base ha de leerse varias veces en cada uno de los dos cromosomas para llamar con confianza una variante heterocigótica frente a una tasa de error de por lectura. Los genomas bacterianos se secuencian a – por la misma razón y porque es barato. La fórmula muestra además lo que la cobertura no puede arreglar: una repetición más larga que una lectura es un punto donde el grafo de solapamientos se ramifica, y ninguna cantidad de lecturas cortas lo resuelve. Para eso están las lecturas largas.
4.2 De las lecturas a un genoma
Definición 4.5 (Ensamblaje y anotación)
El ensamblaje reconstruye un genoma a partir de sus lecturas por solapamiento: en un grafo de solapamientos cada lectura es un nodo unido a las lecturas con las que se solapa; en un grafo de De Bruijn, usado para miles de millones de lecturas cortas, cada -mero (subsecuencia de longitud ) es un nodo y el genoma es un camino a través de ellos. Las repeticiones más largas que la lectura rompen ambos, porque dan caminos ramificados. Los contigs se ordenan y se orientan en andamios mediante lecturas de extremos emparejados e información de largo alcance (lecturas largas, mapas ópticos, mapas de contacto cromosómico), y los andamios se colocan sobre los cromosomas. La calidad de un ensamblaje se resume en el N50: la longitud de contig tal que la mitad de las bases ensambladas están en contigs al menos así de largos. La anotación busca después los genes: en las bacterias, marcos de lectura abiertos más largos de lo esperable por azar; en los eucariotas, combinando señales de secuencia (sitios de corte, promotores, sesgo de codones), homología con proteínas conocidas y transcritos secuenciados a partir del ARN. El resultado, para una especie, es un genoma de referencia al que se alinea toda lectura posterior de esa especie en lugar de ensamblarla de nuevo.
Método 4.6 (De una muestra a las variantes)
Para un estudio de resecuenciación de un individuo frente a una referencia: (1) extráigase el ADN, fragméntese a y líguense adaptadores (la genoteca); (2) secúnciese a la cobertura necesaria (30 para un genoma humano, 100 para un exoma, que captura el del genoma que codifica proteína); (3) alinéese cada lectura con la referencia, tolerando desajustes; (4) en cada posición cuéntense las bases de las lecturas: una posición en la que alrededor de la mitad de las lecturas discrepan de la referencia es una variante heterocigótica, una en la que discrepan casi todas es homocigótica y una en la que discrepan unas pocas es un error; (5) fíltrese por profundidad, calidad de base y equilibrio de hebras; (6) anótese cada variante con su efecto sobre algún gen (sinónima, de sentido erróneo, sin sentido, de corte, de desplazamiento del marco) y con su frecuencia en las bases de datos poblacionales; (7) para un diagnóstico, consérvense las variantes raras que se predicen dañinas en genes compatibles con el fenotipo, y confírmense por secuenciación de Sanger.
4.3 Qué aspecto tienen los genomas
Proposición 4.7 (Tamaño del genoma y número de genes)
Los tamaños de genoma abarcan un factor de entre los eucariotas — en la levadura, en el gusano, en la mosca, en el ser humano, en una cebolla, en un pez pulmonado, en el lirio Paris japonica —, mientras que los números de genes apenas abarcan un factor de : en la levadura, en el gusano, en la mosca, unos genes codificantes de proteína en el ser humano y en el arroz. Es la paradoja del valor C: el tamaño del genoma no mide la complejidad, ni tampoco el número de genes. Lo que varía es el contenido no codificante — intrones, elementos transponibles, repeticiones satélite —, y el número de proteínas que un genoma puede producir se multiplica mucho más allá de su número de genes por el corte y empalme alternativo (Capítulo 2) y por la regulación, que es donde está escrita sobre todo la complejidad de un organismo. Los genomas bacterianos, en cambio, son compactos y su tamaño sí sigue al número de genes: alrededor de un gen por kilobase, con un codificante en E. coli.
Ejemplo 4.8 (El genoma humano por contenido)
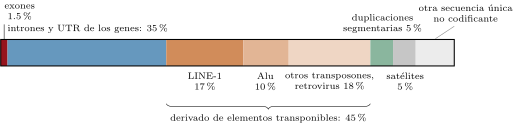
De las : exones codificantes de proteína, ; intrones y regiones no traducidas de los genes, alrededor del ; elementos transponibles y sus fósiles, alrededor del — retrotransposones LINE-1, ; elementos Alu, (más de un millón de copias de una secuencia de ); retrovirus endógenos, ; duplicaciones segmentarias, ; repeticiones simples y satélites, incluidos los centrómeros, alrededor del ; y el resto, secuencia única no codificante, donde viven los elementos reguladores. Unos genes codifican aún maquinaria LINE-1 activa, y se producen inserciones nuevas alrededor de una vez de cada veinte nacimientos. Cerca del del genoma está bajo una selección purificadora detectable — mucho más que los exones — y casi todo ello es regulador.
Definición 4.9 (Genómica comparada)
Los genes de dos especies que descienden de un solo gen de su antepasado común son ortólogos; los genes de una misma especie que descienden de una duplicación son parálogos. Los bloques de cromosoma en los que el orden de los genes se conserva entre especies son sinténicos; la sintenia permite localizar un gen en un genoma a partir de su posición en otro y revela los reordenamientos que separan dos cariotipos (unos entre el ser humano y el ratón). Las secuencias conservadas entre especies lejanas que no codifican proteína — los elementos no codificantes conservados, algunos ultraconservados base a base a lo largo de entre el ser humano y los peces — son en su mayoría potenciadores de genes del desarrollo. Las duplicaciones del genoma completo han marcado la historia de varios linajes: dos rondas en el origen de los vertebrados (los cuatro agrupamientos Hox de los mamíferos frente al único de los invertebrados), una en el antepasado de los salmónidos, otra en el linaje de la levadura y varias en las plantas con flor; los genes duplicados se pierden casi siempre a lo largo de decenas de millones de años, y los supervivientes divergen en función.
Ejemplo 4.10 (Ser humano y chimpancé)
La secuencia de copia única alineada difiere entre el ser humano y el chimpancé en el de las bases — unos millones de sustituciones — y en inserciones y deleciones que juntas suman otro de cada genoma. Dos personas difieren en cerca de una base de cada mil, unos millones de sitios, más unos pocos miles de variantes estructurales; dos chimpancés, cuya población ha sido mayor durante más tiempo, en bastantes más. Un niño lleva unas mutaciones nuevas ausentes en ambos progenitores, cuatro quintas partes de ellas del padre, y el número sube unas dos por año de edad paterna — la aritmética del Capítulo 3 aplicada a las muchas divisiones de la espermatogénesis.
4.4 Genomas y caracteres
Definición 4.11 (Asociación de genoma completo)
Un polimorfismo de un solo nucleótido (SNP) es una posición en la que cada una de dos bases aparece en al menos el de una población; unos diez millones son frecuentes en el ser humano. Un estudio de asociación de genoma completo (GWAS) genotipa centenares de miles de SNP en miles de personas con una enfermedad y miles sin ella, y pregunta en cada SNP si un alelo es más frecuente entre los casos. Como se hace un millón de pruebas, un resultado solo cuenta por debajo de un umbral de significación de unos ( dividido por el millón de pruebas efectivamente independientes). Los SNP asociados señalan una región, no una variante causal, porque los alelos vecinos viajan juntos (desequilibrio de ligamiento) a lo largo de decenas de kilobases. Para la mayoría de las enfermedades comunes, cada alelo asociado desplaza el riesgo un pequeño porcentaje y se sitúa sobre todo en secuencia reguladora; su efecto conjunto, sumado sobre miles de SNP como puntuación poligénica, explica una fracción de la heredabilidad y predice el riesgo más o menos tan bien como los antecedentes familiares.
Observación 4.12 (Lo que la genómica ha dado y lo que no)
La secuenciación ha sido decisiva allí donde un solo gen tiene un efecto grande: varios miles de enfermedades mendelianas tienen ya su gen, y secuenciar el exoma de un niño con un trastorno sin diagnosticar da un diagnóstico en cerca de un tercio de los casos. Los genomas de los tumores revelan qué conductores lleva un tumor y qué fármacos pueden funcionar (Capítulo 11); los genomas de los patógenos rastrean los brotes cepa a cepa (Capítulo 12); y los genomas antiguos han reescrito la prehistoria humana al mostrar que las personas de fuera de África llevan alrededor de un de ADN neandertal. Para las enfermedades comunes — diabetes, cardiopatía, esquizofrenia — la genómica ha dado miles de efectos pequeños y pocos mecanismos, y la promesa de predecir a partir del genoma de una persona sana sigue siendo modesta. El genoma es una lista de piezas; la biología de cómo interactúan no se lee en él.
4.5 Ejercicios
Ejercicio 4.1 ★
Explíquese por qué un didesoxinucleótido termina una cadena de ADN en crecimiento, y por qué una reacción de Sanger debe contener a la vez la forma normal y la didesoxi de cada nucleótido.
Solución
Solución de Ejercicio 4.1.
Un didesoxinucleótido no tiene hidroxilo 3, de modo que no puede formarse ningún enlace fosfodiéster con el nucleótido siguiente y la cadena se detiene. Con solo formas didesoxi toda cadena se detendría en la primera posición; con solo formas normales no se detendría ninguna. La mezcla convierte la terminación en un suceso aleatorio en cada posición, de manera que los productos forman una escalera completa, una longitud por cada base del molde.
Ejercicio 4.2 ★
Una carrera produce lecturas emparejadas de . ¿Qué cobertura da eso de un genoma humano de ? ¿Y de un genoma bacteriano de ?
Solución
Solución de Ejercicio 4.2.
bases. Ser humano: . Bacteria: .
Ejercicio 4.3 ★
Defínanse contig, andamio y N50. Un ensamblaje de tiene diez contigs de y de . ¿Cuál es su N50?
Solución
Solución de Ejercicio 4.3.
Un contig es una secuencia contigua ensamblada a partir de lecturas solapadas; un andamio es un conjunto ordenado y orientado de contigs con huecos de tamaño estimado entre ellos; el N50 es la longitud de contig a la que los contigs ordenados alcanzan la mitad de las bases ensambladas. Aquí los diez contigs de contienen ya , más allá del punto medio de (el séptimo llega a ): N50 .
Ejercicio 4.4 ★
Enúnciese la paradoja del valor C con dos ejemplos, y dígase qué explica sobre todo el ADN sobrante de los genomas grandes.
Solución
Solución de Ejercicio 4.4.
El tamaño del genoma no sigue a la complejidad del organismo: una cebolla tiene cinco veces el ADN de una persona y un pez pulmonado cuarenta veces; la levadura y el gusano difieren diez veces en ADN con números de genes parecidos. El exceso es no codificante: elementos transponibles y sus restos, intrones y repeticiones satélite.
Ejercicio 4.5 ★★
Con el Teorema 4.3, hállense la cobertura necesaria para dejar como mucho una base de cada millón sin secuenciar y el número esperado de contigs de un genoma de leído a con lecturas de y un solapamiento mínimo de .
Ejercicio 4.6 ★★
Una variante heterocigótica está cubierta por lecturas. Suponiendo que cada lectura muestra uno u otro alelo con probabilidad , ¿cuál es la probabilidad de que menos de lecturas muestren el alelo variante (de modo que pudiera confundirse con errores)? Úsese una aproximación normal de media y desviación típica . ¿Por qué es el estándar?
Solución
Solución de Ejercicio 4.6.
. A los dos alelos de un heterocigoto se ven casi siempre muchas veces, la cobertura es desigual (las regiones ricas en GC reciben menos lecturas, de modo que algunos sitios ven la mitad de la media) y quedan lecturas suficientes para separar un alelo real de los errores de .
Ejercicio 4.7 ★★
Un genoma tiene una repetición de presente en copias. Explíquese por qué un ensamblaje a partir de lecturas de la colapsa, qué aspecto tiene el grafo resultante y qué longitud de lectura la resolvería.
Solución
Solución de Ejercicio 4.7.
Toda lectura de del interior de la repetición es idéntica venga de la copia que venga, de modo que el ensamblador construye un solo nodo de con caminos de entrada y de salida; no puede saber qué entrada se empareja con qué salida, y el ensamblaje se rompe en huecos, con la repetición presente una sola vez y con una cobertura veces la media. Las lecturas más largas que la repetición más los flancos únicos de ambos lados — o más — abarcan cada copia y la resuelven.
Ejercicio 4.8 ★★
Dos personas difieren en una base de cada mil. ¿Cuántas diferencias hay en sus exomas ( de secuencia codificante)? Si dos tercios de las diferencias codificantes son sinónimas o benignas y el resto alteran una proteína, ¿cuántas variantes que alteran proteína lleva una persona respecto a otra?
Solución
Solución de Ejercicio 4.8.
diferencias codificantes; un tercio, unas , alteran la proteína.
Ejercicio 4.9 ★★
Un GWAS prueba SNP con umbral . ¿Cuántos falsos positivos se esperan si ningún SNP está realmente asociado? Un alelo de un SNP sube el riesgo de una enfermedad de frecuencia hasta el . Explíquese por qué un efecto así es indetectable en un estudio de mil personas e inútil para un individuo, y sin embargo puede señalar un mecanismo.
Solución
Solución de Ejercicio 4.9.
Falsos positivos esperados, . Un riesgo relativo de sobre una enfermedad del cambia unos pocos casos por millar; mil personas contienen unos veinte casos, demasiado pocos para verlo (la potencia crece con el número de casos y con el cuadrado del efecto). Para un individuo, puntos porcentuales no significan nada. Pero el alelo señala un gen cuyo cambio modesto de actividad altera el riesgo de enfermedad — el gen, y su vía, pueden ser una diana farmacológica cuya inhibición completa tenga un efecto grande.
Ejercicio 4.10 ★★★
Los genomas bacterianos son codificantes en un ; el genoma humano, en un . Dense tres hipótesis — de genética de poblaciones, estructural y reguladora — para la diferencia, y para cada una una observación genómica que la apoye o la debilite.
Solución
Solución de Ejercicio 4.10.
De genética de poblaciones: en las bacterias, con poblaciones enormes, la selección elimina incluso las inserciones ligeramente costosas; en los mamíferos, con poblaciones efectivas pequeñas, la deriva deja que se acumule ADN no codificante levemente deletéreo — lo apoya la correlación inversa entre tamaño del genoma y tamaño de población entre linajes, y lo debilitan las excepciones. Estructural: los genomas eucariotas los invaden transposones que las bacterias, con su sesgo hacia la deleción y sin refugio meiótico para los elementos egoístas, depuran — lo apoya la correlación entre el tamaño del genoma y el contenido de transposones. Reguladora: un desarrollo complejo necesita más ADN regulador — lo apoyan los elementos no codificantes conservados alrededor de los genes del desarrollo, y lo debilita el hecho de que solo el del genoma humano muestre selección alguna, de modo que la mayor parte del ADN no codificante no es regulador.
Ejercicio 4.11 ★★★
Dedúzcase el recuento de contigs de Lander–Waterman para una mezcla de lecturas de dos longitudes: lecturas cortas de longitud y lecturas largas de longitud , con los solapamientos contados con el mismo mínimo . (Trátese cada lectura como la más a la derecha de su contig si ninguna lectura de cualquier tipo empieza dentro de su propia longitud menos .) Muéstrese que unas pocas lecturas largas reducen el recuento de contigs más que el mismo número de bases en lecturas cortas.
Solución
Solución de Ejercicio 4.11.
Los inicios de ambos tipos caen con densidad total . Una lectura de longitud es la más a la derecha de su contig si ninguna lectura de cualquier tipo empieza en las bases que la siguen: probabilidad . De ahí que los contigs sean . Una lectura larga es la más a la derecha con una probabilidad exponencialmente menor que una corta, y cada lectura larga elimina además la posibilidad de un hueco a lo largo de toda su longitud; el mismo número de bases en lecturas cortas añade muchos puntos de inicio, pero cada ventana protegida es corta, de modo que las lecturas largas ganan.
Ejercicio 4.12 ★★★
Se sostiene que los cuatro agrupamientos Hox de los mamíferos descienden de uno solo por dos rondas de duplicación del genoma completo en la base de los vertebrados. Dígase qué patrón de parálogos a lo largo del genoma, y qué patrón en los genomas de las lampreas y de los cordados invertebrados, predice esa hipótesis, y cómo se la distinguiría de dos duplicaciones independientes del agrupamiento solo.
Solución
Solución de Ejercicio 4.12.
Dos duplicaciones del genoma completo predicen que el patrón cuádruple sea de todo el genoma: cuartetos de segmentos cromosómicos parálogos (paralogones) que llevan las mismas familias génicas en el mismo orden, con las duplicaciones fechadas en el mismo momento para todas las familias; un solo agrupamiento en el anfioxo y en Ciona, que divergieron antes de los sucesos; y en las lampreas, que divergieron alrededor de ellos, un estado intermedio o derivado de forma independiente. Las duplicaciones independientes solo del agrupamiento Hox predicen paralogones únicamente para Hox, vecinos con historias distintas y fechas de duplicación diferentes entre familias. Los paralogones de todo el genoma y la datación compartida, tal como se observan, favorecen la duplicación del genoma completo.
4.6 Problema: dos genomas en una máquina
Problema 4.1
Problema de fin de semana — una bacteria y un ser humano secuenciados en la misma carrera: las lecturas repartidas, la cobertura y los huecos calculados, los contigs contados, las variantes heterocigóticas llamadas frente a la tasa de error, el contenido del genoma humano pesado y un estudio de asociación dimensionado, hasta llegar al recuento de contigs a baja cobertura, a la cobertura que hace segura una llamada de variante y al número de mutaciones nuevas de un niño
Datos: una carrera rinde lecturas de . Un genoma bacteriano mide ; el genoma humano, (haploide). Solapamiento mínimo . Tasa de error por base y lectura. Secuencia codificante humana, ; el genoma deriva en un de transposones, con millones de copias Alu de . Dos personas difieren en un sitio de cada . Tasa de mutación, por base y generación.
Parte I — La bacteria.
- A la bacteria se le da el de la carrera. ¿Cuántas lecturas, y qué cobertura?
- ¿Qué fracción de su genoma queda sin secuenciar? ¿Cuántas bases son?
- Calcúlense y el número esperado de contigs.
- Un ensayo previo usó solo lecturas. ¿Cobertura, fracción no cubierta y número de contigs?
- El genoma contiene copias de un operón de ARNr de . Explíquese qué les ocurre en el ensamblaje y cuántos extremos de contig produce esto por sí solo.
- La bacteria tiene alrededor de un gen por kilobase. ¿Cuántos genes y, si el del genoma es codificante, cuál es la longitud media de un gen?
Parte II — El ser humano.
- El resto de la carrera va a un genoma humano. ¿Cobertura del genoma diploide por copia haploide (es decir, bases totales divididas por )?
- En un sitio heterocigótico cada uno de los dos alelos queda cubierto por alrededor de la mitad de las lecturas. Con la cobertura de la pregunta 7, ¿cuál es el número esperado de lecturas que muestran cada alelo?
- Un error muestra una base equivocada en una lectura con probabilidad . En un sitio homocigótico cubierto por lecturas, ¿cuál es el número esperado de lecturas que muestran una base equivocada concreta ( cada una)? ¿Por qué una regla del tipo “llámese variante si al menos lecturas y al menos el de las lecturas la muestran” rechaza los errores a esta cobertura?
- ¿Cuántos sitios heterocigóticos lleva una persona (la mitad de las diferencias entre dos genomas al azar están en cada uno, aproximadamente: tómese un sitio de cada )? ¿Cuántos en secuencia codificante?
- Las lecturas se alinean con una referencia. Explíquese por qué las lecturas procedentes de elementos Alu se alinean a menudo con la copia equivocada y qué consecuencia tiene esto para la llamada de variantes dentro de ellas.
- Se secuencia a un niño junto con sus dos progenitores. ¿Cuántas mutaciones nuevas cabe esperar? ¿Cuántas lecturas del niño, a esta cobertura, deben mostrar una variante ausente en ambos progenitores para creérsela, y por qué la cobertura de los progenitores es tan importante como la del niño?
- Un laboratorio clínico captura el exoma () y lo secuencia a . ¿Cuántas lecturas hacen falta, y por qué resulta más barato por paciente que un genoma a aunque su cobertura sea mayor?
Parte III — El contenido de un genoma.
- ¿Qué fracción del genoma humano es Alu, y qué fracción de las lecturas de la pregunta 7 procede de elementos Alu?
- La referencia mide , pero una célula diploide contiene ; y una cebolla de tiene unos genes. ¿Cuál es la fracción codificante del genoma de la cebolla, si sus genes promedian de secuencia codificante?
- El ser humano y el chimpancé difieren en el de las bases alineadas. ¿Cuántas sustituciones son en de secuencia alineable? Repartidas por igual entre los dos linajes a lo largo de millones de años, ¿qué tasa de mutación por base y año implica esto, y por generación de años? Compárese con la medida directa dada en los datos.
- Dos duplicaciones del genoma de los vertebrados deberían dar hasta cuatro copias de cada gen ancestral. El ser humano tiene unos genes y el cordado invertebrado Ciona, unos . ¿Qué fracción de los duplicados se ha perdido, bajo la hipótesis de que el antepasado tenía ?
- Explíquese por qué el número de genes es una mala medida de la complejidad de un organismo, usando como argumento el recuento de cortes y empalmes alternativos del Capítulo 2.
- El del genoma está bajo selección purificadora pero solo el codifica proteína. ¿Qué es probablemente el resto, y cómo se pondría a prueba un elemento candidato?
Parte IV — Un estudio de asociación.
- Se prueban SNP. Enúnciese el umbral de Bonferroni para un error por familia de , y el número esperado de falsos positivos con .
- Una enfermedad tiene una prevalencia del . Un alelo de riesgo de frecuencia eleva la razón de posibilidades un . Calcúlese el riesgo de enfermedad de un portador de dos copias, de una copia y de ninguna, tomando el riesgo del no portador como . (Multiplíquense las razones de posibilidades.)
- Se encuentran doscientos alelos de este tipo. Explíquese qué es una puntuación poligénica y por qué la puntuación de una persona del superior puede corresponder a un riesgo varias veces mayor aunque cada alelo no haga casi nada.
- Explíquese por qué un SNP que alcanza significación no suele ser la variante causal, y qué experimento identificaría la causal en la región.
- Se secuencia a un genoma antiguo de un hueso de años. ¿Qué fracción de él se lee? ¿Por qué puede responder de todos modos a preguntas sobre la historia de las poblaciones que un genoma moderno por sí solo no puede?
- Resúmase: el número de contigs del ensamblaje de ensayo (pregunta 4), la cobertura por genoma haploide que da unas lecturas por alelo (preguntas 7–8) y el número de mutaciones nuevas de un niño (pregunta 12).
Solución
Solución de Problema 4.1.
1. lecturas; . 2. : en la práctica no queda ninguna base sin cubrir. 3. ; contigs : un solo contig en teoría, con huecos solo en las repeticiones. 4. ; sin cubrir, , unas ; contigs . 5. Los siete operones dan lecturas idénticas y colapsan en un solo contig de , al que entran siete flancos izquierdos únicos y del que salen siete flancos derechos cuyo emparejamiento se desconoce: extremos de contig y siete huecos. 6. Unos genes; codificantes, bp, con un gen medio de . 7. . 8. Unas lecturas por alelo. 9. lecturas que muestran una base equivocada dada — la probabilidad de tres o más es de unos — y el de son lecturas; un error no pasa ninguna de las dos pruebas, mientras que de un alelo heterocigótico real se esperan . 10. sitios heterocigóticos; en secuencia codificante, . 11. Una lectura de de un Alu casa casi igual de bien con muchas de los millones de copias, de modo que se coloca en la copia equivocada o se le da poca confianza de mapeo. Las diferencias entre copias parecen entonces variantes heterocigóticas, y las variantes verdaderas quedan escondidas entre ellas: las llamadas de variantes dentro de los Alu suelen filtrarse, y esos elementos son puntos ciegos de la secuenciación de lectura corta. 12. mutaciones nuevas. Unas lecturas deberían mostrar la variante en el niño; pero si el sitio de un progenitor solo está cubierto por cinco lecturas, un alelo heterocigótico se pierde con probabilidad y una variante heredada se llama por error como nueva — de ahí que los progenitores deban secuenciarse tan a fondo como el niño. 13. lecturas, veinte veces menos que el genoma: el coste de secuenciación cae veinte veces, más de lo que cuesta el paso de captura. 14. bp, cerca del del genoma; el de las lecturas, unos . 15. bp; . 16. sustituciones, por linaje; tasa por base y año, por generación de 25 años — unas dos veces la tasa de pedigrí de , una discrepancia conocida que sugiere generaciones más largas en el pasado o una separación más antigua. 17. Cuatro copias de serían ; quedan , de modo que de las copias adicionales solo sobreviven : se perdió el de los duplicados. 18. El gusano y el ser humano tienen el mismo número de genes; la complejidad está en cómo se usan — el corte y empalme alternativo multiplica un gen en miles de proteínas ( para Dscam), la regulación combina factores de transcripción y potenciadores de maneras propias de cada tipo celular, los ARN no codificantes añaden capas y las proteínas interactúan en redes. 19. Elementos reguladores (potenciadores, promotores, aislantes), genes de ARN no codificante, señales de corte y de localización, orígenes y secuencias estructurales. Un potenciador candidato se pone a prueba colocándolo delante de un gen indicador en un embrión transgénico y mirando dónde se expresa el indicador, y después suprimiendo el elemento del genoma con CRISPR y midiendo los genes vecinos. 20. ; con , falsos positivos esperados. 21. No portador: de posibilidades; con una copia, , riesgo ; con dos copias, , riesgo . 22. La puntuación suma, sobre los alelos, el número de copias de riesgo que lleva una persona ponderado por el logaritmo de la razón de posibilidades de cada alelo. El recuento tiene media y desviación típica ; el superior lleva unos alelos más que la media, y : casi el triple de posibilidades que una persona media, a partir de alelos que individualmente cambian el riesgo un . 23. Los alelos de un bloque de decenas de kilobases se heredan juntos (desequilibrio de ligamiento), de modo que cualquiera de ellos muestra la misma asociación; el SNP genotipado es simplemente el que estaba en la matriz. Para encontrar la variante causal: secuénciese la región en casos y controles, redúzcase el conjunto por estadística y pruébese después cada candidata — ensayos con gen indicador para la actividad potenciadora de cada alelo, edición de cada alelo en células y medida de la expresión de los genes vecinos, colocalización con señales de rasgos cuantitativos de expresión. 24. Se lee el del genoma. Da una muestra directa de una población en un momento conocido del pasado — frecuencias alélicas anteriores a migraciones y mestizajes posteriores, la longitud de los segmentos neandertales (largos, porque pocas generaciones de recombinación los habían roto) y con ello una fecha para el mestizaje —, cosa que los genomas modernos solo pueden inferir a través de modelos. 25. Unos contigs en el ensamblaje de ensayo; por genoma haploide, unas lecturas por alelo; y unas mutaciones nuevas en un niño.