 Coach
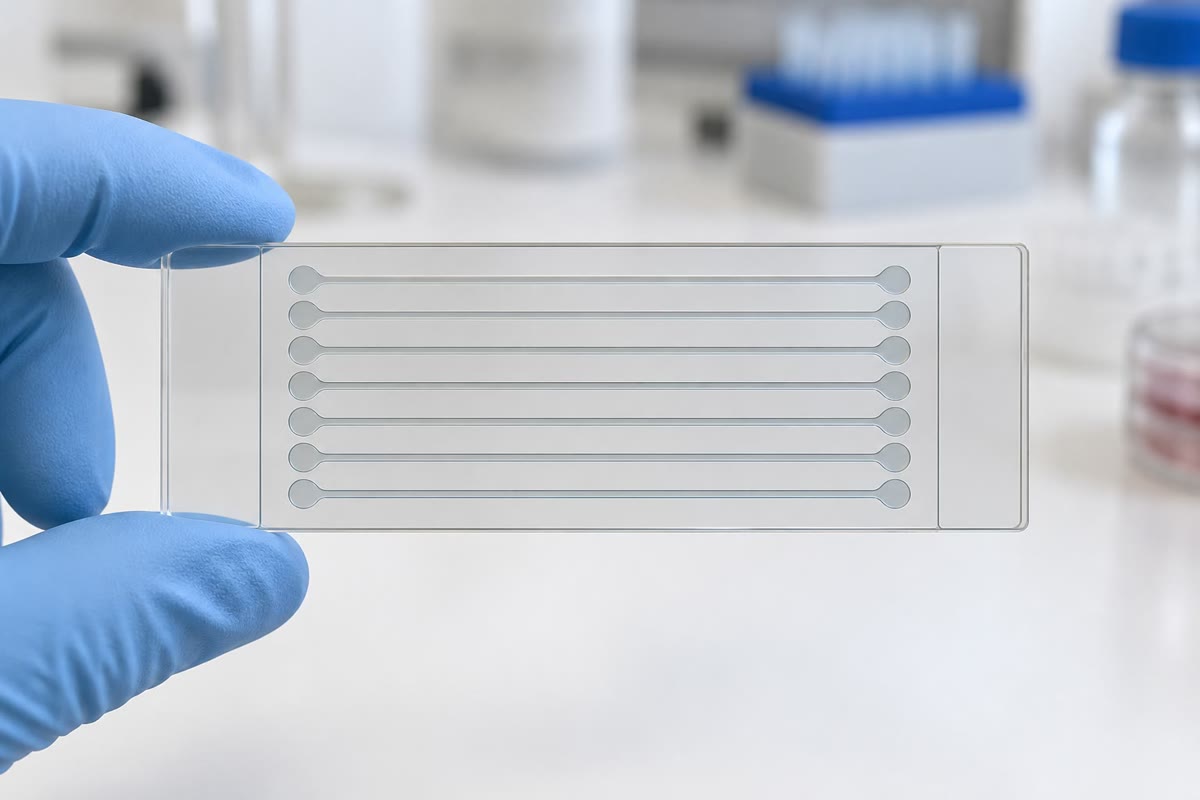
Instrumenten van de tweede generatie lezen miljoenen tot miljarden fragmenten tegelijk. Bij sequencing door synthese worden de fragmenten, met adapters aan hun uiteinden geligeerd, aan een glazen stroomcel gebonden en daar ter plaatse vermenigvuldigd tot clusters van identieke moleculen; die clusters worden vervolgens per cyclus met één base verlengd met fluorescerende, omkeerbaar geblokkeerde nucleotiden, afgebeeld, gedeblokkeerd en opnieuw verlengd, zodat elke cyclus één base toevoegt aan de read van elk cluster. De reads zijn lang, meestal vanaf beide uiteinden van een fragment (gepaarde uiteinden), met een foutenpercentage van ongeveer per base, en één run levert tot basen op. Instrumenten van de derde generatie met lange reads lezen afzonderlijke moleculen zonder vermenigvuldiging: door één polymerase in reële tijd fluorescerende nucleotiden te zien inbouwen, of door het DNA door een eiwit-nanoporie te rijgen en de ionenstroom te registreren, die elke opeenvolging van basen op haar eigen manier moduleert. Reads van en meer overspannen de herhalingen waar korte reads niet overheen komen, tegen een hoger ruw foutenpercentage dat de consensus terugbrengt.
Voorbeelden
Voorbeeld 4.4 (Hoeveel genoeg is)
Bij is het ongesequencede deel — voor een genoom van twintig miljoen basen in enkele tienduizenden gaten. Bij is het , in totaal . Menselijke genomen worden standaard bij gesequenced, niet vanwege dekkingsgaten () maar omdat elke base op elk van de twee chromosomen meermalen moet worden gelezen om een heterozygote variant met vertrouwen vast te stellen tegen een foutenpercentage van per read. Bacteriële genomen worden bij – gesequenced om dezelfde reden en omdat het goedkoop is. De formule laat ook zien wat dekking niet kan oplossen: een herhaling die langer is dan een read is een plaats waar de overlapgraaf zich vertakt, en geen enkele hoeveelheid korte reads lost dat op. Daar zijn lange reads voor.