 Coach
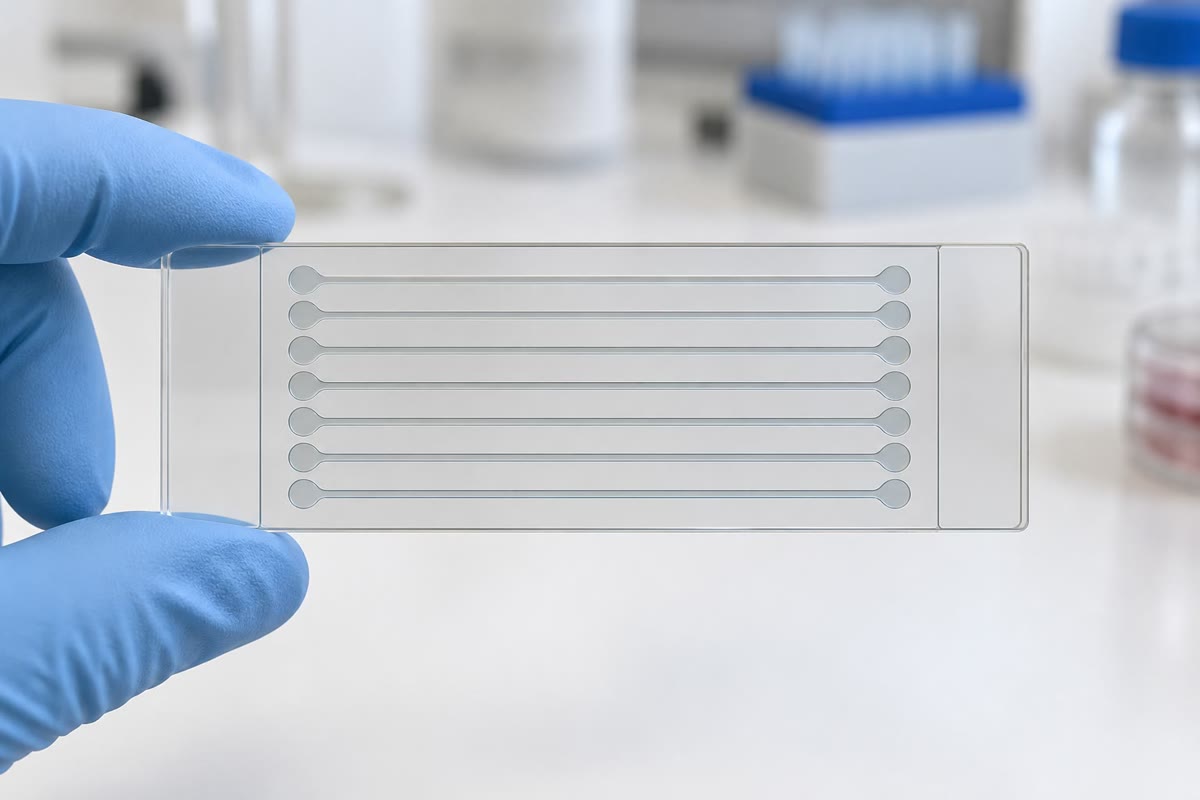
दूसरी पीढ़ी के यंत्र एक साथ लाखों से अरबों खंड पढ़ते हैं। संश्लेषण से अनुक्रमण में खंड, जिनके सिरों पर अनुकूलक जुड़े होते हैं, किसी काँच के प्रवाह-कोष्ठ से बाँधे जाते हैं और वहीं एक जैसे अणुओं के गुच्छों में प्रवर्धित किए जाते हैं; फिर गुच्छों को प्रतिदीप्त, उत्क्रमणीय रूप से अवरुद्ध न्यूक्लियोटाइडों से प्रति चक्र एक क्षार बढ़ाया जाता है, चित्रित किया जाता है, अवरोध हटाया जाता है और फिर बढ़ाया जाता है, ताकि हर चक्र हर गुच्छे के वाचन में एक क्षार जोड़े। वाचन के होते हैं, प्रायः किसी खंड के दोनों सिरों से (युग्मित सिरे), प्रति क्षार लगभग त्रुटि-दर के साथ, और एक बारी तक क्षार देती है। तीसरी पीढ़ी के दीर्घ-वाचन यंत्र अकेले अणु बिना प्रवर्धन के पढ़ते हैं: या तो किसी एक पॉलीमरेज़ को वास्तविक समय में प्रतिदीप्त न्यूक्लियोटाइड बैठाते देखकर, या DNA को किसी प्रोटीन नैनोछिद्र में से पिरोकर और उस आयनी धारा को अंकित करके जिसे क्षारों का हर अनुक्रम अपने ही ढंग से मॉडुलित करता है। और उससे बड़े वाचन उन पुनरावृत्तियों को पाट देते हैं जो छोटे वाचन नहीं पाट सकते, ऊँची कच्ची त्रुटि-दर पर, जिसे सर्वसम्मति घटा देती है।
उदाहरण
उदाहरण 4.4 (कितना पर्याप्त है)
पर अननुक्रमित अंश है — किसी जीनोम के लिए, कुछ दसियों हज़ार अंतरालों में दो करोड़ क्षार। पर वह है, कुल मिलाकर । मानव जीनोमों का अनुक्रमण नियमित रूप से पर होता है, आच्छादन-अंतरालों के कारण नहीं () बल्कि इसलिए कि हर क्षार को दोनों गुणसूत्रों में से हर एक पर कई बार पढ़ना पड़ता है ताकि प्रति वाचन त्रुटि-दर के सामने कोई विषमयुग्मजी प्रकारांतर विश्वास से पुकारा जा सके। जीवाणु जीनोमों का अनुक्रमण इसी कारण और इसलिए भी कि वह सस्ता है, – पर होता है। सूत्र यह भी दिखाता है कि आच्छादन क्या ठीक नहीं कर सकता: किसी वाचन से लंबी कोई पुनरावृत्ति वह जगह है जहाँ अतिव्यापन ग्राफ़ शाखित होता है, और कितने ही छोटे वाचन उसे सुलझा नहीं सकते। दीर्घ वाचन इसी के लिए हैं।