Universitaire biologie — jaar 3 · Bachelor Year 3
4Genomica en sequencing
Het eerste volledige genoom van een vrijlevend organisme, de van een bacterie, werd in 1995 gepubliceerd na een jaar werk van een ploeg van veertig. Het menselijk genoom, miljard basenparen, kostte een internationaal consortium dertien jaar en ongeveer drie miljard dollar en werd in 2003 voltooid verklaard. Vandaag leest een tafelapparaat een menselijk genoom in één nacht voor enkele honderden dollars, sequenceert een ziekenhuis de tumor van een patiënt om een geneesmiddel te kiezen, en haalt een museum het genoom uit een bot van veertigduizend jaar oud en leest het. De techniek die dit mogelijk maakte, de wiskunde die miljoenen korte reads tot een genoom maakt, en wat de voltooide genomen hebben geleerd over de omvang, de inhoud en de geschiedenis van ons DNA vormen het onderwerp van dit hoofdstuk. Het volgende hoofdstuk neemt de algoritmen ter hand die de sequenties vergelijken zodra men ze in handen heeft.
4.1 DNA lezen
Definitie 4.1 (Sequencing door ketenterminatie)
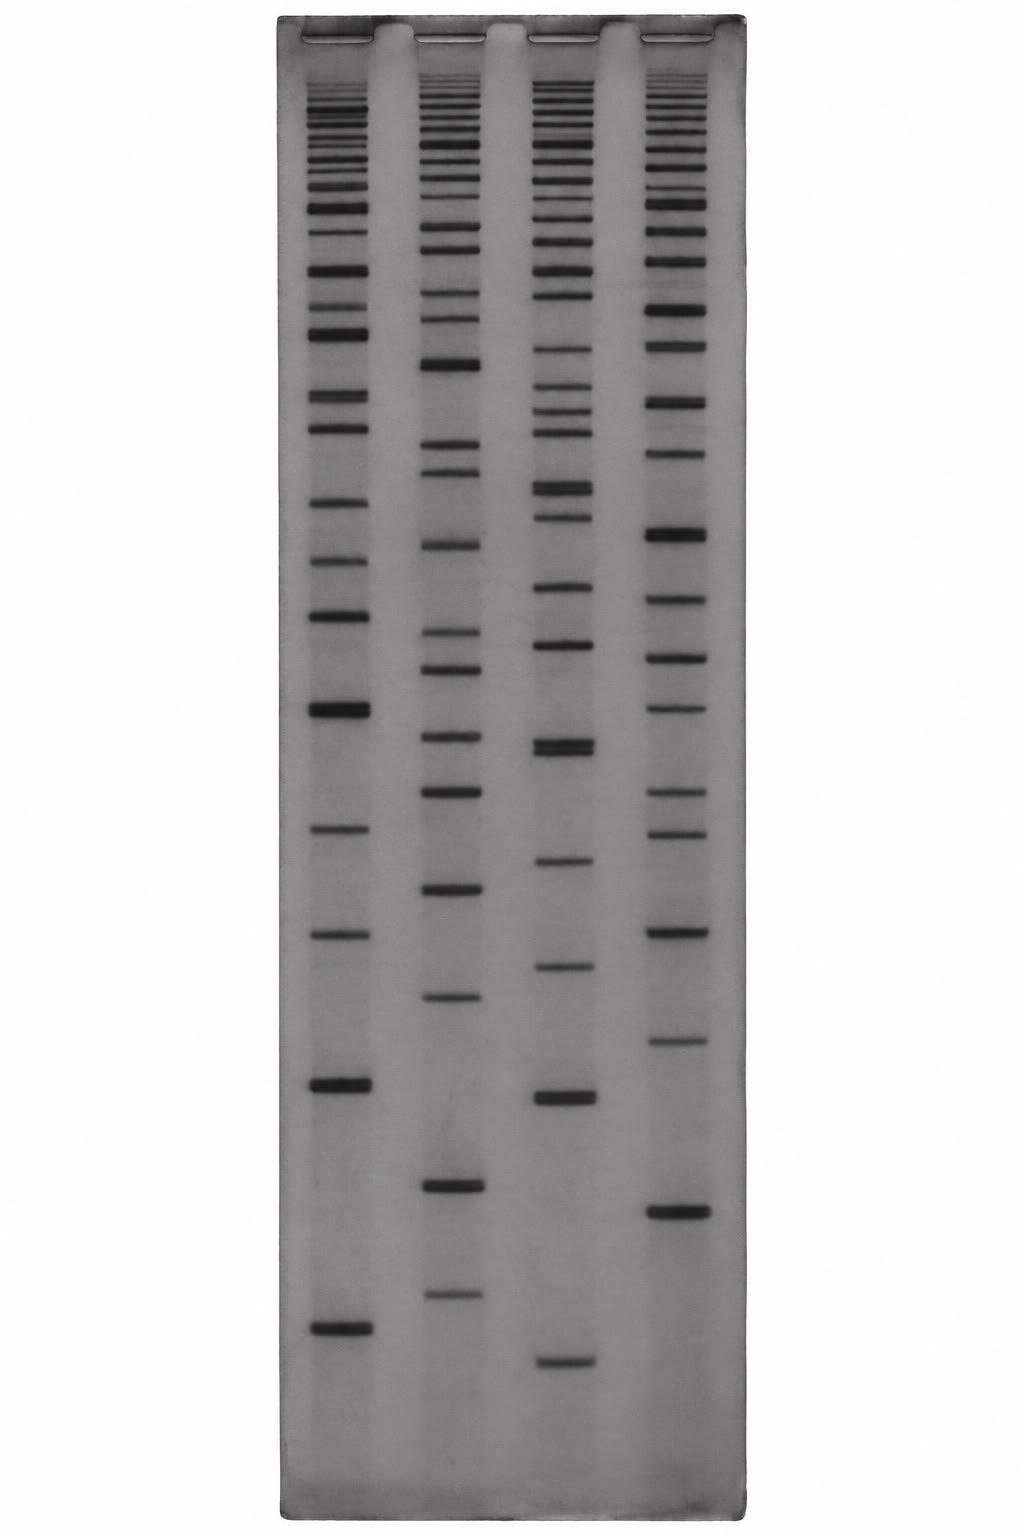
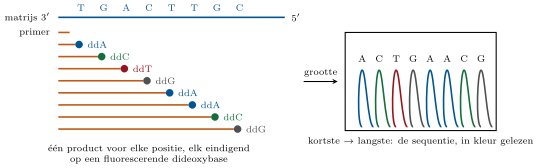
Sanger-sequencing kopieert een enkelstrengs matrijs vanaf een primer met DNA-polymerase, in aanwezigheid van de vier normale nucleotiden en een kleine hoeveelheid dideoxynucleotiden, die de 3-hydroxylgroep missen en de keten dus beëindigen waar zij ook worden ingebouwd. Elk dideoxynucleotide draagt een andere fluorescerende kleurstof. Het product is een mengsel van fragmenten, één voor elke positie van de matrijs, elk eindigend op een base van bekende identiteit; op grootte gescheiden in een gelcapillair passeren zij een detector op volgorde van lengte, en de volgorde van de kleuren is de sequentie van de matrijs. Eén run leest met een foutenpercentage onder ; het blijft de methode om een construct of één enkel gen te verifiëren.
Bewijsmateriaal. Sanger, Nicklen en Coulson publiceerden de methode in 1977 en lazen er datzelfde jaar de van de faag X174 mee — het eerste volledige DNA-genoom — en in 1981 de van het menselijke mitochondrion. Fleischmann en collega’s (1995) lazen de van Haemophilus influenzae door het hele genoom in willekeurige fragmenten te breken, er van te sequencen en de reads met de computer samen te voegen — de hagelschotstrategie voor het hele genoom die elk later project heeft opgeschaald. ∎
Definitie 4.2 (Massaal parallelle sequencing)
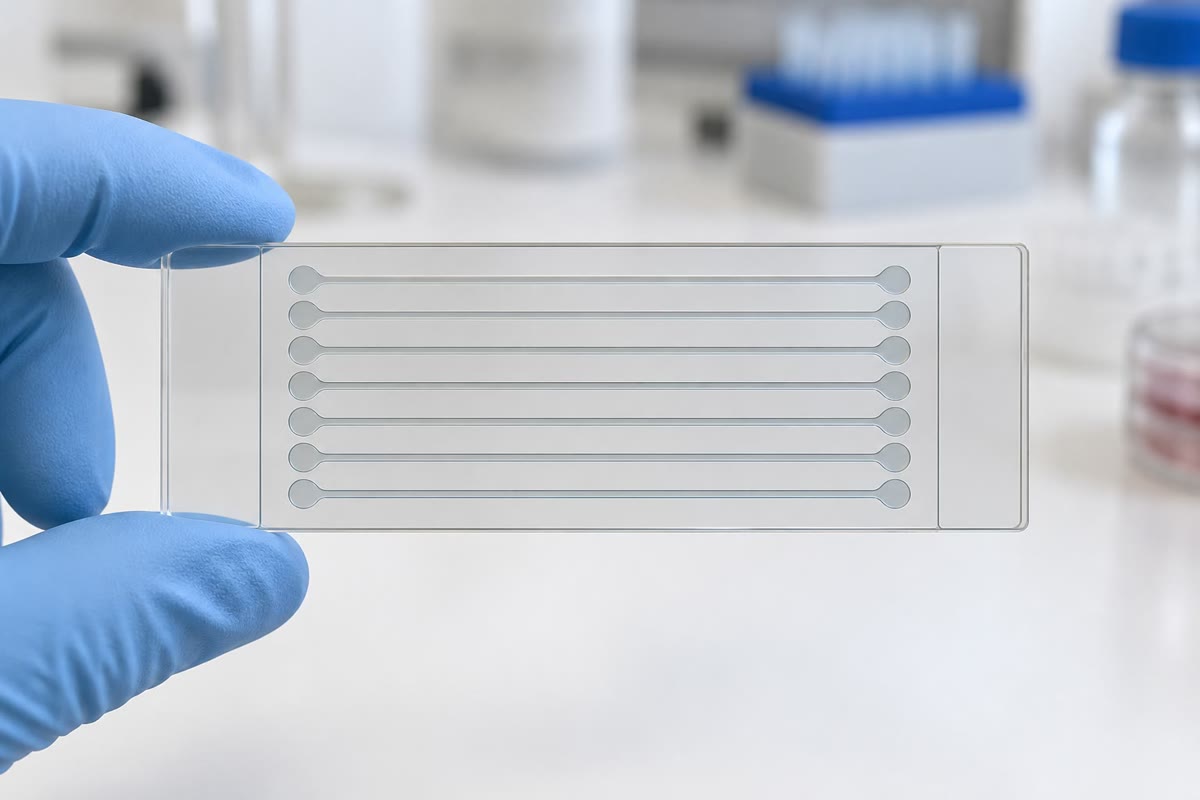
Instrumenten van de tweede generatie lezen miljoenen tot miljarden fragmenten tegelijk. Bij sequencing door synthese worden de fragmenten, met adapters aan hun uiteinden geligeerd, aan een glazen stroomcel gebonden en daar ter plaatse vermenigvuldigd tot clusters van identieke moleculen; die clusters worden vervolgens per cyclus met één base verlengd met fluorescerende, omkeerbaar geblokkeerde nucleotiden, afgebeeld, gedeblokkeerd en opnieuw verlengd, zodat elke cyclus één base toevoegt aan de read van elk cluster. De reads zijn lang, meestal vanaf beide uiteinden van een fragment (gepaarde uiteinden), met een foutenpercentage van ongeveer per base, en één run levert tot basen op. Instrumenten van de derde generatie met lange reads lezen afzonderlijke moleculen zonder vermenigvuldiging: door één polymerase in reële tijd fluorescerende nucleotiden te zien inbouwen, of door het DNA door een eiwit-nanoporie te rijgen en de ionenstroom te registreren, die elke opeenvolging van basen op haar eigen manier moduleert. Reads van en meer overspannen de herhalingen waar korte reads niet overheen komen, tegen een hoger ruw foutenpercentage dat de consensus terugbrengt.
Stelling 4.3 (Dekking en gaten in een hagelschotproject)
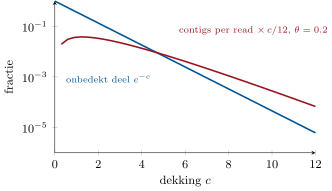
Laat reads van lengte op willekeurige posities langs een genoom van lengte worden genomen, en zij de dekking, het gemiddelde aantal reads dat een base bedekt. Dan wordt een gegeven base bedekt door een aantal reads dat poissonverdeeld is met gemiddelde : het deel van het genoom dat ongesequenced blijft is
en als twee reads pas als overlappend worden herkend wanneer zij minstens basen delen, zodat , is het verwachte aantal contigs (eilanden van overlappende reads)
en hun gemiddelde lengte is bij benadering .
Bewijs. De beginpunten van de reads vallen willekeurig met dichtheid per base. Een base wordt bedekt door de reads die in de basen ervóór beginnen; het aantal beginpunten in een venster van lengte is poissonverdeeld met gemiddelde , en de kans op geen enkel beginpunt is . Een read is de meest rechtse van zijn contig als geen andere read begint binnen de basen na zijn eigen beginpunt (een read die later begint zou hem met minder dan overlappen en niet worden aangehecht); die kans is , en omdat elke contig precies één meest rechtse read heeft, is het verwachte aantal contigs . De gemiddelde contiglengte volgt uit gedeeld door het aantal contigs, gecorrigeerd voor het onbedekte deel. ∎
Voorbeeld 4.4 (Hoeveel genoeg is)
Bij is het ongesequencede deel — voor een genoom van twintig miljoen basen in enkele tienduizenden gaten. Bij is het , in totaal . Menselijke genomen worden standaard bij gesequenced, niet vanwege dekkingsgaten () maar omdat elke base op elk van de twee chromosomen meermalen moet worden gelezen om een heterozygote variant met vertrouwen vast te stellen tegen een foutenpercentage van per read. Bacteriële genomen worden bij – gesequenced om dezelfde reden en omdat het goedkoop is. De formule laat ook zien wat dekking niet kan oplossen: een herhaling die langer is dan een read is een plaats waar de overlapgraaf zich vertakt, en geen enkele hoeveelheid korte reads lost dat op. Daar zijn lange reads voor.
4.2 Van reads naar een genoom
Definitie 4.5 (Assemblage en annotatie)
De assemblage reconstrueert een genoom uit zijn reads via overlap: in een overlapgraaf is elke read een knoop, verbonden met de reads die hij overlapt; in een De Bruijn-graaf, gebruikt voor miljarden korte reads, is elke -meer (deelsequentie van lengte ) een knoop en is het genoom een pad erdoorheen. Beide worden gebroken door herhalingen die langer zijn dan de read, die vertakkende paden geven. Contigs worden door gepaarde reads en informatie over grote afstand (lange reads, optische kaarten, kaarten van chromosoomcontacten) geordend en gericht tot scaffolds, en de scaffolds worden op de chromosomen geplaatst. De kwaliteit van een assemblage wordt samengevat door de N50: de contiglengte waarvoor de helft van de geassembleerde basen in contigs van minstens die lengte ligt. De annotatie zoekt daarna de genen: bij bacteriën open leesramen die langer zijn dan het toeval geeft; bij eukaryoten door sequentiesignalen (splitsplaatsen, promotoren, codonvoorkeur), homologie met bekende eiwitten en uit RNA gesequencede transcripten te combineren. Het resultaat is voor een soort een referentiegenoom waartegen elke latere read van die soort wordt uitgelijnd in plaats van opnieuw geassembleerd.
Methode 4.6 (Van een monster naar varianten)
Voor een studie waarin een individu opnieuw wordt gesequenced tegen een referentie: (1) haal het DNA eruit, fragmenteer het tot en ligeer er adapters aan (de bibliotheek); (2) sequenceer tot de vereiste dekking (30 voor een menselijk genoom, 100 voor een exoom, dat de van het genoom vangt die voor eiwit codeert); (3) lijn elke read uit tegen de referentie, met tolerantie voor mismatches; (4) tel op elke positie de basen in de reads: een positie waar ongeveer de helft van de reads van de referentie afwijkt is een heterozygote variant, waar vrijwel alle reads afwijken een homozygote, en waar enkele reads afwijken een fout; (5) filter op diepte, basekwaliteit en strengbalans; (6) annoteer elke variant met haar effect op een gen (synoniem, missense, nonsense, splitsplaats, leesraamverschuiving) en met haar frequentie in populatiedatabanken; (7) houd voor een diagnose de zeldzame varianten over die schadelijk worden voorspeld in genen die bij het fenotype passen, en bevestig ze met Sanger-sequencing.
4.3 Hoe genomen eruitzien
Propositie 4.7 (Genoomgrootte en aantal genen)
Genoomgroottes beslaan bij eukaryoten een factor — voor gist, voor de worm, voor de vlieg, voor een mens, voor een ui, voor een longvis, voor de lelie Paris japonica — terwijl de aantallen genen amper een factor beslaan: bij gist, bij de worm, bij de vlieg, ongeveer eiwitcoderende genen bij een mens, bij rijst. Dat is de C-waardeparadox: de genoomgrootte meet de complexiteit niet, en het aantal genen evenmin. Wat varieert is de niet-coderende inhoud — introns, verplaatsbare elementen, satellietherhalingen — en het aantal eiwitten dat een genoom kan voortbrengen wordt ver boven zijn aantal genen vermenigvuldigd door alternatieve splicing (Hoofdstuk 2) en door regulatie, en daar is de complexiteit van een organisme grotendeels geschreven. Bacteriële genomen zijn daarentegen compact en hun grootte volgt het aantal genen wel: ongeveer één gen per kilobase, coderend bij E. coli.
Voorbeeld 4.8 (Het menselijk genoom naar inhoud)
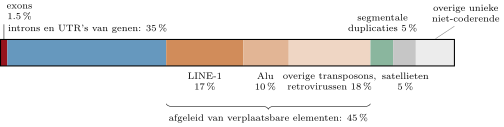
Van de : eiwitcoderende exons ; introns en niet-vertaalde regio’s van genen ongeveer ; verplaatsbare elementen en hun fossielen ongeveer — LINE-1-retrotransposons , Alu-elementen (ruim een miljoen kopieën van een sequentie van ), endogene retrovirussen ; segmentale duplicaties ; eenvoudige herhalingen en satellieten, met inbegrip van de centromeren, ongeveer ; de rest unieke niet-coderende sequentie, waar de regulerende elementen wonen. Zo’n genen coderen nog voor werkzame LINE-1-machinerie, en nieuwe inserties treden ongeveer eens per twintig geboorten op. Ongeveer van het genoom staat onder aantoonbare zuiverende selectie — veel meer dan de exons — en het meeste daarvan is regulerend.
Definitie 4.9 (Vergelijkende genomica)
Genen in twee soorten die van één gen in hun gemeenschappelijke voorouder afstammen zijn orthologen; genen binnen één soort die van een duplicatie afstammen zijn paralogen. Blokken chromosoom waarin de genvolgorde tussen soorten bewaard is gebleven zijn synteen; syntenie laat een gen in het ene genoom opsporen vanuit zijn positie in het andere en legt de herschikkingen bloot die twee karyotypen scheiden (ongeveer tussen mens en muis). Sequenties die over verre soorten heen zijn geconserveerd en voor geen eiwit coderen — geconserveerde niet-coderende elementen, waarvan sommige over tussen mens en vis tot op de base ultrageconserveerd zijn — zijn meestal enhancers van ontwikkelingsgenen. Volledige-genoomduplicaties hebben de geschiedenis van afstammingslijnen getekend: twee ronden aan de oorsprong van de gewervelden (de vier Hox-clusters van zoogdieren tegen de ene van ongewervelden), één in de voorouder van de zalmachtigen, één in de gistlijn, verscheidene bij bloemplanten; de dubbele genen gaan over tientallen miljoenen jaren grotendeels verloren, en de overlevenden lopen in functie uiteen.
Voorbeeld 4.10 (Mens en chimpansee)
Uitgelijnde enkelvoudige sequentie verschilt tussen mens en chimpansee in van de basen — zo’n miljoen substituties — en door inserties en deleties die samen nog eens van elk genoom beslaan. Twee mensen verschillen op ongeveer één base op duizend, zo’n miljoen plaatsen, plus enkele duizenden structurele varianten; twee chimpansees, waarvan de populatie langer groter is geweest, op nogal wat meer. Een kind draagt ongeveer nieuwe mutaties die bij beide ouders ontbreken, vier vijfde daarvan van de vader, en het aantal stijgt met ongeveer twee per jaar vaderleeftijd — de rekensom van Hoofdstuk 3 toegepast op de vele delingen van de spermatogenese.
4.4 Genomen en eigenschappen
Definitie 4.11 (Genoombrede associatie)
Een enkelnucleotidepolymorfisme (SNP) is een positie waar twee basen elk bij minstens van een populatie voorkomen; bij de mens zijn er ongeveer tien miljoen algemeen. Een genoombrede associatiestudie (GWAS) bepaalt het genotype van honderdduizenden SNP’s bij duizenden mensen met een ziekte en duizenden zonder, en vraagt bij elke SNP of het ene allel vaker bij de gevallen voorkomt. Omdat er een miljoen toetsen worden uitgevoerd, telt een uitkomst pas onder een significantiedrempel van ongeveer ( gedeeld door de miljoen feitelijk onafhankelijke toetsen). Geassocieerde SNP’s markeren een gebied, niet een oorzakelijke variant, omdat naburige allelen samen reizen (koppelingsonevenwicht) over tientallen kilobasen. Bij de meeste veelvoorkomende ziekten verschuift elk geassocieerd allel het risico met enkele procenten en ligt het meestal in regulerende sequentie; hun gezamenlijke effect, over duizenden SNP’s opgeteld als een polygene score, verklaart een deel van de erfelijkheid en voorspelt het risico ongeveer even goed als de familiegeschiedenis.
Opmerking 4.12 (Wat de genomica wel en niet heeft gebracht)
Sequencing is doorslaggevend geweest waar één gen een groot effect heeft: enkele duizenden mendeliaanse ziekten hebben hun gen, en het sequencen van het exoom van een kind met een niet-gediagnosticeerde aandoening levert in ongeveer een derde van de gevallen een diagnose op. Tumorgenomen laten zien welke aandrijvers een tumor draagt en welke middelen kunnen werken (Hoofdstuk 11); ziekteverwekkergenomen volgen uitbraken stam voor stam (Hoofdstuk 12); oude genomen hebben de menselijke voorgeschiedenis herschreven en laten zien dat mensen buiten Afrika ongeveer neanderthaler-DNA dragen. Voor veelvoorkomende ziekten — diabetes, hartziekte, schizofrenie — heeft de genomica duizenden kleine effecten en weinig mechanismen opgeleverd, en de belofte van voorspelling uit een genoom van een gezond mens blijft bescheiden. Het genoom is een onderdelenlijst; de biologie van hoe de onderdelen samenwerken is er niet uit af te lezen.
4.5 Opgaven
Oefening 4.1 ★
Leg uit waarom een dideoxynucleotide een groeiende DNA-keten beëindigt, en waarom een Sanger-reactie van elk nucleotide zowel de normale als de dideoxyvorm moet bevatten.
Oplossing
Oplossing van Oefening 4.1.
Een dideoxynucleotide heeft geen 3-hydroxylgroep, dus kan er geen fosfodiesterbinding met het volgende nucleotide worden gemaakt en stopt de keten. Met alleen dideoxyvormen zou elke keten bij de eerste positie stoppen; met alleen normale vormen zou er geen enkele stoppen. Het mengsel maakt de terminatie op elke positie een toevalsgebeurtenis, zodat de producten een volledige ladder vormen, één lengte voor elke base van de matrijs.
Oefening 4.2 ★
Eén run levert gepaarde reads van . Welke dekking geeft dat van een menselijk genoom van ? En van een bacterieel genoom van ?
Oplossing
Oplossing van Oefening 4.2.
basen. Mens: . Bacterie: .
Oefening 4.3 ★
Definieer contig, scaffold en N50. Een assemblage van heeft tien contigs van en van . Wat is haar N50?
Oplossing
Oplossing van Oefening 4.3.
Een contig is een aaneengesloten sequentie die uit overlappende reads is geassembleerd; een scaffold is een geordende, gerichte reeks contigs met gaten van geschatte grootte ertussen; de N50 is de contiglengte waarbij de gesorteerde contigs de helft van de geassembleerde basen bereiken. Hier bevatten de tien contigs van al , voorbij het halverwegepunt van (de zevende bereikt ): N50 .
Oefening 4.4 ★
Formuleer de C-waardeparadox met twee voorbeelden, en zeg waaruit het overtollige DNA van grote genomen vooral bestaat.
Oplossing
Oplossing van Oefening 4.4.
De genoomgrootte volgt de complexiteit van een organisme niet: een ui heeft vijf keer zoveel DNA als een mens, een longvis veertig keer; gist en de worm verschillen tienvoudig in DNA bij vergelijkbare aantallen genen. Het overschot is niet-coderend: verplaatsbare elementen en hun resten, introns, satellietherhalingen.
Oefening 4.5 ★★
Bepaal met Stelling 4.3 de dekking die nodig is om hoogstens één base op een miljoen ongesequenced te laten, en het verwachte aantal contigs voor een genoom van dat bij wordt gelezen met reads van en een minimale overlap van .
Oefening 4.6 ★★
Een heterozygote variant wordt door reads bedekt. Wat is, als elke read met kans het ene of het andere allel toont, de kans dat minder dan reads het variante allel tonen (zodat het voor fouten zou kunnen worden aangezien)? Gebruik een normale benadering met gemiddelde en standaardafwijking . Waarom is de standaard?
Oplossing
Oplossing van Oefening 4.6.
. Bij worden beide allelen van een heterozygoot vrijwel altijd vele keren gezien, is de dekking ongelijkmatig (GC-rijke gebieden krijgen minder reads, zodat sommige plaatsen de helft van het gemiddelde zien), en blijven er genoeg reads over om een echt allel van de fouten van te scheiden.
Oefening 4.7 ★★
Een genoom bevat een herhaling van in kopieën. Leg uit waarom een assemblage uit reads van haar laat inklappen, hoe de resulterende graaf eruitziet, en welke readlengte haar zou oplossen.
Oplossing
Oplossing van Oefening 4.7.
Elke read van uit de herhaling is identiek, van welke kopie hij ook komt, dus bouwt de assembler één knoop van met paden die binnenkomen en die vertrekken; hij kan niet zien welke ingang bij welke uitgang hoort, en de assemblage breekt in gaten, met de herhaling één keer aanwezig bij een dekking van keer het gemiddelde. Reads die langer zijn dan de herhaling plus unieke flanken aan beide zijden — of meer — overspannen elke kopie en lossen haar op.
Oefening 4.8 ★★
Twee mensen verschillen op één base op duizend. Hoeveel verschillen zitten er in hun exomen ( coderende sequentie)? Als twee derde van de coderende verschillen synoniem of onschadelijk is en de rest een eiwit verandert, hoeveel eiwitveranderende varianten draagt de ene persoon dan ten opzichte van de andere?
Oplossing
Oplossing van Oefening 4.8.
coderende verschillen; een derde daarvan, ongeveer , verandert het eiwit.
Oefening 4.9 ★★
Een GWAS toetst SNP’s bij drempel . Hoeveel valse positieven zijn er te verwachten als geen enkele SNP echt geassocieerd is? Een SNP-allel verhoogt het risico op een ziekte met frequentie naar . Leg uit waarom zo’n effect in een studie met duizend mensen niet aantoonbaar is en voor een individu nutteloos, en toch naar een mechanisme kan wijzen.
Oplossing
Oplossing van Oefening 4.9.
Verwachte valse positieven . Een relatief risico van op een ziekte van verandert enkele gevallen per duizend; duizend mensen bevatten ongeveer twintig gevallen, veel te weinig om het te zien (het onderscheidend vermogen groeit met het aantal gevallen en met het kwadraat van het effect). Voor een individu is procentpunt betekenisloos. Maar het allel markeert een gen waarvan een bescheiden verandering in activiteit het ziekterisico verandert — het gen, en zijn route, kunnen een aangrijpingspunt voor een geneesmiddel zijn waarvan volledige remming een groot effect heeft.
Oefening 4.10 ★★★
Bacteriële genomen zijn voor ongeveer coderend, het menselijk genoom voor . Geef drie hypothesen — populatiegenetisch, structureel en regulerend — voor het verschil, en bij elk een waarneming aan genomen die haar steunt of ondergraaft.
Oplossing
Oplossing van Oefening 4.10.
Populatiegenetisch: bij bacteriën, met enorme populaties, verwijdert de selectie zelfs licht kostbare inserties; bij zoogdieren, met kleine effectieve populaties, laat de drift licht schadelijk niet-coderend DNA zich ophopen — gesteund door de omgekeerde samenhang tussen genoomgrootte en populatiegrootte over afstammingslijnen heen, ondergraven door uitzonderingen. Structureel: eukaryote genomen worden binnengedrongen door transposons die bacteriën, met een voorkeur voor deletie en zonder meiotisch toevluchtsoord voor zelfzuchtige elementen, opruimen — gesteund door de samenhang tussen genoomgrootte en transposoninhoud. Regulerend: complexe ontwikkeling vergt meer regulerend DNA — gesteund door de geconserveerde niet-coderende elementen rond ontwikkelingsgenen, ondergraven door het feit dat maar van het menselijk genoom enige selectie vertoont, zodat het meeste niet-coderende DNA niet regulerend is.
Oefening 4.11 ★★★
Leid de contigtelling van Lander–Waterman af voor een mengsel van reads van twee lengtes: korte reads van lengte en lange reads van lengte , met overlappen die met dezelfde minimale worden geteld. (Beschouw elke read als de meest rechtse van zijn contig als er geen read van welke soort dan ook begint binnen zijn eigen lengte min .) Laat zien dat enkele lange reads de contigtelling meer verlagen dan hetzelfde aantal basen in korte reads.
Oplossing
Oplossing van Oefening 4.11.
Beginpunten van beide soorten vallen met totale dichtheid . Een read van lengte is de meest rechtse van zijn contig als er geen read van welke soort dan ook begint in de basen erna: kans . Dus contigs . Een lange read is de meest rechtse met een exponentieel kleinere kans dan een korte, en elke lange read haalt ook over zijn hele lengte de kans op een gat weg; hetzelfde aantal basen in korte reads voegt vele beginpunten toe maar elk beschermd venster is kort, zodat de lange reads winnen.
Oefening 4.12 ★★★
Van de vier Hox-clusters van zoogdieren wordt betoogd dat zij door twee ronden van volledige-genoomduplicatie aan de basis van de gewervelden uit één cluster afstammen. Zeg welk patroon van paralogen door het genoom heen, en welk patroon in de genomen van prikken en van de ongewervelde chordaten, die hypothese voorspelt, en hoe men haar zou onderscheiden van twee onafhankelijke duplicaties van alleen het cluster.
Oplossing
Oplossing van Oefening 4.12.
Twee volledige-genoomduplicaties voorspellen dat het viervoudige patroon genoombreed is: viertallen paraloge chromosoomsegmenten (paralogons) die dezelfde genfamilies in dezelfde volgorde dragen, met duplicaties die voor alle families op dezelfde tijd worden gedateerd; één enkel cluster bij amphioxus en Ciona, die vóór de gebeurtenissen zijn afgesplitst; en bij de prikken, die er rond zijn afgesplitst, een tussenvorm of een onafhankelijk afgeleide toestand. Onafhankelijke duplicaties van alleen het Hox-cluster voorspellen paralogons voor alleen Hox, buren met een andere geschiedenis, en dateringen van de duplicatie die per familie verschillen. De genoombrede paralogons en de gedeelde datering, zoals waargenomen, pleiten voor volledige-genoomduplicatie.
4.6 Vraagstuk: twee genomen op één machine
Probleem 4.1
Weekendvraagstuk — een bacterie en een mens gesequenced op dezelfde run: de reads verdeeld, de dekking en de gaten berekend, de contigs geteld, de heterozygote varianten bepaald tegen het foutenpercentage, de inhoud van het menselijk genoom gewogen en een associatiestudie op maat gemaakt, met als besluit de contigtelling bij lage dekking, de dekking die een variantbepaling veilig maakt en het aantal nieuwe mutaties bij een kind
Gegevens: één run levert reads van . Een bacterieel genoom is ; het menselijk genoom (haploïd). Minimale overlap . Foutenpercentage per base per read. Menselijke coderende sequentie ; het genoom is voor van transposons afgeleid, met miljoen Alu-kopieën van . Twee mensen verschillen op één plaats op . Mutatiesnelheid per base per generatie.
Deel I — De bacterie.
- De bacterie krijgt van de run. Hoeveel reads, en welke dekking?
- Welk deel van haar genoom blijft ongesequenced? Hoeveel basen zijn dat?
- Bereken en het verwachte aantal contigs.
- Een eerdere proefrun gebruikte maar reads. Dekking, onbedekt deel en aantal contigs?
- Het genoom bevat kopieën van een rRNA-operon van . Leg uit wat er in de assemblage met hen gebeurt en hoeveel contiguiteinden dit alleen al oplevert.
- De bacterie heeft ongeveer één gen per kilobase. Hoeveel genen, en, als van het genoom coderend is, wat is de gemiddelde genlengte?
Deel II — De mens.
- De rest van de run gaat naar één menselijk genoom. Welke dekking van het diploïde genoom per haploïde kopie (dat wil zeggen het totaal aantal basen gedeeld door )?
- Op een heterozygote plaats wordt elk van de twee allelen door ongeveer de helft van de reads bedekt. Wat is met de dekking uit vraag 7 het verwachte aantal reads dat elk allel toont?
- Een fout toont met kans een verkeerde base in een read. Wat is op een homozygote plaats die door reads wordt bedekt het verwachte aantal reads dat een bepaalde verkeerde base toont (elk )? Waarom verwerpt een regel “bepaal een variant als minstens reads en minstens van de reads haar tonen” bij deze dekking de fouten?
- Hoeveel heterozygote plaatsen draagt één mens (ruwweg de helft van de verschillen tussen twee willekeurige genomen ligt in elk: neem één plaats op )? Hoeveel in coderende sequentie?
- De reads worden tegen een referentie uitgelijnd. Leg uit waarom reads uit Alu-elementen vaak op de verkeerde kopie terechtkomen en welk gevolg dat heeft voor het bepalen van varianten erin.
- Een kind wordt samen met beide ouders gesequenced. Hoeveel nieuwe mutaties zijn er te verwachten? Hoeveel reads bij het kind moeten bij deze dekking een variant tonen die bij beide ouders ontbreekt voordat men haar gelooft, en waarom is de dekking bij de ouders even belangrijk als die bij het kind?
- Een klinisch laboratorium vangt het exoom () en sequenceert het bij . Hoeveel reads kost dat, en waarom is het per patiënt goedkoper dan een genoom bij , hoewel de dekking hoger is?
Deel III — De inhoud van een genoom.
- Welk deel van het menselijk genoom is Alu, en welk deel van de reads uit vraag 7 komt uit Alu-elementen?
- De referentie is maar een diploïde cel bevat ; en een ui van heeft ongeveer genen. Wat is het coderende deel van het uiengenoom, als zijn genen gemiddeld coderende sequentie hebben?
- Mens en chimpansee verschillen op van de uitgelijnde basen. Hoeveel substituties zijn dat in uitlijnbare sequentie? Welke mutatiesnelheid per base per jaar volgt hieruit als zij gelijk over de twee afstammingslijnen worden verdeeld over miljoen jaar, en welke per generatie van jaar? Vergelijk met de rechtstreekse meting uit de gegevens.
- Twee genoomduplicaties bij de gewervelden zouden tot vier kopieën van elk voorouderlijk gen moeten geven. Mensen hebben ongeveer genen en de ongewervelde chordaat Ciona ongeveer . Welk deel van de duplicaten is verloren gegaan, onder de hypothese dat de voorouder er had?
- Leg uit waarom het aantal genen een slechte maat voor de complexiteit van een organisme is, met de telling van de alternatieve splicing uit Hoofdstuk 2 als één argument.
- van het genoom staat onder zuiverende selectie maar slechts codeert voor eiwit. Wat is de rest waarschijnlijk, en hoe zou één kandidaat-element te toetsen zijn?
Deel IV — Een associatiestudie.
- Er worden SNP’s getoetst. Geef de bonferronidrempel voor een gezinsgewijze fout van , en het verwachte aantal valse positieven bij .
- Een ziekte heeft een prevalentie van . Een risicoallel met frequentie verhoogt de odds met . Bereken het ziekterisico van een drager van twee kopieën, van één kopie en van geen enkele, met als risico voor een niet-drager. (Vermenigvuldig de odds.)
- Er worden tweehonderd zulke allelen gevonden. Leg uit wat een polygene score is, en waarom de score van iemand in de bovenste met een meervoudig risico kan overeenkomen hoewel elk allel vrijwel niets doet.
- Leg uit waarom een SNP die significantie bereikt meestal niet de oorzakelijke variant is, en welk experiment de oorzakelijke in het gebied zou aanwijzen.
- Een oud genoom uit een bot van jaar oud wordt bij gesequenced. Welk deel ervan wordt gelezen? Waarom kan dit toch vragen over de geschiedenis van populaties beantwoorden die een modern genoom alleen niet kan?
- Vat samen: het aantal contigs in de proefassemblage (vraag 4), de dekking per haploïd genoom die ongeveer reads per allel geeft (vraag 7–8), en het aantal nieuwe mutaties bij een kind (vraag 12).
Oplossing
Oplossing van Probleem 4.1.
1. reads; . 2. : feitelijk geen enkele base onbedekt. 3. ; contigs : in theorie één contig, met gaten alleen bij herhalingen. 4. ; onbedekt , ongeveer ; contigs . 5. De zeven operons geven identieke reads en klappen samen tot één contig van , binnengegaan door zeven unieke linkerflanken en verlaten door zeven rechterflanken waarvan de koppeling onbekend is: contiguiteinden, zeven gaten. 6. Ongeveer genen; coderend bp, gemiddeld gen . 7. . 8. Ongeveer reads per allel. 9. reads die een gegeven verkeerde base tonen — de kans op drie of meer is ongeveer — en van is reads; een fout doorstaat geen van beide toetsen, terwijl een echt heterozygoot allel in reads wordt verwacht. 10. heterozygote plaatsen; in coderende sequentie . 11. Een read van uit een Alu past vrijwel even goed op veel van de miljoen kopieën, dus wordt hij op de verkeerde kopie gelegd of met weinig vertrouwen gekarteerd. Verschillen tussen kopieën lijken dan op heterozygote varianten, en echte varianten gaan daartussen schuil: variantbepalingen binnen Alu worden meestal weggefilterd, en de elementen zijn blinde vlekken van sequencing met korte reads. 12. nieuwe mutaties. Ongeveer reads zouden de variant bij het kind moeten tonen; maar als de plaats bij een ouder door maar vijf reads wordt bedekt, wordt een heterozygoot allel met kans gemist en wordt een geërfde variant ten onrechte als nieuw bestempeld — dus moeten de ouders even diep worden gesequenced als het kind. 13. reads, twintig keer minder dan het genoom: de sequencingkosten dalen twintigvoudig, meer dan de kosten van de vangststap. 14. bp, ongeveer van het genoom; van de reads, zo’n . 15. bp; . 16. substituties, per afstammingslijn; snelheid per base per jaar, per generatie van 25 jaar — ongeveer tweemaal de stamboomsnelheid van , een bekende discrepantie die op langere generatietijden in het verleden of op een oudere splitsing wijst. 17. Vier kopieën van zouden zijn; blijven over, dus van de extra kopieën overleven er maar : van de duplicaten ging verloren. 18. De worm en de mens hebben evenveel genen; de complexiteit ligt in hoe ze worden gebruikt — alternatieve splicing vermenigvuldigt één gen tot duizenden eiwitten ( voor Dscam), de regulatie combineert transcriptiefactoren en enhancers op celtypespecifieke wijze, niet-coderende RNA’s voegen lagen toe, en eiwitten werken in netwerken samen. 19. Regulerende elementen (enhancers, promotoren, isolatoren), genen voor niet-coderend RNA, signalen voor splitsing en lokalisatie, replicatie-oorsprongen en structurele sequenties. Toets een kandidaat-enhancer door hem vóór een reportergen in een transgeen embryo te plaatsen en te kijken waar het reportergen tot expressie komt, en verwijder het element daarna met CRISPR uit het genoom en meet de naburige genen. 20. ; bij zijn valse positieven te verwachten. 21. Odds voor een niet-drager ; bij één kopie odds , risico ; bij twee kopieën odds , risico . 22. De score telt over de allelen het aantal risicokopieën dat iemand draagt, gewogen met de log-oddsratio van elk allel. De telling heeft gemiddelde en standaardafwijking ; de bovenste draagt ongeveer allelen meer dan gemiddeld, en : bijna drievoudige odds ten opzichte van een gemiddeld persoon, uit allelen die het risico elk met veranderen. 23. Allelen binnen een blok van tientallen kilobasen worden samen geërfd (koppelingsonevenwicht), zodat elk daarvan dezelfde associatie vertoont; de gegenotypeerde SNP is enkel degene die op de array stond. Om de oorzakelijke variant te vinden: sequenceer het gebied bij gevallen en controles, versmal de verzameling statistisch, en toets daarna elke kandidaat — reportertoetsen voor de enhanceractiviteit van elk allel, elk allel in cellen bewerken en de expressie van de nabije genen meten, colokalisatie met signalen van expressiekwantitatieve loci. 24. van het genoom wordt gelezen. Het geeft een rechtstreekse steekproef van een populatie op een bekend tijdstip in het verleden — allelfrequenties vóór latere migraties en vermenging, de lengte van neanderthalersegmenten (lang, omdat weinig generaties van recombinatie ze hadden gebroken) en daarmee een datering van de vermenging — die moderne genomen alleen via modellen kunnen afleiden. 25. Ongeveer contigs in de proefassemblage; per haploïd genoom, ongeveer reads per allel; zo’n nieuwe mutaties bij een kind.