 Pelatih
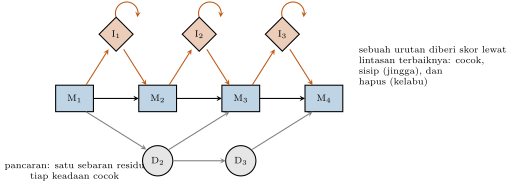
Sebuah penjajaran urutan berganda menata sebuah famili urutan menjadi lajur residu yang homolog. Pemrograman dinamis yang eksak atas urutan berbiaya dan mustahil di atas tiga urutan; program yang praktis menjajarkan secara berangsur, mula-mula pasangan terdekat menurut pohon pemandu, lalu urutan dan kelompok dijajarkan pada penjajaran yang sedang tumbuh, dengan beberapa putaran penghalusan. Penjajaran yang rampung diringkaskan sebagai sebuah profil: bagi tiap lajur, frekuensi tiap residu dan frekuensi celahnya. Sebuah model Markov tersembunyi berprofil memformalkan hal itu sebagai rantai keadaan cocok, satu keadaan tiap lajur yang lestari, yang masing-masing memancarkan residu dengan peluangnya sendiri, dengan keadaan sisip dan keadaan hapus yang membolehkan residu tambahan atau residu yang hilang pada tiap kedudukan; model sebuah famili (sebuah entri Pfam) memberi skor pada urutan baru lewat peluang lintasan terbaiknya melalui keadaannya, dan menemukan homolog jauh di bawah zona remang perbandingan berpasangan, karena sebuah lajur yang hanya mentoleransi residu hidrofob mengatakannya, sedangkan satu urutan tunggal tidak.
Contoh
Contoh 5.7 (Keidentikan, kemiripan, dan zona remang)
Dua urutan protein acak yang dijajarkan secara optimum dengan celah mencapai sekitar keidentikan secara kebetulan. Di atas keidentikan sepanjang seratus residu, dua protein hampir pasti homolog; antara dan terletak zona remang, tempat keidentikan sendirian tak dapat memutuskan dan statistika di bawah harus memutuskannya. Homolog dapat jatuh jauh di bawah zona itu: subunit hemoglobin dan mioglobin berbagi keidentikan, lisozim dan -laktalbumin , dan banyak pasangan protein berlipatan sama berbagi kurang dari , yang hanya terdeteksi dengan membandingkan profil atau struktur.
Contoh 5.10 (Membaca sebuah nilai-E)
Sebuah kueri berisi residu terhadap pangkalan data berisi residu memiliki . Sebuah kecocokan berskor bit memiliki : pada dasarnya pasti homolog. Kecocokan dengan memiliki : sebelas skor semacam itu diharapkan muncul secara kebetulan, dan kecocokannya tak bermakna. Penjajaran yang sama, dengan skor bit yang sama, bila ditelusurkan pada pangkalan data sepuluh kali lebih besar, memiliki sepuluh kali lebih besar — kebermaknaan adalah sifat penelusurannya, bukan sifat pasangannya. Ambang yang lazim dipakai adalah bagi homolog yang meyakinkan; – pantas ditengok lagi dengan metode profil.