 Coach
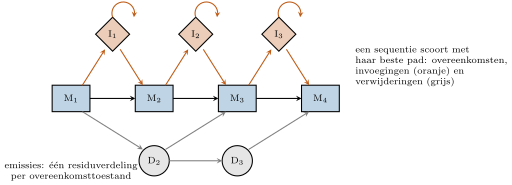
Een meervoudige sequentie-uitlijning zet een familie van sequenties in kolommen van homologe residuen. Exact dynamisch programmeren over sequenties kost en is voorbij drie onmogelijk; praktische programma’s lijnen stapsgewijs uit, eerst het naaste paar volgens een gidsboom, daarna sequenties en groepen bij de groeiende uitlijning, met ronden van verfijning. Een voltooide uitlijning wordt samengevat als een profiel: per kolom de frequentie van elk residu en van hiaten. Een profiel-HMM, een verborgen markovmodel, formaliseert dit als een keten van overeenkomsttoestanden, één per geconserveerde kolom, die elk residuen met hun eigen kansen uitzenden, met invoeg- en verwijdertoestanden die op elke positie extra of ontbrekende residuen toelaten; het model van een familie (een Pfam-vermelding) scoort een nieuwe sequentie met de kans van het beste pad door de toestanden, en vindt homologen ver onder de schemerzone van de paarsgewijze vergelijking, omdat een kolom die alleen hydrofobe residuen duldt dat ook zegt, terwijl één enkele sequentie dat niet kan.
Voorbeelden
Voorbeeld 5.7 (Identiteit, gelijkenis en de schemerzone)
Twee willekeurige eiwitsequenties die optimaal met hiaten worden uitgelijnd halen door toeval ongeveer identiteit. Boven identiteit over honderd residuen zijn twee eiwitten vrijwel zeker homoloog; tussen en ligt de schemerzone, waar identiteit alleen niets kan beslissen en de statistiek hieronder dat moet doen. Homologen kunnen ver onder de zone vallen: de subeenheden van hemoglobine en myoglobine delen identiteit, lysozym en -lactalbumine , en veel paren eiwitten met dezelfde vouwing delen minder dan , alleen op te sporen door profielen of structuren te vergelijken.
Voorbeeld 5.10 (Een E-waarde lezen)
Een zoekvraag van residuen tegen een databank van residuen heeft . Een treffer met een bitscore van heeft : vrijwel zeker een homoloog. Een treffer met heeft : elf zulke scores zijn door toeval te verwachten, en de treffer betekent niets. Dezelfde uitlijning, met dezelfde bitscore, tegen een tien keer grotere databank doorzocht, heeft een tien keer grotere — significantie is een eigenschap van de zoekactie, niet van het paar. De gangbare drempel is voor een betrouwbare homoloog; – verdient een tweede blik met een profielmethode.