 Coach
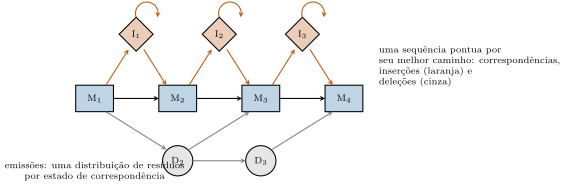
Um alinhamento múltiplo de sequências organiza uma família de sequências em colunas de resíduos homólogos. A programação dinâmica exata sobre sequências custa e é impossível além de três; os programas práticos alinham progressivamente, primeiro o par mais próximo segundo uma árvore-guia, depois sequências e grupos ao alinhamento em crescimento, com rodadas de refinamento. Um alinhamento pronto é resumido como um perfil: para cada coluna, a frequência de cada resíduo e das lacunas. Um modelo oculto de Markov de perfil formaliza isso como uma cadeia de estados de correspondência, um por coluna conservada, cada um emitindo resíduos com suas próprias probabilidades, com estados de inserção e de deleção que admitem resíduos a mais ou a menos em cada posição; o modelo de uma família (uma entrada do Pfam) pontua uma nova sequência pela probabilidade do melhor caminho pelos estados, e encontra homólogas bem abaixo da zona crepuscular da comparação par a par, porque uma coluna que só tolera resíduos hidrofóbicos diz isso, ao passo que uma sequência isolada não pode dizer.
Exemplos
Exemplo 5.7 (Identidade, similaridade e a zona crepuscular)
Duas sequências proteicas aleatórias alinhadas de forma ótima com lacunas chegam a cerca de de identidade por acaso. Acima de de identidade ao longo de cem resíduos, duas proteínas são quase certamente homólogas; entre e está a zona crepuscular, em que a identidade sozinha não decide e a estatística adiante precisa decidir. As homólogas podem cair bem abaixo da zona: as subunidades da hemoglobina e a mioglobina compartilham de identidade, a lisozima e a -lactalbumina , e muitos pares de proteínas de mesmo enovelamento compartilham menos de , detectáveis só pela comparação de perfis ou de estruturas.
Exemplo 5.10 (Ler um valor E)
Uma consulta de resíduos contra um banco de resíduos tem . Um acerto com escore em bits de tem : é, essencialmente com certeza, uma homóloga. Um acerto com tem : esperam-se onze escores desses por acaso, e o acerto não significa nada. O mesmo alinhamento, com o mesmo escore em bits, buscado contra um banco dez vezes maior, tem um dez vezes maior — a significância é propriedade da busca, não do par. O limiar de uso comum é para uma homóloga confiável; – merece uma segunda olhada com um método de perfil.