 Coach
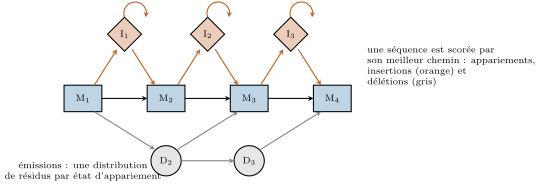
Un alignement multiple de séquences range une famille de séquences en colonnes de résidus homologues. La programmation dynamique exacte sur séquences coûte et devient impossible au-delà de trois ; les programmes pratiques alignent de façon progressive : d’abord la paire la plus proche selon un arbre guide, puis les séquences et les groupes s’ajoutent à l’alignement en croissance, avec des tours de raffinement. Un alignement achevé se résume en un profil : pour chaque colonne, la fréquence de chaque résidu et des brèches. Un modèle de Markov caché de profil formalise cela comme une chaîne d’états d’appariement, un par colonne conservée, chacun émettant des résidus avec ses propres probabilités, avec des états d’insertion et de délétion qui autorisent des résidus en trop ou manquants à chaque position ; le modèle d’une famille (une entrée Pfam) score une nouvelle séquence par la probabilité du meilleur chemin dans les états, et trouve des homologues bien en deçà de la zone crépusculaire de la comparaison par paires, parce qu’une colonne qui ne tolère que des résidus hydrophobes le dit, là où une séquence unique ne le peut pas.
Exemples
Exemple 5.7 (Identité, similitude et zone crépusculaire)
Deux séquences protéiques aléatoires alignées de façon optimale avec des brèches atteignent par hasard d’identité. Au-dessus de d’identité sur une centaine de résidus, deux protéines sont presque sûrement homologues ; entre et s’étend la zone crépusculaire, où l’identité seule ne peut trancher et où les statistiques ci-dessous doivent le faire. Des homologues peuvent tomber bien en deçà de la zone : les sous-unités de l’hémoglobine et la myoglobine partagent d’identité, le lysozyme et l’-lactalbumine , et bien des paires de protéines de même repliement en partagent moins de , détectables seulement en comparant des profils ou des structures.
Exemple 5.10 (Lire une valeur E)
Une requête de résidus contre une base de résidus donne . Une correspondance de score bits a : c’est presque certainement un homologue. Une correspondance à a : onze scores de ce niveau sont attendus par hasard, et la correspondance ne veut rien dire. Le même alignement, au même score en bits, cherché dans une base dix fois plus grande, a un dix fois plus grand — la signification est une propriété de la recherche, non de la paire. Le seuil d’usage courant est pour un homologue sûr ; – mérite un second examen par une méthode de profil.