Biologi Universitas — Tahun 3 · Bachelor Year 3
5Bioinformatika dan Analisis Urutan
Seorang ahli biologi yang baru saja mengurutkan sebuah gen dari cacing laut dalam menempelkan asam aminonya ke sebuah formulir daring dan, tiga detik kemudian, mengetahui bahwa proteinnya adalah sepupu jauh sebuah kinase manusia, dengan keidentikan sepanjang residu dan peluang bahwa kemiripan itu kebetulan. Di balik ketiga detik itu terdapat algoritma pemrograman dinamis dari tahun 1970, teori statistika penjajaran acak, matriks substitusi yang disaring dari ribuan famili protein, dan sebuah pangkalan data berisi sekitar seratus miliar residu. Bab ini membahas penalaran di dalam kotak itu: bagaimana dua urutan dijajarkan sehingga penjajarannya terbukti yang terbaik, bagaimana skornya dibuat bermakna, bagaimana kecocokan dibedakan dari kebetulan, dan bagaimana pola ditemukan di dalam genom yang belum pernah dilihat siapa pun. Matematikanya sederhana — sebuah rekurensi, sebuah logaritma, sebuah sebaran Poisson — dan layak diketahui, karena setiap kesimpulan yang ditarik dari perbandingan urutan bertumpu padanya.
5.1 Menjajarkan dua urutan
Definisi 5.1 (Penjajaran dan skor)
Sebuah penjajaran dua urutan menuliskan keduanya bersusun, dengan celah (–) yang disisipkan sehingga tiap lajurnya memasangkan satu residu dengan satu residu atau satu residu dengan sebuah celah, dan tak ada lajur yang memasangkan dua celah. Skornya adalah jumlah atas lajurnya berupa skor substitusi bagi tiap pasangan residu ditambah sebuah denda celah bagi tiap celah: denda linear tiap kedudukan celah, atau, secara lebih masuk akal, denda afin bagi deretan celah, dengan ongkos pembukaan lebih besar daripada ongkos perpanjangan , karena satu sisipan berisi beberapa residu merupakan satu peristiwa evolusi tunggal. Sebuah penjajaran global meliputi kedua urutannya dari ujung ke ujung; sebuah penjajaran lokal mencari pasangan subuntai berskor tertinggi lalu mengabaikan sisanya, dan itulah yang diinginkan ketika sebuah domain bersama duduk di dalam dua protein yang selebihnya tak berkerabat.
Teorema 5.2 (Needleman–Wunsch)
Misalkan dan , dengan denda celah linear . Definisikan sebagai skor terbaik penjajaran global kedua awalan dan . Maka , , dan untuk
adalah skor global optimumnya, penjajaran optimumnya dipulihkan dengan menelusuri balik dari pilihan yang menghasilkan tiap maksimumnya, dan seluruh perhitungannya memakan langkah. Varian Smith–Waterman bagi penjajaran lokal menambahkan sebagai pilihan keempat di dalam maksimumnya, menetapkan batasnya menjadi , lalu membaca jawabannya pada entri terbesar tabelnya.
Bukti. Tinjaulah lajur terakhir penjajaran mana pun atas kedua awalan itu. Lajur itu salah satu dari tiga hal: di atas , di atas sebuah celah, atau sebuah celah di atas . Membuangnya meninggalkan penjajaran , atau , atau , yang skornya paling banyak sebesar pasangan itu; dan sebaliknya tiap penjajaran optimum tersebut dapat diperpanjang dengan lajur terakhir yang bersesuaian. Jadi skor terbaik yang berakhir pada tiap macam lajur adalah pasangan yang lebih pendek ditambah skor lajurnya, dan optimumnya adalah yang terbesar di antara ketiganya. Batasnya terpaksa demikian (hanya celah yang mungkin berhadapan dengan awalan kosong). Induksi atas mengisi tabelnya; cacah selnya . Bagi penjajaran lokal, pilihan tambahan berarti “mulailah penjajaran baru di sini”, yang menjadikan skor terbaik penjajaran yang berakhir di , dan penjajaran lokal terbaik berakhir di suatu tempat. ∎
Contoh 5.3 (Sebuah tabel empat kali tiga)
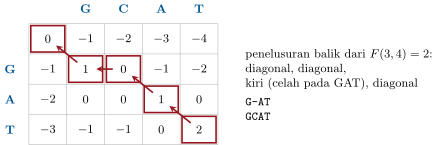
Jajarkan GAT dengan GCAT, dengan skor bagi kecocokan, bagi ketakcocokan, dan . Batasnya sepanjang atas dan sepanjang sisinya. Mengisi baris demi baris: , , , ; , , , ; , , , . Optimumnya , dan penelusuran baliknya — diagonal dari (T,T), diagonal dari (A,A), lalu ke kiri dari (G,C) ke (G,G), lalu diagonal — memberi
tiga kecocokan dan satu celah: .
Metode 5.4 (Menjajarkan dua urutan)
(1) Pilihlah skornya: sebuah matriks substitusi yang cocok dengan penyimpangan yang diharapkan (BLOSUM62 bagi protein yang jaraknya tak diketahui; kecocokan/ketakcocokan bagi DNA), dan denda celah afin (lazimnya buka , perpanjang dengan BLOSUM62). (2) Putuskanlah global atau lokal: global bagi dua urutan yang diyakini homolog sepanjang seluruhnya, lokal bagi selainnya. (3) Isilah tabelnya dengan rekurensinya, sambil menyimpan bagi tiap sel sebuah penunjuk ke pilihan yang memberi maksimumnya. (4) Telusurilah balik dari (global) atau dari sel maksimumnya sampai sebuah nol (lokal), sambil menuliskan penjajarannya dari kanan ke kiri. (5) Nilailah hasilnya bukan dari skor mentahnya melainkan dari kebermaknaan statistiknya (di bawah), dan lihatlah hasilnya: celah yang panjang, deretan berkerumitan rendah, dan penjajaran yang terkurung di dalam sebuah ulangan adalah tanda bahaya.
5.2 Pemberian skor: berapa nilai sebuah kecocokan
Definisi 5.5 (Matriks substitusi)
Sebuah matriks substitusi memberi bagi tiap pasangan asam amino sebagai skor log-ods:
dengan frekuensi ditemukannya dan terjajar di dalam penjajaran protein berkerabat yang tepercaya, frekuensi terpasangkannya keduanya secara kebetulan, dan sebuah skala yang dipilih agar entrinya menjadi bilangan bulat yang praktis. Skor positif berarti pasangannya lebih sering muncul pada homolog daripada secara kebetulan; skor keidentikannya terbesar bagi asam amino yang langka (triptofan , sisteina pada BLOSUM62) dan terkecil bagi yang lazim (leusina , alanina ), dan substitusi konservatif (isoleusina–valina ) berskor positif sedangkan yang radikal (triptofan–glisina ) berskor negatif. Matriks PAM (Dayhoff, 1978) diturunkan dari protein yang berkerabat dekat lalu diekstrapolasi ke jarak yang lebih jauh dengan perkalian matriks; matriks BLOSUM (Henikoff dan Henikoff, 1992) dicacah langsung di dalam blok urutan terjajar yang dikelompokkan pada keidentikan tertentu — BLOSUM62 dari blok pada — dan menjadi bakunya karena matriks itu diukur, bukan diekstrapolasi, pada jarak tempat ia dipakai.
Proposisi 5.6 (Mengapa log-ods)
Agar sebuah skema pemberian skor dapat dipakai pada penjajaran lokal, harapan skor sebuah lajur yang terpasangkan secara acak, , harus negatif, dan sebagian skornya harus positif; kalau tidak, penjajaran acak akan tumbuh tanpa batas dan segmen berskor tertinggi akan menjadi seluruh urutannya. Dengan syarat itu, skema semacam apa pun setara dengan skema log-ods bagi suatu frekuensi sasaran — penjajaran yang akan ditemukannya sebagai optimum adalah penjajaran yang pasangan residunya tersebar seperti . Memilih matriksnya karena itu berarti memilih penyimpangan yang hendak dideteksi: matriks bagi kerabat dekat (BLOSUM80, PAM30) berpositif lebih tajam dan bernegatif lebih keras, matriks bagi kerabat jauh (BLOSUM45, PAM250) lebih rata.
Bukti. Diterima tanpa bukti pada tingkat ini. ∎
Contoh 5.7 (Keidentikan, kemiripan, dan zona remang)
Dua urutan protein acak yang dijajarkan secara optimum dengan celah mencapai sekitar keidentikan secara kebetulan. Di atas keidentikan sepanjang seratus residu, dua protein hampir pasti homolog; antara dan terletak zona remang, tempat keidentikan sendirian tak dapat memutuskan dan statistika di bawah harus memutuskannya. Homolog dapat jatuh jauh di bawah zona itu: subunit hemoglobin dan mioglobin berbagi keidentikan, lisozim dan -laktalbumin , dan banyak pasangan protein berlipatan sama berbagi kurang dari , yang hanya terdeteksi dengan membandingkan profil atau struktur.
5.3 Menelusuri pangkalan data
Definisi 5.8 (BLAST)
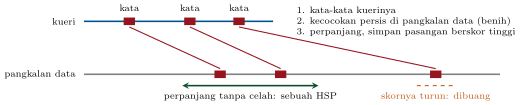
Menjajarkan sebuah kueri berisi residu terhadap pangkalan data berisi residu dengan pemrograman dinamis penuh akan memakan pembaruan sel tiap penelusuran. BLAST (Altschul dan rekan, 1990) menukar sedikit kepekaan demi kecepatan seribu kali lipat lewat tiga langkah: (1) daftarkanlah kata kuerinya (tiga residu bagi protein, sebelas basa bagi DNA) beserta tetangganya yang berskor tinggi; (2) pindailah pangkalan datanya untuk mencari kecocokan kata yang persis — benih; (3) perpanjanglah tiap benih ke kedua arah tanpa celah sampai skornya turun sejumlah tertentu di bawah skor terbaiknya, sambil menyimpan pasangan segmen berskor tinggi (HSP), lalu sambungkanlah HSP yang berdekatan dengan pemrograman dinamis bercelah di dalam sebuah pita sempit. Homolog yang sungguhan hampir selalu memuat sedikitnya satu kata tiga residu yang persis sama; kemiripan kebetulan jarang memuatnya, dan tak pernah diperpanjang.
Teorema 5.9 (Statistika sebuah kecocokan kebetulan)
Bagi sebuah kueri sepanjang yang ditelusurkan pada pangkalan data sepanjang seluruhnya, dengan skema pemberian skor yang harapan skornya negatif, cacah penjajaran lokal tanpa celah yang berskor sedikitnya dan timbul secara kebetulan tersebar Poisson dengan rata-rata
dengan dan hanya bergantung pada skema pemberian skor dan frekuensi residunya ( adalah skala matriks log-odsnya). adalah nilai harapan skor . Dengan menuliskan skornya dalam bit, , rumusnya menjadi , dan peluang bahwa sedikitnya satu penjajaran kebetulan mencapai adalah , yang sama dengan ketika kecil.
Bukti sebagian. Ekor eksponensialnya adalah teorema Karlin–Altschul dan diterima tanpa bukti: skor segmen maksimal sebuah jalan acak berhanyutan negatif memiliki sebaran yang ekornya meluruh sebagai , dengan akar positif — yang justru persamaan yang membuat matriks log-odsnya taat asas. Dengan ekor itu, sisanya tinggal menghitung. Segmen berskor tinggi dapat mulai pada salah satu dari pasangan kedudukan, segmen itu langka, dan hampir saling bebas; cacah segmen yang melampaui karena itu bersebaran Poisson dengan rata-rata sebanding dengan dan dengan peluang ekornya, . Peluang tak satu pun adalah . Penggantian skor bitnya sekadar aljabar: . Bagi penjajaran bercelah, bentuk yang sama berlaku dengan dan ditaksir lewat simulasi. ∎
Contoh 5.10 (Membaca sebuah nilai-E)
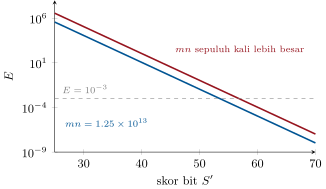
Sebuah kueri berisi residu terhadap pangkalan data berisi residu memiliki . Sebuah kecocokan berskor bit memiliki : pada dasarnya pasti homolog. Kecocokan dengan memiliki : sebelas skor semacam itu diharapkan muncul secara kebetulan, dan kecocokannya tak bermakna. Penjajaran yang sama, dengan skor bit yang sama, bila ditelusurkan pada pangkalan data sepuluh kali lebih besar, memiliki sepuluh kali lebih besar — kebermaknaan adalah sifat penelusurannya, bukan sifat pasangannya. Ambang yang lazim dipakai adalah bagi homolog yang meyakinkan; – pantas ditengok lagi dengan metode profil.
5.4 Profil, keadaan tersembunyi, dan motif
Definisi 5.11 (Penjajaran berganda dan profil)
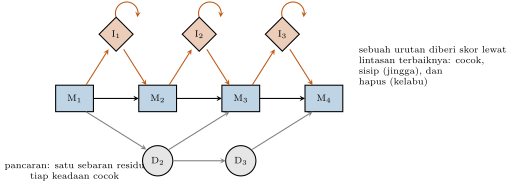
Sebuah penjajaran urutan berganda menata sebuah famili urutan menjadi lajur residu yang homolog. Pemrograman dinamis yang eksak atas urutan berbiaya dan mustahil di atas tiga urutan; program yang praktis menjajarkan secara berangsur, mula-mula pasangan terdekat menurut pohon pemandu, lalu urutan dan kelompok dijajarkan pada penjajaran yang sedang tumbuh, dengan beberapa putaran penghalusan. Penjajaran yang rampung diringkaskan sebagai sebuah profil: bagi tiap lajur, frekuensi tiap residu dan frekuensi celahnya. Sebuah model Markov tersembunyi berprofil memformalkan hal itu sebagai rantai keadaan cocok, satu keadaan tiap lajur yang lestari, yang masing-masing memancarkan residu dengan peluangnya sendiri, dengan keadaan sisip dan keadaan hapus yang membolehkan residu tambahan atau residu yang hilang pada tiap kedudukan; model sebuah famili (sebuah entri Pfam) memberi skor pada urutan baru lewat peluang lintasan terbaiknya melalui keadaannya, dan menemukan homolog jauh di bawah zona remang perbandingan berpasangan, karena sebuah lajur yang hanya mentoleransi residu hidrofob mengatakannya, sedangkan satu urutan tunggal tidak.
Definisi 5.12 (Motif dan kandungan informasi)
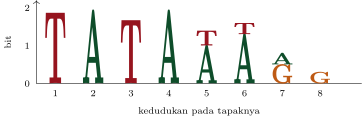
Sebuah motif adalah pola pendek — sebuah tapak faktor transkripsi, sebuah isyarat sambung, sebuah tapak fosforilasi — yang diwakili sebuah matriks bobot posisi berisi frekuensi tiap basa atau residu pada tiap kedudukan . Kandungan informasi kedudukan adalah bit bagi DNA, dengan entropinya: bit bagi basa yang tetap, bagi kedudukan yang keempat basanya sama mungkin. Totalnya digambarkan sebagai logo urutan, tiap kedudukan berupa tumpukan huruf yang tinggi totalnya dan hurufnya diukur menurut frekuensinya.
Proposisi 5.13 (Berapa informasi yang dibutuhkan sebuah tapak)
Sebuah tapak yang harus ditemukan kali di dalam genom berisi kedudukan, dan tak di tempat lain, menuntut kira-kira bit kandungan informasi: motifnya harus menciutkan kedudukan calon menjadi kedudukan yang sungguhan, dan tiap bit memparuhkan calonnya. Motif teramati milik pengatur bakteri yang telah dikaji baik cocok dengan ramalan ini — tapak E. coli bagi sebuah penekan yang mengikat beberapa lusin tempat di dalam genom mengusung bit; motif faktor transkripsi eukariot, pada bit di dalam genom , tak dapat menentukan sasarannya sendirian, dan itulah sebabnya faktor itu bekerja dalam gabungan dan di dalam kromatin terbuka Bab 1.
Bukti. Sebuah kedudukan acak cocok dengan motif berkandungan informasi dengan peluang kira-kira (tiap bit kekhasan memparuhkan peluangnya), sehingga harapan cacah kecocokan kebetulan pada kedudukan adalah . Agar tapak yang sungguhan menonjol, cacah itu harus berorde atau kurang: , yakni . ∎
Contoh 5.14 (Harapan cacah kecocokan kebetulan)
Sebuah tapak restriksi berbasa tetap enam memiliki bit dan cocok dengan kedudukan acak dengan peluang : kira-kira kali di dalam genom E. coli yang dibaca pada kedua untainya (tapaknya palindromik, jadi sekali tiap kedudukan), dan kali di dalam genom manusia. Sebuah faktor eukariot yang motifnya mengusung bit cocok dengan juta kedudukan di dalam genom manusia, beberapa ribu kali lebih banyak daripada gen yang diaturnya. Sebuah motif sendirian adalah peramal yang lemah di dalam genom yang besar; keadaan kromatinnya, motif tetangganya, dan kelestarian tapaknya antarspesies itulah yang membuat sebuah ramalan.
5.5 Dari urutan ke fungsi
Metode 5.15 (Menganotasi protein yang tak dikenal)
Diberikan sebuah urutan penyandi yang baru: (1) translasikanlah pada kerangka yang benar lalu periksalah adanya peptida isyarat, segmen lintas membran, dan daerah berkerumitan rendah; (2) telusurilah pangkalan data protein dengan BLAST lalu bacalah kecocokan dengan , sambil mencatat apakah penjajarannya meliputi seluruh proteinnya (sebuah ortolog yang sungguhan) atau hanya sebuah segmen (sebuah domain bersama); (3) telusurilah pangkalan data domain dengan HMM profil, yang menemukan famili yang terlewat BLAST lalu memilah proteinnya menjadi domain; (4) simpulkanlah ortologi, bukan sekadar kemiripan, dengan memeriksa apakah kecocokan terbaik pada genom yang lain berbalik memiliki kuerinya sebagai kecocokan terbaik miliknya (kecocokan terbaik timbal balik) atau dengan menempatkan proteinnya pada sebuah pohon gen (Bab 25); (5) pindahkanlah fungsi ortolognya dengan hati-hati — residu katalitik yang lestari mendukung kimia yang lestari, residu yang hilang melemahkannya — lalu ramalkanlah strukturnya; (6) perlakukanlah tiap ramalan sebagai hipotesis bagi meja kerja.
Proposisi 5.16 (Struktur dari urutan)
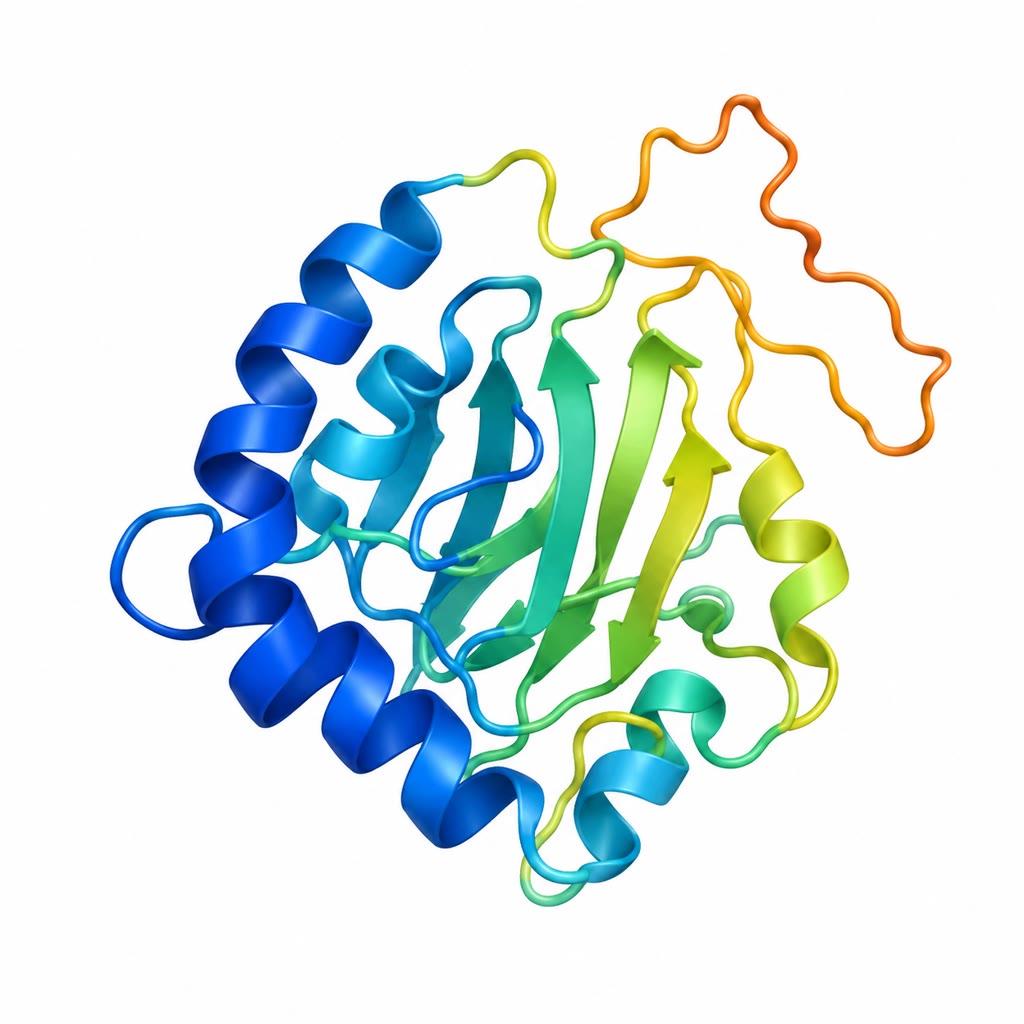
Lipatan sebuah protein ditentukan oleh urutannya (Bab 7), dan menghitungnya dari urutannya selama lima puluh tahun menjadi masalah utama bidang ini yang belum terpecahkan. Tiga pendekatan berhasil berturut-turut. Pemodelan homologi membangun struktur sebuah protein di atas struktur homolog yang telah terpecahkan, dengan andal di atas keidentikan. Analisis koevolusi memanfaatkan kenyataan bahwa dua residu yang bersentuhan di dalam lipatannya cenderung bermutasi bersama di sepanjang penjajaran berganda yang dalam, sehingga pasangan lajur yang terkopel secara statistik menjadi sentuhan yang diramalkan, dan sentuhan yang cukup banyak menentukan sebuah lipatan. Metode pembelajaran dalam yang dilatih pada seratus ribu struktur yang telah terpecahkan dan pada penjajaran semacam itu kini meramalkan sebagian besar struktur protein globular dengan kesaksamaan nyaris setara percobaan (penilaian CASP tahun 2020), dan pangkalan data menyimpan struktur ramalan bagi hampir setiap urutan protein yang dikenal. Yang kurang baik diramalkannya adalah apa yang tak tertangkap satu struktur tunggal: daerah tak teratur, konformasi alternatif, pengaruh sebuah mutasi titik, dan kompleks.
Catatan 5.17 (Batas penyimpulan)
Sebagian besar anotasi fungsi di dalam pangkalan data tak pernah diuji; semuanya dipindahkan dari sebuah homolog, yang sendirinya dianotasi lewat pemindahan. Galatnya merambat dan berlipat ganda, dan anotasi yang keliru pada protein yang banyak kaitannya dapat menulari satu famili utuh. Penawarnya adalah penawar di atas: bedakanlah ortologi dari homologi, bacalah penjajarannya, carilah residu katalitiknya, dan ingatlah bahwa “protein hipotetis” adalah label jujur yang masih pantas disandang sepertiga gen di dalam sebagian besar genom.
5.6 Latihan
Latihan 5.1 ★
Definisikanlah penjajaran global dan penjajaran lokal lalu berikanlah satu keadaan biologis yang menuntut masing-masing.
Solusi
Solusi Latihan 5.1.
Global: kedua urutannya dijajarkan dari ujung ke ujung, tiap residu berada di dalam sebuah lajur — bagi dua protein yang diyakini homolog sepanjang seluruhnya, misalnya ortolog sebuah enzim rumah tangga. Lokal: pasangan subuntai berskor terbaik, sisanya diabaikan — bagi pencarian domain bersama (sebuah domain SH2 pada dua protein pengisyarat yang selebihnya tak berkerabat), atau sebuah gen di dalam urutan genom yang panjang.
Latihan 5.2 ★
Isilah tabel Needleman–Wunsch bagi AGC terhadap AAC dengan kecocokan , ketakcocokan , celah , lalu berikan penjajaran dan skor optimumnya.
Solusi
Solusi Latihan 5.2.
Batasnya pada kedua arah. Baris A: . Baris G: . Baris C: . Optimumnya : AGC di atas AAC tanpa celah (cocok, tak cocok, cocok: ).
Latihan 5.3 ★
Pada BLOSUM62, triptofan–triptofan berskor dan leusina–leusina . Jelaskanlah dari rumus log-ods mengapa keidentikan residu yang lebih langka bernilai lebih tinggi.
Solusi
Solusi Latihan 5.3.
. Triptofan itu langka (), sehingga peluang dua triptofan terjajar secara acak, , sangat kecil, dan pasangan triptofan yang lestari menjadi tanda homologi yang jauh lebih kuat daripada pasangan leusina yang lestari (); nisbah log-odsnya pun sebanding lebih besar.
Latihan 5.4 ★
Apa itu nilai-E? Sebuah penelusuran memberi kecocokan dengan . Apa arti angka itu, dan apakah kecocokannya sebuah homolog?
Solusi
Solusi Latihan 5.4.
Nilai-E adalah cacah penjajaran berskor sedikitnya setinggi itu yang akan diharapkan muncul secara kebetulan pada penelusuran kueri ini terhadap pangkalan data seukuran ini. berarti tiga skor semacam itu diharapkan muncul secara kebetulan: kecocokannya bukan bukti homologi (boleh jadi ia memang homolog, tetapi penelusurannya tak dapat memutuskan).
Latihan 5.5 ★★
Sebuah kueri berisi residu ditelusurkan pada residu. Hitunglah nilai-E kecocokan dengan skor bit , , dan . Skor bit berapa yang memberi ? Bagaimana jawabannya berubah bila kuerinya sepanjang residu?
Solusi
Solusi Latihan 5.5.
. ; ; . menuntut bit. Kueri berisi residu memiliki sepuluh kali lebih kecil, : bit memadai — tetapi kueri pendek jarang mencapai bahkan angka itu.
Latihan 5.6 ★★
Hitunglah kandungan informasi sebuah motif yang keempat kedudukannya berfrekuensi basa (A, C, G, T) sebesar , , , dan . Berapa kecocokan kebetulan yang dimilikinya di dalam genom ?
Solusi
Solusi Latihan 5.6.
Kandungan informasinya: , , , dan dengan , jadi . Totalnya bit. Kecocokan kebetulannya: kedudukan pada dua untai — motifnya nyaris tak berguna sendirian.
Latihan 5.7 ★★
Jelaskanlah mengapa denda celah afin lebih masuk akal daripada denda linear, dan mengapa denda pembukaan celah yang sangat tinggi maupun yang sangat rendah sama-sama memberi penjajaran yang buruk.
Solusi
Solusi Latihan 5.7.
Sebuah sisipan berisi beberapa residu merupakan satu peristiwa mutasi, sehingga ongkosnya tak semestinya tumbuh lurus dengan panjangnya: ongkos pembukaan ditambah ongkos perpanjangan yang kecil memodelkan hal itu. Denda pembukaan yang terlalu tinggi memaksa ketakcocokan di tempat sebuah celah semestinya berada lalu salah menjajarkan segala sesuatu sesudah sebuah sisipan yang sungguhan; denda yang terlalu rendah menaburkan celah di mana-mana, memasangkan residu secara kebetulan dan menggelembungkan keidentikannya.
Latihan 5.8 ★★
Sebuah penelusuran BLAST atas sebuah protein manusia pada pangkalan data lalat memberi kecocokan terbaik dengan yang meliputi residu 50–180 kuerinya yang berisi residu. Apakah protein lalat itu ortolog protein manusia tersebut? Uji lanjutan apa yang akan Anda kerjakan?
Solusi
Solusi Latihan 5.8.
Belum tentu: penjajarannya meliputi segmen berisi residu, yang merupakan ciri khas domain bersama, bukan ciri ortolog yang terjajar sepanjang seluruhnya. Ujinya: telusurkanlah protein lalatnya kembali pada proteom manusia (apakah kuerinya menjadi kecocokan terbaiknya, sepanjang seluruhnya?), kenalilah domainnya dengan HMM profil, lalu bangunlah sebuah pohon gen famili itu pada beberapa spesies.
Latihan 5.9 ★★
Mengapa metode profil mendeteksi homolog yang terlewat penjajaran berpasangan? Berikanlah sebuah contoh pola lajur yang tertangkap profil tetapi tak tertangkap satu urutan tunggal.
Solusi
Solusi Latihan 5.9.
Sebuah profil mencatat, lajur demi lajur, apa yang ditoleransi familinya: sebuah kedudukan yang selalu hidrofob tetapi tak pernah residu yang sama, sebuah residu katalitik yang tetap, sebuah kedudukan yang selalu berupa celah pada separuh familinya. Penjajaran berpasangan memberi skor tiap residu terhadap satu residu lain saja dan tak dapat mengetahui bahwa sebuah valina pada kedudukan 40 “sama baiknya dengan” isoleusina yang ada di situ pada kuerinya. Profilnya juga membobot lajur yang lestari, sehingga kemiripan lemah yang terpusat di tempat familinya lestari menjadi bermakna.
Latihan 5.10 ★★★
Tunjukkanlah bahwa di bawah skema pemberian skor yang harapan skornya positif, penjajaran lokal Smith–Waterman dua urutan acak yang panjang memiliki skor yang tumbuh lurus dengan panjangnya, lalu jelaskan mengapa hal itu membuat teori nilai-E gagal. Apa yang tersirat dari hal itu bagi penjajaran DNA dengan kecocokan dan ketakcocokan pada kandungan GC ?
Solusi
Solusi Latihan 5.10.
Dengan harapan skor tiap lajur, skor kumulatif sepanjang diagonal dua urutan acak merupakan jalan acak berhanyutan positif: sesudah lajur skornya kira-kira , sehingga penjajaran lokal terbaiknya pada dasarnya seluruhnya dan skornya tumbuh sebagai , bukan sebagai . Teori Karlin–Altschul, yang menuntut hanyutan negatif agar skor tinggi menjadi penyimpangan yang langka, tak berlaku dan tak ada yang ada. Bagi DNA pada GC, peluang sebuah kecocokan adalah , sehingga harapan skornya : masih negatif, dan statistikanya berlaku; tetapi skema semacam kecocokan , ketakcocokan akan berharapan dan akan melaporkan seluruh genomnya sebagai satu penjajaran.
Latihan 5.11 ★★★
Tabel Needleman–Wunsch menuntut sel ingatan; bagi dua kromosom jumlahnya . Uraikanlah dua gagasan yang dipakai penjajar genom untuk menghindarinya (benih dan perangkaian; pemitaan), dan apa yang dikorbankan masing-masing.
Solusi
Solusi Latihan 5.11.
Benih dan perangkaian: carilah kecocokan -mer yang persis atau hampir persis antara kedua urutannya dengan tabel hash, simpanlah yang berbaris pada diagonal yang taat asas, rangkaikanlah, lalu jalankanlah pemrograman dinamis hanya pada celah di antara benih yang terangkai; cara itu mengorbankan penjajaran di daerah yang tanpa benih (bentangan yang sangat menyimpang). Pemitaan: bila kedua urutannya diketahui nyaris segaris, hitunglah hanya sel di dalam pita selebar di sekitar diagonalnya, dengan biaya alih-alih ; cara itu mengorbankan penjajaran mana pun yang sisipannya lebih besar daripada pitanya.
Latihan 5.12 ★★★
Sebuah HMM pencari gen bagi bakteri memiliki keadaan bagi ketiga kedudukan kodonnya dan bagi DNA tak penyandi. Jelaskanlah bagaimana modelnya dapat membedakan urutan penyandi dari yang tak penyandi tanpa keterangan kodon henti sama sekali (tinjaulah pemakaian kodonnya), dan mengapa pendekatan yang sama jauh lebih sukar pada genom manusia.
Solusi
Solusi Latihan 5.12.
Urutan penyandi berperiode tiga: ketiga kedudukan kodonnya memiliki komposisi basa yang berbeda (kedudukan ketiganya paling bias), dan pemakaian kodonnya tak merata pada tiap spesies. Sebuah model dengan tiga keadaan penyandi yang berurutan, yang masing-masing memancarkan basa dengan komposisi kedudukan kodon itu, memberi DNA penyandi peluang yang lebih tinggi daripada yang diberikan keadaan tak penyandi, sepanjang jendela beberapa lusin kodon, bahkan tanpa kodon henti. Di dalam genom manusia eksonnya pendek (), terpisah oleh intron sepanjang kilobasa, sehingga isyarat penyandinya singkat dan terputus; modelnya harus pula mengenali tapak sambung, yang isyaratnya lemah, dan urutan tak penyandi yang begitu banyak menghasilkan banyak segmen penyandi palsu.
5.7 Soal: Sebuah Urutan dari Laut Dalam
Soal 5.1
Soal akhir pekan — sebuah protein tak dikenal yang dijajarkan dengan tangan, ditelusurkan pada pangkalan data lalu dihitung kebermaknaannya, motif pengaturnya ditimbang dalam bit, dan gennya diperiksa terhadap statistika kerangka baca terbuka acak, berakhir pada nilai-E kecocokan terbaiknya, bit yang dibutuhkan sebuah tapak, dan panjang yang harus dimiliki sebuah kerangka baca agar dipercaya
Data: sebuah protein berisi residu dari anelida laut dalam. Pangkalan data protein: residu. Genom cacingnya: , GC. Pemberian skor bagi penjajaran dengan tangan: kecocokan , ketakcocokan , celah . Skor bit kecocokan BLAST terbaiknya: ; kecocokan kesepuluhnya: .
Bagian I — Dengan tangan.
- Jajarkanlah peptida KQT dan KAQT dengan rekurensi Needleman–Wunsch: tulislah tabelnya lalu berikan penjajaran dan skor optimumnya.
- Ulangilah dengan Smith–Waterman (lokal) bagi GATCAT terhadap ACAT: carilah penjajaran lokal terbaiknya dan skornya.
- Berapa pembaruan sel yang dibutuhkan penjajaran global protein berisi residu itu terhadap protein berisi residu? Terhadap seluruh pangkalan datanya?
- Bila sebuah komputer melakukan pembaruan tiap detik, berapa lama penjajaran pangkalan data penuh pertanyaan 3 memakan waktu? Mengapa BLAST dipakai sebagai gantinya?
- Skor keidentikan BLOSUM62 adalah bagi alanina () dan bagi triptofan (). Dengan (satuan setengah bit), hitunglah frekuensi sasaran dan , serta nisbah bagi masing-masing. Tafsirkanlah.
- Dua protein berbagi keidentikan sepanjang residu. Katakanlah mengapa keidentikan sendirian tak dapat memutuskan homologi di sini dan apa yang dapat memutuskannya.
Bagian II — Penelusurannya.
- Hitunglah bagi kuerinya terhadap pangkalan datanya, dan .
- Hitunglah nilai-E kecocokan terbaiknya () dan kecocokan kesepuluhnya ().
- Skor bit berapa yang bersesuaian dengan bagi penelusuran ini? Dengan ?
- Kecocokan terbaik yang sama ditemukan ketika pangkalan datanya telah tumbuh menjadi residu. Berapa nilai-E-nya?
- Kecocokan kesepuluhnya menjajarkan residu 200–260 kuerinya dengan keidentikan sepanjang residu. Dengan nilai-E-nya, katakanlah apakah hal itu menjadi bukti homologi, dan apa yang dapat ditambahkan penelusuran profil.
- Kecocokan terbaiknya adalah sebuah kinase manusia, yang terjajar sepanjang residu 10–290. Kecocokan terbaiknya di dalam proteom cacing itu adalah kuerinya. Apa yang ditegakkan uji timbal balik ini, dan apa yang tidak?
Bagian III — Sebuah motif.
- Di hulu gennya terletak sebuah calon tapak faktor transkripsi berkedudukan delapan dengan kandungan informasi bit. Berapa totalnya?
- Berapa kecocokan kebetulan yang dimiliki motif itu di dalam genom (kedua untainya, kedudukan)?
- Faktornya mengatur sekitar gen. Berapa bit yang dibutuhkan sebuah motif untuk menentukan tapak sendirian di dalam genom ini?
- Berapa banyak kekurangannya yang dapat dipasok sebuah motif kedua yang bersebelahan dan berisi bit, bila keduanya harus muncul bersama di dalam jarak yang tetap?
- Sebuah kedudukan berfrekuensi bagi (A, C, G, T): hitunglah entropinya dan kandungan informasinya.
- Jelaskanlah, dengan argumen informasi itu, mengapa faktor transkripsi bakteri lazimnya memiliki tapak yang lebih panjang dan lebih lestari daripada faktor eukariot.
Bagian IV — Gennya sendiri.
- Di dalam DNA acak yang komposisi basanya seragam, berapa peluang sebuah kodon menjadi kodon henti? Berapa harapan cacah kodon sebelum sebuah kodon henti muncul (sebaran geometrik)?
- Genom cacingnya GC. Hitunglah ulang peluang bahwa sebuah kodon acak adalah kodon henti (TAA, TAG, TGA) dengan frekuensi basa yang sesungguhnya, dan harapan panjang kerangka bacanya. Ke arah mana kandungan GC yang rendah mendorong pencarian gen?
- Berapa peluang bahwa sebuah kerangka baca terbuka acak sedikitnya sepanjang kodon? Sedikitnya ?
- Di dalam genom itu, enam kerangka pada dua untai memberi sekitar awalan kodon. Berapa kerangka baca terbuka acak sepanjang sedikitnya kodon yang diharapkan? Berapa yang sedikitnya ?
- Jelaskanlah mengapa “kerangka baca terbuka yang lebih panjang daripada kodon” menjadi pencari gen yang berguna pada sebuah bakteri tetapi tidak pada genom ini, dan apa yang dipakai pencari gen eukariot sebagai gantinya.
- Gen cacing itu memiliki enam ekson yang rata-rata . Jelaskanlah bagaimana bacaan pengurutan RNA menguraikan struktur eksonnya yang ditinggalkan taksa oleh urutan genom saja.
- Ringkaskanlah: nilai-E kecocokan terbaiknya (pertanyaan 8), bit yang dibutuhkan untuk menentukan tapak (pertanyaan 15), dan harapan cacah kerangka baca acak sepanjang kodon di dalam genomnya (pertanyaan 22).
Solusi
Solusi Soal 5.1.
1. Baris K, Q, T; lajur K, A, Q, T; batasnya dan . Baris K: ; baris Q: ; baris T: . Optimumnya : K-QT di atas KAQT. 2. Skor lokal terbaiknya : CAT terhadap CAT (residu 4–6 GATCAT dengan 2–4 ACAT); ATCAT terhadap A-CAT pun berskor . 3. pembaruan; terhadap pangkalan datanya . 4. s, sepuluh jam tiap kueri; benih BLAST melompati hampir seluruh tabelnya dan menjawab dalam hitungan detik. 5. . Alanina: , , nisbahnya . Triptofan: , , nisbahnya . Sepasang triptofan yang terjajar kali lebih sering pada homolog daripada secara kebetulan, sepasang alanina hanya empat kali; namun pasangan alanina lebih banyak secara mutlak karena alanina memang lazim. 6. terletak di zona remang, tempat penjajaran acak mencapai ; nilai-E penjajarannya, motif lestari pada kedudukan yang tepat, kecocokan HMM profil dengan famili yang dikenal, atau lipatan bersama akan memutuskannya. 7. ; . 8. ; . 9. pada bit; pada bit. 10. Sepuluh kali : , masih sangat meyakinkan. 11. Dengan , kecocokan kesepuluhnya adalah apa yang dihasilkan kebetulan; keidentikan sepanjang residu bukan bukti. Penelusuran profil atas residu 200–260 pada pangkalan data domain dapat memperlihatkan apakah segmen itu sebuah domain yang dikenal, dengan statistika yang tak dimiliki perbandingan berpasangan. 12. Kecocokan terbaik timbal balik sepanjang seluruhnya selaras dengan ortologi satu lawan satu; keduanya tidak membuktikannya — sebuah penggandaan pada satu garis keturunan sesudah perpisahannya memberi dua koortolog, dan hilangnya ortolog yang sungguhan dapat meninggalkan sebuah paralog sebagai kecocokan terbaiknya. Sebuah pohon gen dengan beberapa spesies adalah ujinya. 13. bit. 14. kecocokan kebetulan. 15. bit. 16. Kemunculan bersama pada jarak tetap menambahkan bitnya: , yang memasok dari bit yang hilang; kira-kira bit (faktor pada kecocokan kebetulan) harus datang dari tempat lain — keterjangkauan kromatin, mitra yang lain. 17. bit; bit. 18. Sebuah faktor bakteri harus menemukan tapaknya yang sedikit di dalam genom tanpa bantuan kromatin: ia menuntut sekitar bit, dan tapaknya panjang serta lestari. Genom eukariot seribu kali lebih besar, sehingga menuntut sepuluh bit lagi, namun faktornya bertapak pendek; kekhasannya dicapai lewat gabungan dan lewat pembatasan pada kromatin yang terjangkau, yang juga membuat pengaturannya lebih mudah berevolusi, karena tapak pendek mudah diperoleh atau hilang. 19. ; harapan cacah kodon sebelum sebuah kodon henti adalah . 20. , : , ; totalnya , harapan panjang kerangkanya kodon. DNA yang kaya AT penuh kodon henti, sehingga kerangka terbuka acak lebih pendek dan kerangka yang panjang lebih menonjol. 21. ; . 22. Tiap kerangka terbuka maksimal berakhir pada sebuah kodon henti, dan awalan kodon memuat kodon henti: kira-kira kerangka acak sepanjang sedikitnya kodon, dan yang sedikitnya . 23. Sebuah bakteri memiliki sekitar kodon henti dan karenanya sekitar kerangka kebetulan sepanjang kodon tetapi nyaris tak satu pun sepanjang ; gennya rata-rata kodon dan DNA-nya penyandi, sehingga kerangka terbuka yang panjang hampir selalu sebuah gen. Pada cacing itu, DNA-nya menyandi, eksonnya rata-rata kodon — lebih pendek daripada ambang kebetulannya — dan sejuta kerangka acak sepanjang kodon menenggelamkannya. Pencari gen eukariot memakai isyarat tapak sambung, bias kodon di dalam model Markov tersembunyi, homologi dengan protein yang dikenal dan, di atas segalanya, transkrip yang telah diurutkan. 24. Sebuah bacaan dari RNA duta yang tersambung terjajar pada genomnya menjadi dua keping yang dipisahkan sebuah intron: belahannya menandai kedua tapak sambungnya sampai ke basanya; cakupan bacaannya membatasi eksonnya dan bacaan berpasangan menghubungkan ekson berurutan menjadi satu transkrip, sehingga terurai tapak sambung calon mana yang terpakai. 25. bagi kecocokan terbaiknya; sekitar bit untuk menentukan tapak di dalam genomnya; sekitar kerangka baca kebetulan sepanjang kodon di dalam seluruh genomnya.