Universitaire biologie — jaar 3 · Bachelor Year 3
5Bio-informatica en sequentieanalyse
Een bioloog die zojuist een gen van een diepzeeworm heeft gesequenced plakt zijn aminozuren in een webformulier en verneemt drie seconden later dat het eiwit een verre neef van een menselijk kinase is, met identiteit over residuen en een kans dat de gelijkenis toeval is. Achter die drie seconden zitten een algoritme voor dynamisch programmeren uit 1970, een statistische theorie van toevallige uitlijningen, substitutiematrices die uit duizenden eiwitfamilies zijn gedestilleerd, en een databank van zo’n honderd miljard residuen. Dit hoofdstuk gaat over de redenering in die zwarte doos: hoe twee sequenties zo worden uitgelijnd dat de uitlijning aantoonbaar de beste is, hoe de score iets gaat betekenen, hoe een overeenkomst van een toeval wordt onderscheiden, en hoe patronen worden gevonden in een genoom waar nog niemand naar heeft gekeken. De wiskunde is elementair — een recursie, een logaritme, een poissonverdeling — en zij is de moeite waard, omdat elke conclusie uit een sequentievergelijking erop rust.
5.1 Twee sequenties uitlijnen
Definitie 5.1 (Uitlijning en score)
Een uitlijning van twee sequenties schrijft ze boven elkaar, met hiaten (–) ertussen zodat de kolommen een residu met een residu of een residu met een hiaat paren, en geen enkele kolom twee hiaten paart. Haar score is de som over de kolommen van een substitutiescore voor elk paar residuen en van een hiaatstraf voor elk hiaat: een lineaire straf per hiaatpositie, of, realistischer, een affiene straf voor een reeks van hiaten, waarbij de openingskosten groter zijn dan de verlengingskosten , omdat één insertie van verscheidene residuen één enkele evolutionaire gebeurtenis is. Een globale uitlijning beslaat beide sequenties van begin tot eind; een lokale uitlijning zoekt het hoogst scorende paar deelreeksen en negeert de rest, en dat is wat men wil wanneer een gedeeld domein in twee verder ongerelateerde eiwitten zit.
Stelling 5.2 (Needleman–Wunsch)
Zij en , met lineaire hiaatstraf . Definieer als de beste score van een globale uitlijning van de prefixen en . Dan geldt , , en voor
is de optimale globale score, een optimale uitlijning wordt teruggevonden door vanaf de keuzen terug te volgen die elk maximum opleverden, en de hele berekening kost stappen. De variant van Smith–Waterman voor lokale uitlijning voegt als vierde mogelijkheid aan het maximum toe, zet de randen op en leest het antwoord af bij de grootste waarde in de tabel.
Bewijs. Beschouw de laatste kolom van een willekeurige uitlijning van de twee prefixen. Zij is een van drie dingen: boven , boven een hiaat, of een hiaat boven . Haar weghalen laat een uitlijning over van , van , of van , waarvan de score hoogstens van dat paar is; en omgekeerd kan elk van die optimale uitlijningen met de bijbehorende laatste kolom worden verlengd. De beste score die op elk soort kolom eindigt is dus van het kortere paar plus de score van de kolom, en het optimum is de grootste van de drie. De randen liggen vast (tegenover een leeg prefix zijn alleen hiaten mogelijk). Inductie naar vult de tabel; het aantal cellen is . Bij lokale uitlijning betekent de extra mogelijkheid “begin hier een nieuwe uitlijning”, wat van de beste score maakt van een uitlijning die eindigt op , en de beste lokale uitlijning eindigt ergens. ∎
Voorbeeld 5.3 (Een tabel van vier bij drie)
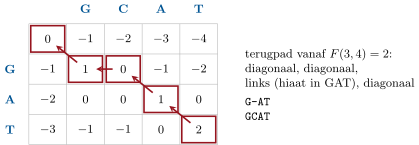
Lijn GAT uit tegen GCAT, met voor een overeenkomst, voor een verschil en . De randen zijn langs de bovenkant en langs de zijkant. Rij voor rij invullen geeft , , , ; , , , ; , , , . Het optimum is , en terugvolgen — diagonaal vanaf (T,T), diagonaal vanaf (A,A), dan naar links van (G,C) naar (G,G), dan diagonaal — geeft
drie overeenkomsten en één hiaat: .
Methode 5.4 (Twee sequenties uitlijnen)
(1) Kies de scoring: een substitutiematrix die past bij de verwachte divergentie (BLOSUM62 voor eiwitten op onbekende afstand, overeenkomst/verschil voor DNA) en affiene hiaatstraffen (met BLOSUM62 meestal openen , verlengen ). (2) Beslis globaal of lokaal: globaal voor twee sequenties die over hun hele lengte homoloog worden geacht, lokaal in de overige gevallen. (3) Vul de tabel met de recursie, en bewaar bij elke cel een verwijzing naar de keuze die haar maximum gaf. (4) Volg terug vanaf (globaal) of vanaf de maximale cel tot een nul (lokaal), en schrijf de uitlijning van rechts naar links. (5) Beoordeel het resultaat niet naar zijn ruwe score maar naar zijn statistische significantie (hieronder), en kijk ernaar: lange hiaten, reeksen met weinig complexiteit en uitlijningen die tot een herhaling beperkt blijven zijn waarschuwingen.
5.2 Scoren: wat een overeenkomst waard is
Definitie 5.5 (Substitutiematrices)
Een substitutiematrix geeft voor elk paar aminozuren als een log-oddsscore:
waarin de frequentie is waarmee en uitgelijnd worden aangetroffen in betrouwbare uitlijningen van verwante eiwitten, de frequentie waarmee zij door toeval zouden worden gepaard, en een schaal die zo is gekozen dat de waarden handige gehele getallen worden. Een positieve score betekent dat het paar vaker in homologen voorkomt dan door toeval; de identiteitsscores zijn het grootst voor zeldzame aminozuren (tryptofaan , cysteïne in BLOSUM62) en het kleinst voor veelvoorkomende (leucine , alanine ), en behoudende substituties (isoleucine–valine ) scoren positief terwijl ingrijpende (tryptofaan–glycine ) negatief scoren. De PAM-matrices (Dayhoff, 1978) werden afgeleid uit nauw verwante eiwitten en door matrixvermenigvuldiging naar grotere afstanden geëxtrapoleerd; de BLOSUM-matrices (Henikoff en Henikoff, 1992) werden rechtstreeks geteld in blokken uitgelijnde sequenties die op een gegeven identiteit waren geclusterd — BLOSUM62 uit blokken bij — en zij zijn de standaard omdat zij gemeten zijn en niet geëxtrapoleerd, op de afstand waar zij worden gebruikt.
Propositie 5.6 (Waarom log-odds)
Wil een scoringsschema bij lokale uitlijning bruikbaar zijn, dan moet de verwachte score van een willekeurig gepaarde kolom, , negatief zijn en moeten sommige scores positief zijn; anders zouden toevallige uitlijningen onbegrensd groeien en zou het hoogst scorende segment de hele sequentie zijn. Onder die voorwaarde is elk zulk schema gelijkwaardig aan een log-oddsschema voor zekere doelfrequenties — de uitlijningen die het als optimaal zal vinden zijn die waarvan de residuparen als zijn verdeeld. De matrix kiezen is dus de divergentie kiezen die men verwacht op te sporen: een matrix voor nauwe verwanten (BLOSUM80, PAM30) heeft scherpere positieve en hardere negatieve waarden, een matrix voor verre verwanten (BLOSUM45, PAM250) is vlakker.
Bewijs. Op dit niveau zonder bewijs aangenomen. ∎
Voorbeeld 5.7 (Identiteit, gelijkenis en de schemerzone)
Twee willekeurige eiwitsequenties die optimaal met hiaten worden uitgelijnd halen door toeval ongeveer identiteit. Boven identiteit over honderd residuen zijn twee eiwitten vrijwel zeker homoloog; tussen en ligt de schemerzone, waar identiteit alleen niets kan beslissen en de statistiek hieronder dat moet doen. Homologen kunnen ver onder de zone vallen: de subeenheden van hemoglobine en myoglobine delen identiteit, lysozym en -lactalbumine , en veel paren eiwitten met dezelfde vouwing delen minder dan , alleen op te sporen door profielen of structuren te vergelijken.
5.3 Een databank doorzoeken
Definitie 5.8 (BLAST)
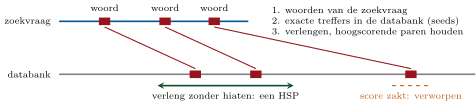
Een zoekvraag van residuen tegen een databank van uitlijnen met volledig dynamisch programmeren zou celbewerkingen per zoekactie kosten. BLAST (Altschul en collega’s, 1990) ruilt een beetje gevoeligheid in voor duizendvoudige snelheid met drie stappen: (1) maak een lijst van de woorden van de zoekvraag (drie residuen voor eiwitten, elf basen voor DNA) en van hun hoogscorende buren; (2) doorzoek de databank op exacte woordtreffers — de seeds; (3) verleng elke seed in beide richtingen zonder hiaten tot de score een vastgestelde hoeveelheid onder haar beste waarde zakt, en houd de hoogscorende segmentparen (HSP’s) over, en verbind daarna nabije HSP’s met gehiaat dynamisch programmeren in een smalle band. Een echte homoloog bevat vrijwel altijd minstens één exact woord van drie residuen; een toevallige gelijkenis zelden, en die wordt nooit verlengd.
Stelling 5.9 (De statistiek van een toevallige treffer)
Voor een zoekvraag van lengte die wordt doorzocht tegen een databank van totale lengte , met een scoringsschema waarvan de verwachte score negatief is, is het aantal ongehiaatte lokale uitlijningen met een score van minstens dat door toeval ontstaat poissonverdeeld met gemiddelde
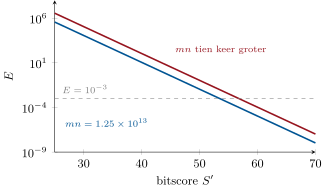
waarin en alleen van het scoringsschema en de residufrequenties afhangen ( is de schaal van de log-oddsmatrix). is de verwachtingswaarde van de score . Schrijft men de score in bits, , dan wordt de formule , en de kans dat minstens één toevallige uitlijning haalt is , wat gelijk is aan wanneer klein is.
Gedeeltelijk bewijs. De exponentiële staart is de stelling van Karlin–Altschul en wordt aangenomen: de maximale segmentscore van een toevalswandeling met negatieve drift heeft een verdeling waarvan de staart als afneemt, met de positieve wortel van — en dat is precies de vergelijking die de log-oddsmatrix consistent maakt. Gegeven die staart is de rest tellen. Hoogscorende segmenten kunnen bij elk van de paren posities beginnen, zij zijn zeldzaam en zij zijn vrijwel onafhankelijk; het aantal dat overtreft is dus poissonverdeeld met een gemiddelde dat evenredig is met en met de staartkans, . De kans op geen enkele is . De vervanging door de bitscore is algebra: . Voor gehiaatte uitlijningen geldt dezelfde vorm met en uit simulatie geschat. ∎
Voorbeeld 5.10 (Een E-waarde lezen)
Een zoekvraag van residuen tegen een databank van residuen heeft . Een treffer met een bitscore van heeft : vrijwel zeker een homoloog. Een treffer met heeft : elf zulke scores zijn door toeval te verwachten, en de treffer betekent niets. Dezelfde uitlijning, met dezelfde bitscore, tegen een tien keer grotere databank doorzocht, heeft een tien keer grotere — significantie is een eigenschap van de zoekactie, niet van het paar. De gangbare drempel is voor een betrouwbare homoloog; – verdient een tweede blik met een profielmethode.
5.4 Profielen, verborgen toestanden en motieven
Definitie 5.11 (Meervoudige uitlijning en profielen)
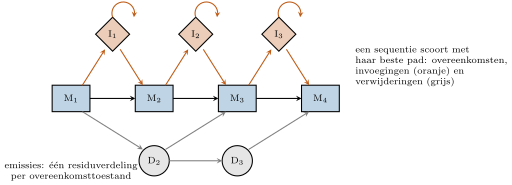
Een meervoudige sequentie-uitlijning zet een familie van sequenties in kolommen van homologe residuen. Exact dynamisch programmeren over sequenties kost en is voorbij drie onmogelijk; praktische programma’s lijnen stapsgewijs uit, eerst het naaste paar volgens een gidsboom, daarna sequenties en groepen bij de groeiende uitlijning, met ronden van verfijning. Een voltooide uitlijning wordt samengevat als een profiel: per kolom de frequentie van elk residu en van hiaten. Een profiel-HMM, een verborgen markovmodel, formaliseert dit als een keten van overeenkomsttoestanden, één per geconserveerde kolom, die elk residuen met hun eigen kansen uitzenden, met invoeg- en verwijdertoestanden die op elke positie extra of ontbrekende residuen toelaten; het model van een familie (een Pfam-vermelding) scoort een nieuwe sequentie met de kans van het beste pad door de toestanden, en vindt homologen ver onder de schemerzone van de paarsgewijze vergelijking, omdat een kolom die alleen hydrofobe residuen duldt dat ook zegt, terwijl één enkele sequentie dat niet kan.
Definitie 5.12 (Motieven en informatie-inhoud)
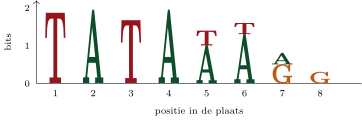
Een motief is een kort patroon — een bindingsplaats voor een transcriptiefactor, een splitssignaal, een fosforyleringsplaats — weergegeven door een positiegewichtsmatrix van de frequentie van elke base of elk residu op elke positie . De informatie-inhoud van positie is bits voor DNA, waarbij haar entropie is: bits voor een onveranderlijke base, voor een positie waar alle vier even waarschijnlijk zijn. Het totaal wordt getekend als een sequentielogo, waarbij elke positie een stapel letters is waarvan de totale hoogte is en waarvan de letters op frequentie zijn geschaald.
Propositie 5.13 (Hoeveel informatie een plaats nodig heeft)
Een plaats die keer in een genoom van posities moet worden gevonden, en nergens anders, heeft ongeveer bits informatie-inhoud nodig: het motief moet de kandidaatposities tot de echte terugbrengen, en elke bit halveert het aantal kandidaten. De waargenomen motieven van goed onderzochte bacteriële regulatoren voldoen aan die voorspelling — plaatsen in E. coli voor een repressor die enkele tientallen plekken in een genoom van bindt dragen bits; motieven van eukaryote transcriptiefactoren, met bits in een genoom van , kunnen hun doelwitten niet alleen aanwijzen, en daarom werken zij in combinaties en in het open chromatine van Hoofdstuk 1.
Bewijs. Een willekeurige positie past op een motief met informatie-inhoud met kans ongeveer (elke bit specificiteit halveert de kans), dus is het verwachte aantal toevallige treffers in posities . Willen de echte plaatsen eruit springen, dan moet dit van de orde of kleiner zijn: , dat wil zeggen . ∎
Voorbeeld 5.14 (Verwachte toevallige treffers)
Een restrictieplaats van zes vaste basen heeft bits en past op een willekeurige positie met kans : ongeveer keer in een genoom van E. coli van op beide strengen gelezen (de plaats is palindroom, dus één keer per positie), en keer in het menselijk genoom. Een eukaryote factor waarvan het motief bits draagt past op miljoen posities in het menselijk genoom, enkele duizenden keren meer dan de genen die zij reguleert. Een motief alleen is een zwakke voorspeller in een groot genoom; de toestand van het chromatine, de naburige motieven en de conservering van de plaats tussen soorten maken pas een voorspelling.
5.5 Van sequentie naar functie
Methode 5.15 (Een onbekend eiwit annoteren)
Gegeven een nieuwe coderende sequentie: (1) vertaal haar in het juiste leesraam en kijk of er een signaalpeptide, transmembraansegmenten en gebieden met weinig complexiteit zijn; (2) doorzoek de eiwitdatabanken met BLAST en lees de treffers met , en let erop of de uitlijning het hele eiwit beslaat (een echte ortholoog) of een segment (een gedeeld domein); (3) doorzoek de domeindatabanken met profiel-HMM’s, die families vinden die BLAST mist en die het eiwit in domeinen verdelen; (4) leid orthologie af, niet enkel gelijkenis, door na te gaan of de beste treffer in het andere genoom de zoekvraag als zijn beste treffer heeft (wederzijds beste treffers) of door het eiwit in een genboom te plaatsen (Hoofdstuk 25); (5) draag de functie van orthologen behoedzaam over — een geconserveerd katalytisch residu pleit voor dezelfde chemie, een ontbrekend ertegen — en voorspel de structuur; (6) behandel elke voorspelling als een hypothese voor de werkbank.
Propositie 5.16 (Structuur uit sequentie)
De vouwing van een eiwit wordt bepaald door zijn sequentie (Hoofdstuk 7), en haar uit de sequentie berekenen was vijftig jaar lang het centrale onopgeloste probleem van het vak. Drie benaderingen slaagden na elkaar. Homologiemodellering bouwt de structuur van een eiwit op die van een opgeloste homoloog, en dat gaat betrouwbaar boven identiteit. Co-evolutieanalyse maakt gebruik van het feit dat twee residuen die in de vouwing contact maken over een diepe meervoudige uitlijning geneigd zijn samen te muteren, zodat statistisch gekoppelde paren kolommen voorspelde contacten zijn, en genoeg contacten leggen een vouwing vast. Methoden uit het diepe leren, getraind op de honderdduizend opgeloste structuren en op zulke uitlijningen, voorspellen de meeste bolvormige eiwitstructuren nu met bijna experimentele nauwkeurigheid (de CASP-beoordelingen van 2020), en databanken bevatten een voorspelde structuur voor vrijwel elke bekende eiwitsequentie. Wat zij minder goed voorspellen is wat één enkele structuur niet vat: wanordelijke gebieden, andere conformaties, het effect van een puntmutatie en complexen.
Opmerking 5.17 (De grenzen van de gevolgtrekking)
De meeste functionele annotaties in de databanken zijn nooit getoetst; zij zijn overgenomen van een homoloog, die op haar beurt door overname was geannoteerd. Fouten planten zich voort en vermenigvuldigen zich, en een verkeerde annotatie op een goed verbonden eiwit kan een hele familie besmetten. De remedies zijn de bovenstaande: onderscheid orthologie van homologie, lees de uitlijning, zoek de katalytische residuen, en onthoud dat “hypothetisch eiwit” een eerlijk etiket is dat een derde van de genen in de meeste genomen nog verdient.
5.6 Opgaven
Oefening 5.1 ★
Definieer globale en lokale uitlijning en geef voor elk één biologische situatie die erom vraagt.
Oplossing
Oplossing van Oefening 5.1.
Globaal: beide sequenties van begin tot eind uitgelijnd, elk residu in een kolom — voor twee eiwitten die over hun hele lengte homoloog worden geacht, zoals orthologen van een huishoudenzym. Lokaal: het hoogst scorende paar deelreeksen, de rest genegeerd — om een gedeeld domein te vinden (een SH2-domein in twee verder ongerelateerde signaaleiwitten), of een gen in een lange genoomsequentie.
Oefening 5.2 ★
Vul de tabel van Needleman–Wunsch voor AGC tegen AAC in met overeenkomst , verschil , hiaat , en geef de optimale uitlijning en de score.
Oplossing
Oplossing van Oefening 5.2.
Randen beide kanten op. Rij A: . Rij G: . Rij C: . Optimum : AGC boven AAC zonder hiaten (overeenkomst, verschil, overeenkomst: ).
Oefening 5.3 ★
In BLOSUM62 scoort tryptofaan–tryptofaan en leucine–leucine . Leg met de log-oddsformule uit waarom de identiteit van het zeldzamere residu meer waard is.
Oplossing
Oplossing van Oefening 5.3.
. Tryptofaan is zeldzaam (), dus de kans dat twee tryptofanen toevallig worden uitgelijnd, , is uiterst klein, en een geconserveerd tryptofaanpaar is een veel sterker teken van homologie dan een geconserveerd leucinepaar (); de log-oddsverhouding is navenant groter.
Oefening 5.4 ★
Wat is een E-waarde? Een zoekactie levert een treffer met op. Wat betekent dat getal, en is de treffer een homoloog?
Oplossing
Oplossing van Oefening 5.4.
De E-waarde is het aantal uitlijningen met een score van minstens die hoogte dat door toeval te verwachten is bij een zoekactie van deze zoekvraag tegen een databank van deze omvang. betekent dat drie zulke scores door toeval worden verwacht: de treffer is geen bewijs van homologie (zij kan het nog steeds zijn, maar de zoekactie kan het niet zeggen).
Oefening 5.5 ★★
Een zoekvraag van residuen wordt doorzocht tegen residuen. Bereken de E-waarde van treffers met bitscores , en . Welke bitscore geeft ? Hoe verandert het antwoord als de zoekvraag residuen lang is?
Oplossing
Oplossing van Oefening 5.5.
. ; ; . Voor is bits nodig. Een zoekvraag van residuen heeft een tien keer kleinere , : bits volstaan — maar een korte zoekvraag haalt zelfs dat zelden.
Oefening 5.6 ★★
Bereken de informatie-inhoud van een motief waarvan de vier posities basenfrequenties (A, C, G, T) van , , en hebben. Hoeveel toevallige treffers heeft het in een genoom van ?
Oplossing
Oplossing van Oefening 5.6.
Informatie-inhouden: , , , en met , dus . Totaal bits. Toevallige treffers: posities op twee strengen — het motief is alleen vrijwel nutteloos.
Oefening 5.7 ★★
Leg uit waarom affiene hiaatstraffen realistischer zijn dan lineaire, en waarom zowel een zeer hoge als een zeer lage straf op het openen van een hiaat slechte uitlijningen geeft.
Oplossing
Oplossing van Oefening 5.7.
Een insertie van verscheidene residuen is één mutatiegebeurtenis, dus zouden haar kosten niet lineair met haar lengte moeten groeien: een openingskost plus een kleine verlengingskost bootst dat na. Een te hoge openingsstraf dwingt verschillen af waar een hiaat hoort en lijnt alles na een echte insertie verkeerd uit; een te lage straf strooit overal hiaten, laat residuen toevallig overeenkomen en blaast de identiteit op.
Oefening 5.8 ★★
Een BLAST-zoekactie van een menselijk eiwit tegen een vliegendatabank geeft een beste treffer met die de residuen 50–180 van de zoekvraag van residuen beslaat. Is het vliegeneiwit de ortholoog van het menselijke? Welke aanvullende toets ligt voor de hand?
Oplossing
Oplossing van Oefening 5.8.
Niet noodzakelijk: de uitlijning beslaat een segment van residuen, en dat is de handtekening van een gedeeld domein en niet van een ortholoog die over zijn hele lengte is uitgelijnd. Toets: doorzoek met het vliegeneiwit het menselijk eiwitbestand terug (is de zoekvraag zijn beste treffer, over de hele lengte?), bepaal het domein met een profiel-HMM, en bouw een genboom van de familie in verscheidene soorten.
Oefening 5.9 ★★
Waarom sporen profielmethoden homologen op die de paarsgewijze uitlijning mist? Geef een voorbeeld van een kolompatroon dat een profiel vat en één enkele sequentie niet.
Oplossing
Oplossing van Oefening 5.9.
Een profiel legt kolom voor kolom vast wat de familie duldt: een positie die altijd hydrofoob is maar nooit hetzelfde residu, een onveranderlijk katalytisch residu, een positie die bij de helft van de familie altijd een hiaat is. Een paarsgewijze uitlijning scoort elk residu tegen één ander residu en kan niet weten dat een valine op positie 40 “even goed is als” het isoleucine dat de zoekvraag daar heeft. Het profiel weegt bovendien de geconserveerde kolommen, zodat zwakke gelijkenis die zich juist daar samenbalt significant wordt.
Oefening 5.10 ★★★
Laat zien dat onder een scoringsschema met positieve verwachte score de lokale uitlijning volgens Smith–Waterman van twee lange willekeurige sequenties een score heeft die lineair met hun lengte groeit, en leg uit waarom de theorie van de E-waarde daardoor faalt. Wat betekent dit voor het uitlijnen van DNA met overeenkomst en verschil bij een GC-gehalte van ?
Oplossing
Oplossing van Oefening 5.10.
Bij een positieve verwachte score per kolom is de cumulatieve score langs de diagonaal van twee willekeurige sequenties een toevalswandeling met positieve drift: na kolommen is zij ongeveer , zodat de beste lokale uitlijning in wezen het geheel is en haar score als groeit in plaats van als . De theorie van Karlin–Altschul, die een negatieve drift vergt zodat hoge scores zeldzame uitstapjes zijn, geldt dan niet en er bestaat geen . Voor DNA bij GC is de kans op een overeenkomst , zodat de verwachte score is: nog steeds negatief, en de statistiek houdt stand; maar een schema met overeenkomst en verschil zou verwachting hebben en zou het hele genoom als één uitlijning melden.
Oefening 5.11 ★★★
De tabel van Needleman–Wunsch vergt geheugencellen; voor twee chromosomen van is dat . Beschrijf twee ideeën waarmee genoomuitlijners dat vermijden (seeds en ketenen; banden), en wat elk daarvan opgeeft.
Oplossing
Oplossing van Oefening 5.11.
Seeds en ketenen: zoek met een hashtabel exacte of bijna exacte treffers van -meren tussen de twee sequenties, houd die welke op samenhangende diagonalen liggen, keten ze aaneen, en voer dynamisch programmeren alleen uit in de gaten tussen geketende seeds; dat geeft uitlijningen op in gebieden zonder seed (sterk uiteenlopende stukken). Banden: zijn de twee sequenties bekend als vrijwel collineair, bereken dan alleen de cellen binnen een band van breedte rond de diagonaal, tegen kosten in plaats van ; dat geeft elke uitlijning op met een insertie die groter is dan de band.
Oefening 5.12 ★★★
Een HMM voor het vinden van genen bij bacteriën heeft toestanden voor de drie codonposities en voor niet-coderend DNA. Leg uit hoe het model coderende van niet-coderende sequentie kan onderscheiden zonder enige informatie over stopcodons (denk aan het codongebruik), en waarom dezelfde aanpak in een menselijk genoom veel moeilijker is.
Oplossing
Oplossing van Oefening 5.12.
Coderende sequentie heeft een periode van drie: de drie codonposities hebben verschillende basensamenstellingen (de derde is het meest scheef), en het codongebruik is per soort ongelijk. Een model met drie coderende toestanden achter elkaar, die elk basen uitzenden met de samenstelling van die codonpositie, geeft coderend DNA over een venster van enkele tientallen codons een hogere kans dan de niet-coderende toestand doet, zelfs zonder stopcodons. In een menselijk genoom zijn de exons kort () en gescheiden door introns van kilobasen, zodat het coderende signaal kort en onderbroken is; het model moet bovendien splitsplaatsen herkennen, die zwakke signalen zijn, en de enorme hoeveelheid niet-coderende sequentie levert vele valse coderende segmenten op.
5.7 Vraagstuk: een sequentie uit de diepzee
Probleem 5.1
Weekendvraagstuk — een onbekend eiwit met de hand uitgelijnd, tegen de databanken doorzocht met berekening van zijn significantie, zijn regulerende motief in bits gewogen, en zijn gen getoetst aan de statistiek van toevallige open leesramen, met als besluit de E-waarde van de beste treffer, het aantal bits dat een plaats nodig heeft en de lengte die een leesraam moet hebben om geloofd te worden
Gegevens: een eiwit van residuen uit een diepzeeworm. Eiwitdatabank: residuen. Genoom van de worm: , GC. Scoring voor uitlijningen met de hand: overeenkomst , verschil , hiaat . Bitscore van de beste BLAST-treffer: ; van de tiende treffer: .
Deel I — Met de hand.
- Lijn de peptiden KQT en KAQT uit met de recursie van Needleman–Wunsch: schrijf de tabel op en geef de optimale uitlijning en de score.
- Doe hetzelfde met Smith–Waterman (lokaal) voor GATCAT tegen ACAT: zoek de beste lokale uitlijning en haar score.
- Hoeveel celbewerkingen kost een globale uitlijning van het eiwit van residuen tegen een eiwit van residuen? En tegen de hele databank?
- Als een computer bewerkingen per seconde uitvoert, hoe lang duurt de volledige databankuitlijning van vraag 3 dan? Waarom wordt in plaats daarvan BLAST gebruikt?
- Een identiteitsscore in BLOSUM62 is voor alanine () en voor tryptofaan (). Bereken met (eenheden van een halve bit) de doelfrequenties en , en de verhouding voor elk. Geef de betekenis.
- Twee eiwitten delen identiteit over residuen. Zeg waarom identiteit alleen hier de homologie niet kan beslechten en wat dat wel zou doen.
Deel II — De zoekactie.
- Bereken voor de zoekvraag tegen de databank, en .
- Bereken de E-waarde van de beste treffer () en van de tiende treffer ().
- Welke bitscore komt bij deze zoekactie overeen met ? En met ?
- Dezelfde beste treffer wordt gevonden wanneer de databank tot residuen is gegroeid. Wat is haar E-waarde?
- De tiende treffer lijnt de residuen 200–260 van de zoekvraag uit met identiteit over residuen. Zeg met de E-waarde of dit bewijs van homologie is, en wat een profielzoekactie zou kunnen toevoegen.
- De beste treffer is een menselijk kinase, uitgelijnd over de residuen 10–290. Zijn beste treffer in het eiwitbestand van de worm is de zoekvraag. Wat stelt deze wederzijdse toets vast, en wat niet?
Deel III — Een motief.
- Stroomopwaarts van het gen ligt een kandidaat-bindingsplaats voor een transcriptiefactor van acht posities met informatie-inhouden bits. Wat is in totaal?
- Hoeveel toevallige treffers heeft het motief in het genoom van (beide strengen, posities)?
- De factor reguleert ongeveer genen. Hoeveel bits zou een motief nodig hebben om in dit genoom plaatsen alleen aan te wijzen?
- Hoeveel van het tekort zou een tweede, aangrenzend motief van bits kunnen leveren, als de twee binnen een vaste tussenafstand samen moeten voorkomen?
- Een positie met frequenties voor (A, C, G, T): bereken haar entropie en haar informatie-inhoud.
- Leg met het informatieargument uit waarom bacteriële transcriptiefactoren doorgaans langere en beter geconserveerde plaatsen hebben dan eukaryote.
Deel IV — Het gen zelf.
- Wat is in willekeurig DNA met gelijke basensamenstelling de kans dat een codon een stopcodon is? Wat is het verwachte aantal codons voordat er een stopcodon verschijnt (een geometrische verdeling)?
- Het genoom van de worm is voor GC. Herbereken met de werkelijke basenfrequenties de kans dat een willekeurig codon een stopcodon is (TAA, TAG, TGA), en de verwachte lengte van het leesraam. Welke kant op duwt een laag GC-gehalte het vinden van genen?
- Wat is de kans dat een willekeurig open leesraam minstens codons lang is? En minstens ?
- In het genoom van geven zes leesramen op twee strengen ongeveer codonbeginpunten. Hoeveel willekeurige open leesramen van minstens codons zijn te verwachten? En van minstens ?
- Leg uit waarom “open leesraam langer dan codons” bij een bacterie een bruikbare genzoeker is en in dit genoom niet, en wat een eukaryote genzoeker in plaats daarvan gebruikt.
- Het gen van de worm heeft zes exons van gemiddeld . Leg uit hoe reads uit RNA-sequencing de exonstructuur vaststellen die de genoomsequentie alleen onduidelijk laat.
- Vat samen: de E-waarde van de beste treffer (vraag 8), het aantal bits dat nodig is om plaatsen aan te wijzen (vraag 15), en het verwachte aantal willekeurige leesramen van codons in het genoom (vraag 22).
Oplossing
Oplossing van Probleem 5.1.
1. Rijen K, Q, T; kolommen K, A, Q, T; randen en . Rij K: ; rij Q: ; rij T: . Optimum : K-QT boven KAQT. 2. Beste lokale score : CAT tegen CAT (residuen 4–6 van GATCAT met 2–4 van ACAT); ATCAT tegen A-CAT scoort eveneens . 3. bewerkingen; tegen de databank . 4. s, tien uur per zoekvraag; de seeds van BLAST slaan vrijwel de hele tabel over en antwoorden in seconden. 5. . Alanine: , , verhouding . Tryptofaan: , , verhouding . Een uitgelijnd tryptofaanpaar komt keer vaker voor in homologen dan door toeval, een alaninepaar maar vier keer; alanineparen zijn in absolute zin niettemin talrijker omdat alanine veel voorkomt. 6. ligt in de schemerzone, waar toevallige uitlijningen halen; de E-waarde van de uitlijning, geconserveerde motieven op de juiste posities, een treffer van een profiel-HMM op een bekende familie, of een gedeelde vouwing zouden het beslechten. 7. ; . 8. ; . 9. bij bits; bij bits. 10. Tien keer : , nog altijd overweldigend. 11. Met is de tiende treffer wat het toeval oplevert; identiteit over residuen is geen bewijs. Een profielzoekactie van de residuen 200–260 tegen de domeindatabank zou kunnen laten zien of dat segment een bekend domein is, met een statistiek die de paarsgewijze vergelijking niet heeft. 12. Wederzijds beste treffers over de volle lengte zijn verenigbaar met een-op-een-orthologie; zij bewijzen haar niet — een duplicatie in één lijn na de splitsing geeft twee co-orthologen, en het verlies van de echte ortholoog kan een paraloog als beste treffer achterlaten. Een genboom met verscheidene soorten is de toets. 13. bits. 14. toevallige treffers. 15. bits. 16. Samen voorkomen op een vaste tussenafstand telt de bits op: , wat van de ontbrekende levert; ongeveer bits (een factor in toevallige treffers) moet van elders komen — toegankelijkheid van het chromatine, verdere partners. 17. bit; bit. 18. Een bacteriële factor moet haar enkele plaatsen vinden in een genoom van zonder hulp van het chromatine: zij heeft zo’n bits nodig, en haar plaatsen zijn lang en geconserveerd. Een eukaryoot genoom is duizend keer groter en vraagt tien bits meer, en toch hebben de factoren korte plaatsen; zij bereiken specificiteit door combinatie en door de beperking tot toegankelijk chromatine, wat de regulatie ook beter evolueerbaar maakt, omdat een korte plaats gemakkelijk wordt gewonnen of verloren. 19. ; het verwachte aantal codons vóór een stopcodon is . 20. , : , ; samen , verwachte leesraamlengte codons. AT-rijk DNA zit vol stopcodons, dus zijn willekeurige open leesramen korter en springen lange er sterker uit. 21. ; . 22. Elk maximaal open leesraam eindigt op een stopcodon, en codonbeginpunten bevatten stopcodons: ongeveer willekeurige leesramen van minstens codons, en van minstens . 23. Een bacterie van heeft zo’n stopcodons en dus ongeveer toevallige leesramen van codons maar vrijwel geen van ; haar genen tellen gemiddeld codons en van het DNA is coderend, zodat een lang open leesraam vrijwel altijd een gen is. Bij de worm codeert van het DNA, tellen de exons gemiddeld codons — korter dan de toevalsdrempel — en overspoelen een miljoen toevallige leesramen van codons hen. Eukaryote genzoekers gebruiken signalen van splitsplaatsen, codonvoorkeur in een verborgen markovmodel, homologie met bekende eiwitten en, vooral, gesequencede transcripten. 24. Een read uit een gesplitste boodschapper lijnt in twee stukken op het genoom uit, gescheiden door een intron: de splitsing markeert beide splitsplaatsen tot op de base; de readdekking bakent de exons af en gepaarde reads verbinden opeenvolgende exons tot één transcript, wat uitwijst welke van verscheidene kandidaat-splitsplaatsen wordt gebruikt. 25. voor de beste treffer; ongeveer bits om plaatsen in het genoom aan te wijzen; zo’n toevallige leesramen van codons in het hele genoom.