Biologia universitária — 3.º ano · Bachelor Year 3
5Bioinformática e análise de sequências
Um biólogo que acaba de sequenciar um gene de um verme do mar profundo cola seus aminoácidos num formulário da web e, três segundos depois, fica sabendo que a proteína é uma prima distante de uma cinase humana, com de identidade ao longo de resíduos e uma probabilidade de de a semelhança ser acaso. Por trás desses três segundos estão um algoritmo de programação dinâmica de 1970, uma teoria estatística dos alinhamentos aleatórios, matrizes de substituição destiladas de milhares de famílias de proteínas e um banco de dados de umas cem bilhões de posições. Este capítulo trata do raciocínio dentro da caixa: como duas sequências são alinhadas de modo que o alinhamento seja comprovadamente o melhor, como o escore passa a significar alguma coisa, como se distingue uma correspondência de uma coincidência e como se acham padrões num genoma que ninguém examinou antes. A matemática é elementar — uma recorrência, um logaritmo, uma distribuição de Poisson — e vale a pena conhecê-la, porque toda conclusão tirada de uma comparação de sequências repousa nela.
5.1 Alinhar duas sequências
Definição 5.1 (Alinhamento e escore)
Um alinhamento de duas sequências as escreve uma sobre a outra, com lacunas (–) inseridas de modo que as colunas emparelhem um resíduo com um resíduo ou um resíduo com uma lacuna, e nenhuma coluna emparelhe duas lacunas. Seu escore é a soma, sobre as colunas, de um escore de substituição para cada par de resíduos e de uma penalidade de lacuna para cada lacuna: uma penalidade linear por posição de lacuna ou, mais realisticamente, uma penalidade afim para uma série de lacunas, com o custo de abertura maior que o custo de extensão , já que uma inserção de vários resíduos é um único evento evolutivo. Um alinhamento global cobre as duas sequências de ponta a ponta; um alinhamento local encontra o par de subcadeias de maior escore e ignora o resto, que é o que se quer quando um domínio compartilhado está em duas proteínas de resto não aparentadas.
Teorema 5.2 (Needleman–Wunsch)
Sejam e , com penalidade linear de lacuna . Defina como o melhor escore de um alinhamento global dos prefixos e . Então , e, para ,
é o escore global ótimo, um alinhamento ótimo se recupera retrotraçando a partir de as escolhas que produziram cada máximo, e todo o cálculo leva passos. A variante Smith–Waterman para alinhamento local acrescenta como quarta opção no máximo, fixa as bordas em e lê a resposta na maior entrada da tabela.
Demonstração. Considere a última coluna de qualquer alinhamento dos dois prefixos. Ela é uma de três coisas: sobre , sobre uma lacuna, ou uma lacuna sobre . Removê-la deixa um alinhamento de , de ou de , respectivamente, cujo escore é no máximo o desse par; e, ao contrário, cada um desses alinhamentos ótimos pode ser estendido pela coluna final correspondente. Logo, o melhor escore que termina em cada tipo de coluna é o do par mais curto mais o escore da coluna, e o ótimo é o maior dos três. As bordas são forçadas (só lacunas são possíveis contra um prefixo vazio). A indução sobre preenche a tabela; o número de células é . Para o alinhamento local, a opção extra significa “começar um novo alinhamento aqui”, o que faz de o melhor escore de um alinhamento que termina em , e o melhor alinhamento local termina em algum lugar. ∎
Exemplo 5.3 (Uma tabela quatro por três)
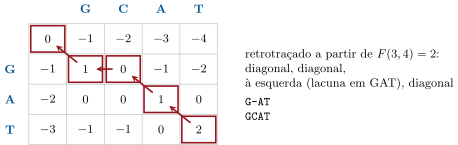
Alinhe GAT com GCAT, pontuando para correspondência, para discordância, . As bordas são ao longo do topo e pela lateral. Preenchendo linha a linha: , , , ; , , , ; , , , . O ótimo é e o retrotraçado — diagonal a partir de (T,T), diagonal a partir de (A,A), depois à esquerda de (G,C) até (G,G), depois diagonal — dá
três correspondências e uma lacuna: .
Método 5.4 (Alinhar duas sequências)
(1) Escolha a pontuação: uma matriz de substituição adequada à divergência esperada (BLOSUM62 para proteínas de distância desconhecida; correspondência/discordância para DNA) e penalidades afins de lacuna (tipicamente abertura , extensão com a BLOSUM62). (2) Decida entre global e local: global para duas sequências que se acreditam homólogas em todo o seu comprimento, local nos demais casos. (3) Preencha a tabela pela recorrência, guardando para cada célula um ponteiro para a escolha que deu seu máximo. (4) Retrotrace a partir de (global) ou da célula máxima até um zero (local), escrevendo o alinhamento da direita para a esquerda. (5) Julgue o resultado não por seu escore bruto, mas por sua significância estatística (adiante), e olhe para ele: lacunas longas, trechos de baixa complexidade e alinhamentos confinados a uma repetição são avisos.
5.2 Pontuar: quanto vale uma correspondência
Definição 5.5 (Matrizes de substituição)
Uma matriz de substituição dá para cada par de aminoácidos como um escore de log-chances:
em que é a frequência com que e são encontrados alinhados em alinhamentos confiáveis de proteínas aparentadas, é a frequência com que seriam emparelhados por acaso, e é uma escala escolhida para que as entradas sejam inteiros convenientes. Um escore positivo significa que o par ocorre mais vezes em homólogas do que por acaso; os escores de identidade são maiores para os aminoácidos raros (triptofano , cisteína na BLOSUM62) e menores para os comuns (leucina , alanina ), e as substituições conservativas (isoleucina–valina ) pontuam positivo enquanto as radicais (triptofano–glicina ) pontuam negativo. As matrizes PAM (Dayhoff, 1978) foram derivadas de proteínas proximamente aparentadas e extrapoladas para distâncias maiores por multiplicação de matrizes; as matrizes BLOSUM (Henikoff e Henikoff, 1992) foram contadas diretamente em blocos de sequências alinhadas agrupadas a uma dada identidade — a BLOSUM62 a partir de blocos a — e são o padrão porque foram medidas, e não extrapoladas, na distância em que são usadas.
Proposição 5.6 (Por que log-chances)
Para que um esquema de pontuação possa ser usado em alinhamento local, o escore esperado de uma coluna emparelhada ao acaso, , precisa ser negativo, e alguns escores precisam ser positivos; do contrário os alinhamentos aleatórios cresceriam sem limite e o segmento de maior escore seria a sequência inteira. Dado isso, qualquer esquema assim é equivalente a um esquema de log-chances para algumas frequências-alvo — os alinhamentos que ele achará ótimos são aqueles cujos pares de resíduos se distribuem como . Escolher a matriz é, portanto, escolher a divergência que se espera detectar: uma matriz para parentes próximos (BLOSUM80, PAM30) tem positivos mais agudos e negativos mais duros, e uma para parentes distantes (BLOSUM45, PAM250) é mais achatada.
Demonstração. Admitido neste nível. ∎
Exemplo 5.7 (Identidade, similaridade e a zona crepuscular)
Duas sequências proteicas aleatórias alinhadas de forma ótima com lacunas chegam a cerca de de identidade por acaso. Acima de de identidade ao longo de cem resíduos, duas proteínas são quase certamente homólogas; entre e está a zona crepuscular, em que a identidade sozinha não decide e a estatística adiante precisa decidir. As homólogas podem cair bem abaixo da zona: as subunidades da hemoglobina e a mioglobina compartilham de identidade, a lisozima e a -lactalbumina , e muitos pares de proteínas de mesmo enovelamento compartilham menos de , detectáveis só pela comparação de perfis ou de estruturas.
5.3 Buscar num banco de dados
Definição 5.8 (BLAST)
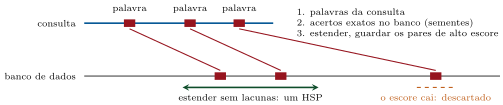
Alinhar uma consulta de resíduos contra um banco de por programação dinâmica completa custaria atualizações de célula por busca. O BLAST (Altschul e colaboradores, 1990) troca um pouco de sensibilidade por mil vezes mais velocidade em três etapas: (1) lista as palavras da consulta (três resíduos para proteínas, onze bases para DNA) e suas vizinhas de alto escore; (2) varre o banco em busca de correspondências exatas de palavra — as sementes; (3) estende cada semente nos dois sentidos sem lacunas até que o escore caia uma quantidade fixada abaixo de seu melhor valor, guardando os pares de segmentos de alto escore (HSPs) e unindo depois os HSPs próximos por programação dinâmica com lacunas numa faixa estreita. Uma homóloga verdadeira quase sempre contém ao menos uma palavra exata de três resíduos em comum; uma semelhança de acaso raramente contém, e nunca é estendida.
Teorema 5.9 (A estatística de um acerto ao acaso)
Para uma consulta de comprimento buscada contra um banco de comprimento total , com um esquema de pontuação de escore esperado negativo, o número de alinhamentos locais sem lacunas que pontuam ao menos e surgem por acaso segue uma distribuição de Poisson de média
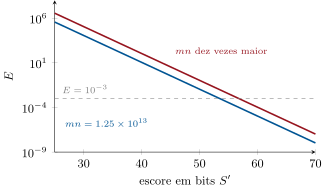
em que e dependem apenas do esquema de pontuação e das frequências dos resíduos ( é a escala da matriz de log-chances). é o valor esperado do escore . Escrevendo o escore em bits, , a fórmula se torna , e a probabilidade de ao menos um alinhamento de acaso alcançar é , que é igual a quando é pequeno.
Prova parcial. A cauda exponencial é o teorema de Karlin–Altschul e é admitida: o escore máximo de segmento de um passeio aleatório com deriva negativa tem uma distribuição cuja cauda decai como , com a raiz positiva de — que é exatamente a equação que torna a matriz de log-chances consistente. Dada essa cauda, o resto é contagem. Os segmentos de alto escore podem começar em qualquer um dos pares de posições, são raros e são quase independentes; o número deles que excede é, portanto, Poisson com média proporcional a e à probabilidade da cauda, . A probabilidade de nenhum é . A substituição pelo escore em bits é álgebra: . Para alinhamentos com lacunas vale a mesma forma, com e estimados por simulação. ∎
Exemplo 5.10 (Ler um valor E)
Uma consulta de resíduos contra um banco de resíduos tem . Um acerto com escore em bits de tem : é, essencialmente com certeza, uma homóloga. Um acerto com tem : esperam-se onze escores desses por acaso, e o acerto não significa nada. O mesmo alinhamento, com o mesmo escore em bits, buscado contra um banco dez vezes maior, tem um dez vezes maior — a significância é propriedade da busca, não do par. O limiar de uso comum é para uma homóloga confiável; – merece uma segunda olhada com um método de perfil.
5.4 Perfis, estados ocultos e motivos
Definição 5.11 (Alinhamento múltiplo e perfis)
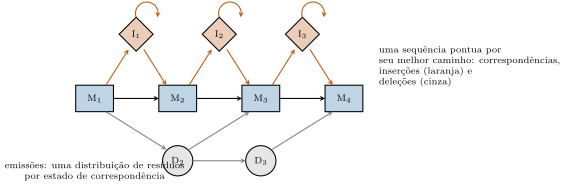
Um alinhamento múltiplo de sequências organiza uma família de sequências em colunas de resíduos homólogos. A programação dinâmica exata sobre sequências custa e é impossível além de três; os programas práticos alinham progressivamente, primeiro o par mais próximo segundo uma árvore-guia, depois sequências e grupos ao alinhamento em crescimento, com rodadas de refinamento. Um alinhamento pronto é resumido como um perfil: para cada coluna, a frequência de cada resíduo e das lacunas. Um modelo oculto de Markov de perfil formaliza isso como uma cadeia de estados de correspondência, um por coluna conservada, cada um emitindo resíduos com suas próprias probabilidades, com estados de inserção e de deleção que admitem resíduos a mais ou a menos em cada posição; o modelo de uma família (uma entrada do Pfam) pontua uma nova sequência pela probabilidade do melhor caminho pelos estados, e encontra homólogas bem abaixo da zona crepuscular da comparação par a par, porque uma coluna que só tolera resíduos hidrofóbicos diz isso, ao passo que uma sequência isolada não pode dizer.
Definição 5.12 (Motivos e conteúdo de informação)
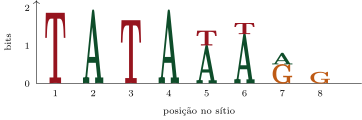
Um motivo é um padrão curto — um sítio de fator de transcrição, um sinal de splicing, um sítio de fosforilação — representado por uma matriz de pesos por posição com a frequência de cada base ou resíduo em cada posição . O conteúdo de informação da posição é bits para o DNA, em que é sua entropia: bits para uma base invariante, para uma posição em que as quatro são igualmente prováveis. O total é desenhado como um logo de sequência, cada posição uma pilha de letras cuja altura total é e cujas letras têm tamanho proporcional à frequência.
Proposição 5.13 (Quanta informação um sítio precisa ter)
Um sítio que precisa ser encontrado vezes num genoma de posições, e em nenhum outro lugar, precisa de cerca de bits de conteúdo de informação: o motivo precisa reduzir as posições candidatas às verdadeiras, e cada bit reduz as candidatas à metade. Os motivos observados de reguladores bacterianos bem estudados correspondem a essa previsão — os sítios de E. coli de um repressor que se liga a algumas dezenas de lugares num genoma de carregam bits; os motivos de fatores de transcrição eucariontes, com bits num genoma de , não conseguem especificar sozinhos seus alvos, e é por isso que agem em combinações e na cromatina aberta do Capítulo 1.
Demonstração. Uma posição aleatória corresponde a um motivo de conteúdo de informação com probabilidade de cerca de (cada bit de especificidade reduz a chance à metade), de modo que o número esperado de correspondências ao acaso em posições é . Para que os sítios verdadeiros se destaquem, isso precisa ser da ordem de ou menos: , isto é, . ∎
Exemplo 5.14 (Correspondências esperadas ao acaso)
Um sítio de restrição de seis bases fixas tem bits e corresponde a uma posição aleatória com probabilidade : cerca de vezes num genoma de E. coli de lido nas duas fitas (o sítio é palindrômico, e portanto uma vez por posição) e vezes no genoma humano. Um fator eucarionte cujo motivo carrega bits corresponde a milhões de posições no genoma humano, vários milhares de vezes mais do que os genes que ele regula. Um motivo sozinho é um previsor fraco num genoma grande; o estado da cromatina, os motivos vizinhos e a conservação do sítio entre espécies é que fazem uma previsão.
5.5 Da sequência à função
Método 5.15 (Anotar uma proteína desconhecida)
Dada uma nova sequência codificadora: (1) traduza-a na fase certa e procure um peptídeo-sinal, segmentos transmembrana e regiões de baixa complexidade; (2) busque nos bancos de proteínas com o BLAST e leia os acertos com , observando se o alinhamento cobre a proteína inteira (uma ortóloga verdadeira) ou um segmento (um domínio compartilhado); (3) busque nos bancos de domínios com HMMs de perfil, que encontram famílias que o BLAST deixa passar e repartem a proteína em domínios; (4) infira ortologia, e não mera similaridade, verificando se o melhor acerto no outro genoma tem a consulta como seu melhor acerto (melhores acertos recíprocos) ou situando a proteína numa árvore de genes (Capítulo 25); (5) transfira a função das ortólogas com cautela — um resíduo catalítico conservado argumenta a favor de uma química conservada, e um resíduo ausente argumenta contra — e preveja a estrutura; (6) trate toda previsão como hipótese para a bancada.
Proposição 5.16 (Estrutura a partir da sequência)
O enovelamento de uma proteína é determinado por sua sequência (Capítulo 7), e calculá-lo a partir da sequência foi durante cinquenta anos o problema central não resolvido da área. Três abordagens tiveram êxito, uma após a outra. A modelagem por homologia constrói a estrutura de uma proteína sobre a de uma homóloga já resolvida, de modo confiável acima de de identidade. A análise de coevolução explora o fato de que dois resíduos em contato no enovelamento tendem a mutar juntos ao longo de um alinhamento múltiplo profundo, de modo que pares de colunas estatisticamente acopladas são contatos previstos, e contatos bastantes definem um enovelamento. Os métodos de aprendizado profundo treinados nas cem mil estruturas resolvidas e nesses alinhamentos agora preveem a maioria das estruturas de proteínas globulares com acurácia quase experimental (as avaliações CASP de 2020), e há bancos com uma estrutura prevista para praticamente toda sequência proteica conhecida. O que eles preveem pior é aquilo que uma estrutura única não capta: regiões desordenadas, conformações alternativas, o efeito de uma mutação pontual e os complexos.
Observação 5.17 (Os limites da inferência)
A maioria das anotações funcionais nos bancos nunca foi testada; elas foram transferidas de uma homóloga, que por sua vez fora anotada por transferência. Os erros se propagam e se multiplicam, e uma anotação errada numa proteína bem conectada pode infectar toda uma família. Os remédios são os de cima: distinga ortologia de homologia, leia o alinhamento, procure os resíduos catalíticos e lembre que “proteína hipotética” é um rótulo honesto que um terço dos genes da maioria dos genomas ainda merece.
5.6 Exercícios
Exercício 5.1 ★
Defina alinhamento global e local e dê uma situação biológica que exija cada um.
Solução
Solução de Exercício 5.1.
Global: as duas sequências alinhadas de ponta a ponta, cada resíduo numa coluna — para duas proteínas que se acreditam homólogas em todo o comprimento, como as ortólogas de uma enzima de manutenção. Local: o par de subcadeias de maior escore, ignorado o resto — para achar um domínio compartilhado (um domínio SH2 em duas proteínas de sinalização de resto não aparentadas) ou um gene numa longa sequência genômica.
Exercício 5.2 ★
Preencha a tabela de Needleman–Wunsch para AGC contra AAC com correspondência , discordância , lacuna , e dê o alinhamento ótimo e o escore.
Solução
Solução de Exercício 5.2.
Bordas nos dois sentidos. Linha A: . Linha G: . Linha C: . Ótimo : AGC sobre AAC sem lacunas (correspondência, discordância, correspondência: ).
Exercício 5.3 ★
Na BLOSUM62, triptofano–triptofano pontua e leucina–leucina . Explique, a partir da fórmula de log-chances, por que a identidade do resíduo mais raro vale mais.
Solução
Solução de Exercício 5.3.
. O triptofano é raro (), de modo que a chance de dois triptofanos se alinharem ao acaso, , é ínfima, e um par de triptofanos conservado é um sinal de homologia muito mais forte que um par de leucinas conservado (); a razão de log-chances é correspondentemente maior.
Exercício 5.4 ★
O que é um valor E? Uma busca devolve um acerto com . O que esse número significa, e o acerto é uma homóloga?
Solução
Solução de Exercício 5.4.
O valor E é o número de alinhamentos com escore ao menos tão alto que se esperaria por acaso numa busca desta consulta contra um banco deste tamanho. significa que três escores desses são esperados por acaso: o acerto não é evidência de homologia (ele ainda pode sê-lo, mas a busca não tem como dizer).
Exercício 5.5 ★★
Uma consulta de resíduos é buscada contra resíduos. Calcule o valor E de acertos com escores em bits , e . Que escore em bits dá ? Como muda a resposta se a consulta tiver resíduos?
Solução
Solução de Exercício 5.5.
. ; ; . exige bits. Uma consulta de resíduos tem um dez vezes menor, : bits bastam — mas uma consulta curta raramente chega sequer a isso.
Exercício 5.6 ★★
Calcule o conteúdo de informação de um motivo cujas quatro posições têm frequências de base (A, C, G, T) iguais a , , e . Quantas correspondências ao acaso ele tem num genoma de ?
Solução
Solução de Exercício 5.6.
Conteúdos de informação: , , e com , logo . Total bits. Correspondências ao acaso: posições em duas fitas — o motivo é quase inútil sozinho.
Exercício 5.7 ★★
Explique por que as penalidades afins de lacuna são mais realistas que as lineares, e por que uma penalidade de abertura muito alta e uma muito baixa dão, as duas, alinhamentos ruins.
Solução
Solução de Exercício 5.7.
Uma inserção de vários resíduos é um único evento mutacional, de modo que seu custo não deveria crescer linearmente com seu comprimento: um custo de abertura mais um pequeno custo de extensão modela isso. Uma penalidade de abertura alta demais força discordâncias onde caberia uma lacuna e desalinha tudo depois de uma inserção verdadeira; uma penalidade baixa demais espalha lacunas por toda parte, emparelhando resíduos ao acaso e inflando a identidade.
Exercício 5.8 ★★
Uma busca BLAST de uma proteína humana contra um banco de mosca dá um melhor acerto com cobrindo os resíduos 50–180 da consulta de resíduos. A proteína da mosca é a ortóloga da humana? Que teste adicional você faria?
Solução
Solução de Exercício 5.8.
Não necessariamente: o alinhamento cobre um segmento de resíduos, que é a assinatura de um domínio compartilhado, e não de uma ortóloga alinhada em todo o seu comprimento. Teste: busque a proteína da mosca de volta contra o proteoma humano (a consulta é seu melhor acerto, em todo o comprimento?), identifique o domínio com um HMM de perfil e construa uma árvore de genes da família em várias espécies.
Exercício 5.9 ★★
Por que os métodos de perfil detectam homólogas que o alinhamento par a par não detecta? Dê um exemplo de padrão de coluna que um perfil capta e que uma sequência isolada não capta.
Solução
Solução de Exercício 5.9.
Um perfil registra, coluna por coluna, o que a família tolera: uma posição que é sempre hidrofóbica mas nunca o mesmo resíduo, um resíduo catalítico invariante, uma posição que é sempre uma lacuna em metade da família. Um alinhamento par a par pontua cada resíduo contra um único outro resíduo e não tem como saber que uma valina na posição 40 é “tão boa quanto” a isoleucina que ali está na consulta. O perfil também pondera as colunas conservadas, de modo que uma similaridade fraca concentrada onde a família é conservada se torna significativa.
Exercício 5.10 ★★★
Mostre que, sob um esquema de pontuação de escore esperado positivo, o alinhamento local de Smith–Waterman de duas sequências aleatórias longas tem um escore que cresce linearmente com o comprimento delas, e explique por que isso faz a teoria do valor E falhar. O que isso implica para alinhar DNA com correspondência e discordância num conteúdo GC de ?
Solução
Solução de Exercício 5.10.
Com escore esperado positivo por coluna, o escore acumulado ao longo da diagonal de duas sequências aleatórias é um passeio aleatório com deriva positiva: após colunas ele vale cerca de , de modo que o melhor alinhamento local é essencialmente a coisa toda e seu escore cresce como , e não como . A teoria de Karlin–Altschul, que exige deriva negativa para que escores altos sejam excursões raras, não se aplica e nenhum existe. Para DNA a de GC, a chance de correspondência é , de modo que o escore esperado é : ainda negativo, e a estatística vale; mas um esquema como correspondência , discordância teria esperança e reportaria o genoma inteiro como um só alinhamento.
Exercício 5.11 ★★★
A tabela de Needleman–Wunsch precisa de células de memória; para dois cromossomos de isso dá . Descreva duas ideias com que os alinhadores de genomas a evitam (sementes e encadeamento; faixas) e o que cada uma abre mão.
Solução
Solução de Exercício 5.11.
Sementes e encadeamento: encontre correspondências exatas ou quase exatas de -meros entre as duas sequências com uma tabela de dispersão, guarde as que se alinham em diagonais coerentes, encadeie-as e rode a programação dinâmica só nas lacunas entre as sementes encadeadas; abre mão de alinhamentos em regiões sem semente (trechos muito divergentes). Faixas: se as duas sequências são sabidamente quase colineares, calcule apenas as células dentro de uma faixa de largura em torno da diagonal, a um custo em vez de ; abre mão de qualquer alinhamento com uma inserção maior que a faixa.
Exercício 5.12 ★★★
Um HMM de busca de genes em bactérias tem estados para as três posições do códon e para o DNA não codificante. Explique como o modelo consegue distinguir sequência codificadora de não codificante sem nenhuma informação sobre códons de parada (considere o uso de códons), e por que a mesma abordagem é muito mais difícil num genoma humano.
Solução
Solução de Exercício 5.12.
A sequência codificadora tem período três: as três posições do códon têm composições de bases diferentes (a terceira é a mais enviesada), e o uso de códons é desigual em cada espécie. Um modelo com três estados codificadores em sequência, cada um emitindo bases com a composição daquela posição do códon, atribui ao DNA codificante uma probabilidade maior do que o estado não codificante atribui, ao longo de uma janela de algumas dezenas de códons, mesmo sem os códons de parada. Num genoma humano os éxons são curtos (), separados por íntrons de quilobases, de modo que o sinal codificante é breve e interrompido; o modelo também precisa reconhecer os sítios de splicing, que são sinais fracos, e a enorme quantidade de sequência não codificante produz muitos segmentos codificantes falsos.
5.7 Problema: uma sequência do mar profundo
Problema 5.1
Problema de fim de semana — uma proteína desconhecida alinhada à mão, buscada nos bancos com sua significância calculada, seu motivo regulatório pesado em bits e seu gene conferido contra a estatística das fases de leitura aberta aleatórias, terminando no valor E do melhor acerto, nos bits de que um sítio precisa e no comprimento que uma fase de leitura precisa ter para ser acreditada
Dados: uma proteína de resíduos de um anelídeo do mar profundo. Banco de proteínas: resíduos. Genoma do verme: , GC. Pontuação dos alinhamentos à mão: correspondência , discordância , lacuna . Escore em bits do melhor acerto do BLAST: ; do décimo acerto: .
Parte I — À mão.
- Alinhe os peptídeos KQT e KAQT com a recorrência de Needleman–Wunsch: escreva a tabela e dê o alinhamento ótimo e o escore.
- Repita com Smith–Waterman (local) para GATCAT contra ACAT: encontre o melhor alinhamento local e seu escore.
- Quantas atualizações de célula custa um alinhamento global da proteína de resíduos contra uma proteína de resíduos? E contra o banco inteiro?
- Se um computador faz atualizações por segundo, quanto tempo leva o alinhamento da questão 3 contra o banco inteiro? Por que se usa o BLAST em vez dele?
- Um escore de identidade da BLOSUM62 é para a alanina () e para o triptofano (). Com (unidades de meio bit), calcule a frequência-alvo e , e a razão de cada uma. Interprete.
- Duas proteínas compartilham de identidade ao longo de resíduos. Diga por que a identidade sozinha não resolve a homologia aqui e o que resolveria.
Parte II — A busca.
- Calcule para a consulta contra o banco, e .
- Calcule o valor E do melhor acerto () e do décimo acerto ().
- Que escore em bits corresponde a nesta busca? E a ?
- O mesmo melhor acerto é encontrado quando o banco cresceu para resíduos. Seu valor E?
- O décimo acerto alinha os resíduos 200–260 da consulta com de identidade ao longo de resíduos. Usando o valor E, diga se ele é evidência de homologia e o que uma busca por perfil poderia acrescentar.
- O melhor acerto é uma cinase humana, alinhada ao longo dos resíduos 10–290. Seu melhor acerto no proteoma do verme é a consulta. O que esse teste recíproco estabelece, e o que não estabelece?
Parte III — Um motivo.
- A montante do gene há um candidato a sítio de fator de transcrição de oito posições com conteúdos de informação bits. Qual é o total?
- Quantas correspondências ao acaso o motivo tem no genoma de (as duas fitas, posições)?
- O fator regula cerca de genes. De quantos bits um motivo precisaria para especificar sozinho sítios neste genoma?
- Quanto dessa falta um segundo motivo adjacente de bits poderia suprir, se os dois precisarem ocorrer juntos dentro de um espaçamento fixo?
- Uma posição com frequências para (A, C, G, T): calcule sua entropia e seu conteúdo de informação.
- Explique, com o argumento de informação, por que os fatores de transcrição bacterianos costumam ter sítios mais longos e mais conservados que os eucariontes.
Parte IV — O próprio gene.
- Em DNA aleatório de composição de bases uniforme, qual é a probabilidade de um códon ser de parada? Qual é o número esperado de códons antes que apareça um de parada (uma distribuição geométrica)?
- O genoma do verme tem GC. Recalcule a probabilidade de um códon aleatório ser de parada (TAA, TAG, TGA) com as frequências de base reais, e o comprimento esperado da fase de leitura. Em que direção um conteúdo GC baixo empurra a busca de genes?
- Qual é a probabilidade de uma fase de leitura aberta aleatória ter ao menos códons? E ao menos ?
- No genoma de , seis fases em duas fitas dão cerca de inícios de códon. Quantas fases de leitura aberta aleatórias de ao menos códons se esperam? E de ao menos ?
- Explique por que “fase de leitura aberta com mais de códons” é um localizador de genes utilizável numa bactéria, mas não neste genoma, e o que um localizador de genes eucarionte usa em vez disso.
- O gene do verme tem seis éxons de em média. Explique como as leituras de sequenciamento de RNA resolvem a estrutura de éxons que a sequência genômica sozinha deixa ambígua.
- Resuma: o valor E do melhor acerto (questão 8), os bits necessários para especificar sítios (questão 15) e o número esperado de fases de leitura aleatórias de códons no genoma (questão 22).
Solução
Solução de Problema 5.1.
1. Linhas K, Q, T; colunas K, A, Q, T; bordas e . Linha K: ; linha Q: ; linha T: . Ótimo : K-QT sobre KAQT. 2. Melhor escore local : CAT contra CAT (resíduos 4–6 de GATCAT com 2–4 de ACAT); ATCAT contra A-CAT também pontua . 3. atualizações; contra o banco, . 4. s, dez horas por consulta; as sementes do BLAST saltam quase toda a tabela e respondem em segundos. 5. . Alanina: , , razão . Triptofano: , , razão . Um par de triptofanos alinhado é vezes mais frequente em homólogas do que por acaso, e um par de alaninas apenas quatro vezes; ainda assim os pares de alanina são mais comuns em termos absolutos, porque a alanina é comum. 6. está na zona crepuscular, em que os alinhamentos aleatórios chegam a ; o valor E do alinhamento, motivos conservados nas posições certas, uma correspondência a um HMM de perfil de família conhecida ou um enovelamento compartilhado resolveriam a questão. 7. ; . 8. ; . 9. em bits; em bits. 10. Dez vezes o : , ainda esmagador. 11. Com , o décimo acerto é o que o acaso produz; uma identidade de ao longo de resíduos não é evidência. Uma busca por perfil dos resíduos 200–260 contra o banco de domínios poderia mostrar se aquele segmento é um domínio conhecido, com uma estatística que falta à comparação par a par. 12. Melhores acertos recíprocos em todo o comprimento são compatíveis com uma ortologia um a um; não a provam — uma duplicação numa das linhagens depois da separação dá dois co-ortólogos, e a perda da ortóloga verdadeira pode deixar uma paráloga como melhor acerto. Uma árvore de genes com várias espécies é o teste. 13. bits. 14. correspondências ao acaso. 15. bits. 16. A coocorrência a espaçamento fixo soma os bits: , o que supre dos que faltam; cerca de bits (um fator de nas correspondências ao acaso) precisam vir de outro lugar — acessibilidade da cromatina, outros parceiros. 17. bit; bit. 18. Um fator bacteriano precisa achar seus poucos sítios num genoma de sem ajuda alguma da cromatina: ele precisa de uns bits, e seus sítios são longos e conservados. Um genoma eucarionte é mil vezes maior e exigiria dez bits a mais, e ainda assim seus fatores têm sítios curtos; eles alcançam especificidade por combinação e pela restrição da cromatina acessível, o que também torna a regulação mais evoluível, já que um sítio curto é facilmente ganho ou perdido. 19. ; o número esperado de códons antes de um de parada é . 20. , : , ; total , comprimento esperado de fase códons. O DNA rico em AT é cheio de códons de parada, de modo que as fases abertas aleatórias são mais curtas e as longas se destacam mais. 21. ; . 22. Cada fase aberta maximal termina num códon de parada, e inícios de códon contêm códons de parada: cerca de fases aleatórias de ao menos códons, e de ao menos . 23. Uma bactéria de tem uns códons de parada e, portanto, cerca de fases de acaso de códons, mas quase nenhuma de ; seus genes têm em média códons e do DNA é codificante, de modo que uma fase aberta longa é quase sempre um gene. No verme, do DNA codifica, os éxons têm em média códons — menos que o limiar do acaso — e um milhão de fases aleatórias de códons os soterra. Os localizadores de genes eucariontes usam sinais de sítio de splicing, viés de códons num modelo oculto de Markov, homologia com proteínas conhecidas e, acima de tudo, transcritos sequenciados. 24. Uma leitura de um mensageiro processado se alinha ao genoma em dois pedaços separados por um íntron: a divisão marca os dois sítios de splicing base a base; a cobertura de leituras delineia os éxons e as leituras pareadas ligam éxons sucessivos num mesmo transcrito, resolvendo qual entre vários sítios candidatos de splicing é usado. 25. para o melhor acerto; cerca de bits para especificar sítios no genoma; umas fases de leitura de acaso de códons no genoma inteiro.