
সব বই

পেশাদার

1 Markets I: The Ecosystem and Exchange-Traded Marketsবাজার অনলাইনইংরেজি 2 Markets II: Rates, FX and Creditবাজার অনলাইনইংরেজি 3 Markets III: Commodities, Energy and Cryptoবাজার অনলাইনইংরেজি 4 Quantitative Methodsপদ্ধতি অনলাইনইংরেজি 5 Derivatives and Volatilityডেরিভেটিভস অনলাইনইংরেজি 6 Rates, Credit, XVA and Riskসুদহার, ঋণ ও ঝুঁকি অনলাইনইংরেজি 7 Research Craft: Predictors, Backtests, Measurement, Portfoliosগবেষণা অনলাইনইংরেজি 8 Strategies I: Equities and Futuresকৌশল অনলাইনইংরেজি 9 Strategies II: Volatility, Relative Value, Macro and the Bank Desksকৌশল অনলাইনইংরেজি 10 Microstructure and Executionএক্সিকিউশন অনলাইনইংরেজি 11 Market Making and High-Frequency Tradingমার্কেট মেকিং অনলাইনইংরেজি 12 Machine Learning for Marketsমেশিন লার্নিং অনলাইনইংরেজি 13 Low-Latency Softwareপ্রযুক্তি অনলাইনইংরেজি 14 Networks, Hardware and Trading Infrastructureপ্রযুক্তি অনলাইনইংরেজি 15 Research, Data and Risk Platformsপ্রযুক্তি অনলাইনইংরেজি 16 The Desk and the Firmপ্রতিষ্ঠান অনলাইনইংরেজি 17 The Industry: Firms, Roles and Careersক্যারিয়ার অনলাইনইংরেজি 18 Interviews I: Maths, Probability and Speedক্যারিয়ার অনলাইনইংরেজি 19 Interviews II: Markets, Trading Games and the Final Roundক্যারিয়ার অনলাইনইংরেজি 20 Interviews III: Codeক্যারিয়ার অনলাইনইংরেজি
অ্যাপ পরিচিতি Coach সাইন ইন পড়া শুরু করো

বইগুলো এখনো বাংলা ভাষায় পাওয়া যায় না — Português সংস্করণ দেখানো হচ্ছে।

Biologia · পরিভাষা

Sequenciamento massivamente paralelo কী?

Definição 4.2 Biologia universitária — 3.º ano · অধ্যায় 4 — Genômica e sequenciamento

Os instrumentos de segunda geração leem de milhões a bilhões de fragmentos ao mesmo tempo. No sequenciamento por síntese os fragmentos, com adaptadores ligados às suas extremidades, são fixados numa célula de fluxo de vidro e amplificados no lugar em aglomerados de moléculas idênticas; os aglomerados são então estendidos uma base por ciclo com nucleotídeos fluorescentes reversivelmente bloqueados, fotografados, desbloqueados e estendidos de novo, de modo que cada ciclo acrescenta uma base à leitura de cada aglomerado. As leituras têm 100 a 300 bp100\text{ a }300\,\mathrm{bp}, em geral vindas das duas pontas de um fragmento (extremidades pareadas), com taxa de erro de cerca de 10−310^{-3} por base, e uma corrida dá até 101210^{12} bases. Os instrumentos de terceira geração, de leituras longas, leem moléculas isoladas sem amplificação: observando uma polimerase incorporar nucleotídeos fluorescentes em tempo real, ou passando o DNA por um nanoporo proteico e registrando a corrente iônica, que cada sequência de bases modula a seu modo. Leituras de 10 a 100 kb10\text{ a }100\,\mathrm{kb} e mais atravessam as repetições que as leituras curtas não vencem, a uma taxa bruta de erro maior que o consenso reduz.
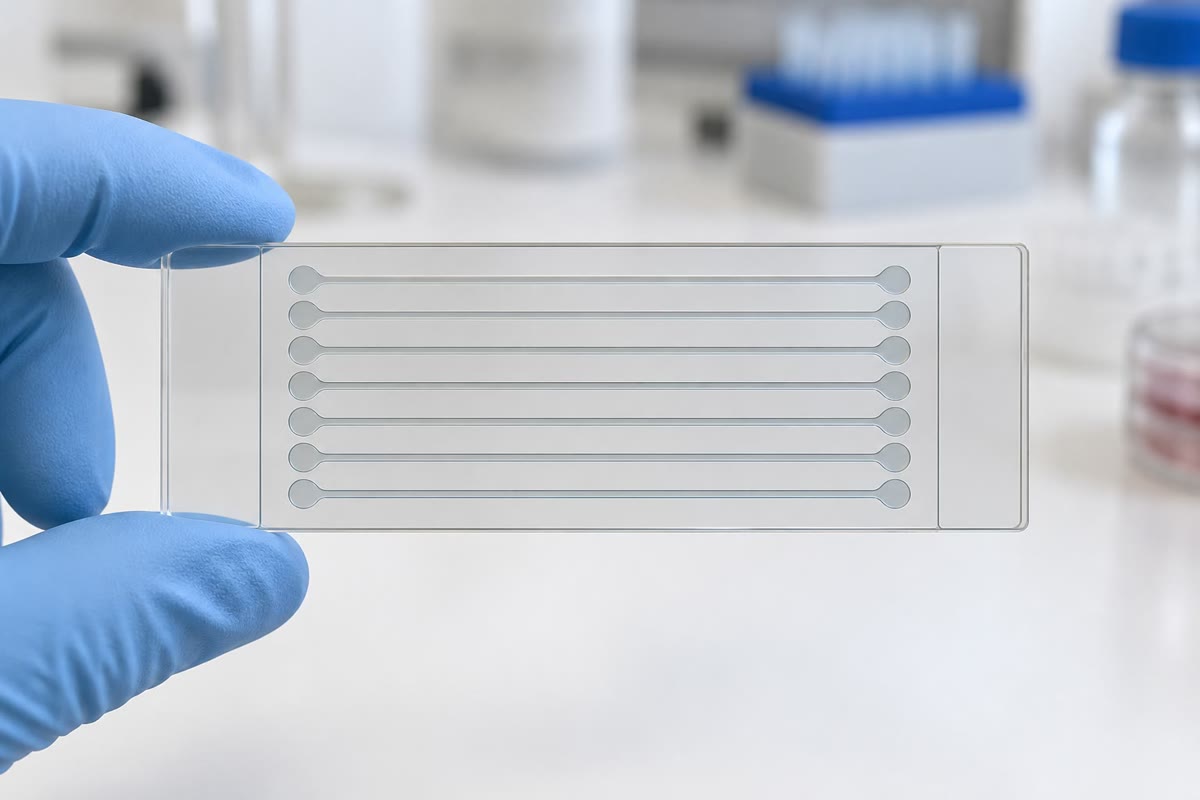
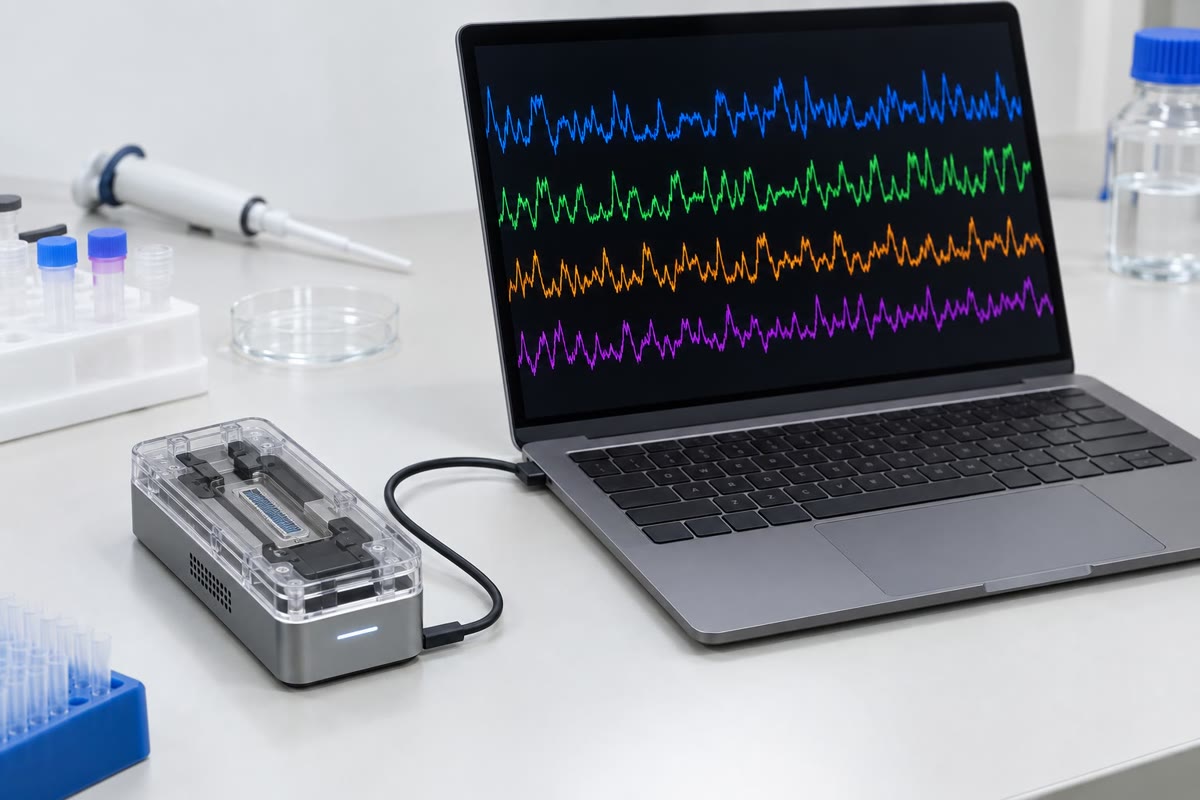
À esquerda: uma célula de fluxo, a lâmina de vidro sobre a qual bilhões de aglomerados de DNA são crescidos e lidos uma base por ciclo. À direita: um sequenciador de nanoporo do tamanho de um bolso, lendo moléculas isoladas como variações de uma corrente iônica. À esquerda: uma célula de fluxo, a lâmina de vidro sobre a qual bilhões de aglomerados de DNA são crescidos e lidos uma base por ciclo. À direita: um sequenciador de nanoporo do tamanho de um bolso, lendo moléculas isoladas como variações de uma corrente iônica.
À esquerda: uma célula de fluxo, a lâmina de vidro sobre a qual bilhões de aglomerados de DNA são crescidos e lidos uma base por ciclo. À direita: um sequenciador de nanoporo do tamanho de um bolso, lendo moléculas isoladas como variações de uma corrente iônica.

উদাহরণ

Exemplo 4.4 (Quanto basta)

Com c=5c = 5 a fração não sequenciada é e−5=0.7 %e^{-5} = 0.7\,\% — para um genoma de 3.2 Gb3.2\,\mathrm{Gb}, vinte milhões de bases em algumas dezenas de milhares de lacunas. Com c=10c = 10 ela é 4.5×10−54.5\times 10^{-5}, 150 kb150\,\mathrm{kb} no total. Os genomas humanos são sequenciados de rotina a c=30c = 30, não por causa das lacunas de cobertura (e−30≈10−13e^{-30} \approx 10^{-13}), mas porque cada base precisa ser lida várias vezes em cada um dos dois cromossomos para que uma variante heterozigota seja chamada com confiança contra uma taxa de erro de 10−310^{-3} por leitura. Os genomas bacterianos são sequenciados a c=50c = 50–100100 pela mesma razão e porque é barato. A fórmula também mostra o que a cobertura não resolve: uma repetição mais longa que uma leitura é um lugar onde o grafo de sobreposições se ramifica, e nenhuma quantidade de leituras curtas a resolve. É para isso que servem as leituras longas.

প্রসঙ্গসহ পড়ো →