Biologia universitária — 3.º ano · Bachelor Year 3
4Genômica e sequenciamento
O primeiro genoma completo de um organismo de vida livre, os de uma bactéria, foi publicado em 1995 depois de um ano de trabalho de uma equipe de quarenta pessoas. O genoma humano, com bilhões de pares de bases, custou treze anos e cerca de três bilhões de dólares a um consórcio internacional e foi declarado concluído em 2003. Hoje uma máquina de bancada lê um genoma humano numa noite por algumas centenas de dólares, um hospital sequencia o tumor de um paciente para escolher um fármaco, e um museu extrai e lê o genoma de um osso de quarenta mil anos. A tecnologia que tornou isso possível, a matemática que converte milhões de leituras curtas num genoma e o que os genomas prontos ensinaram sobre o tamanho, o conteúdo e a história de nosso DNA são o assunto deste capítulo. O capítulo seguinte retoma os algoritmos que comparam as sequências depois de obtidas.
4.1 Ler o DNA
Definição 4.1 (Sequenciamento por terminação de cadeia)
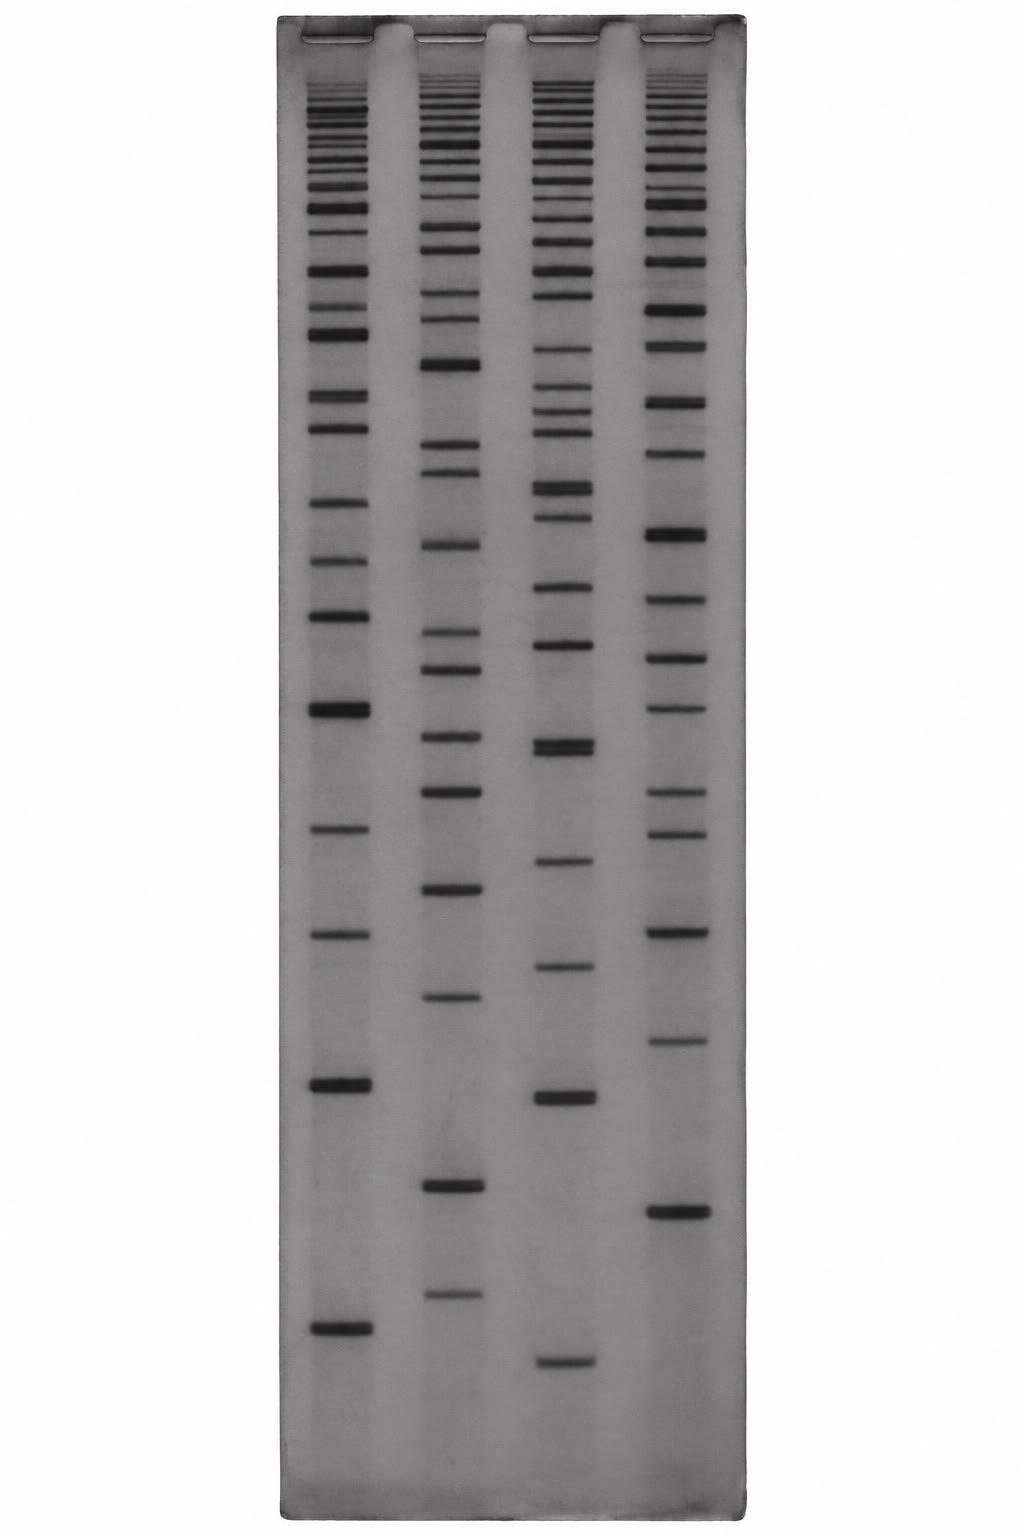
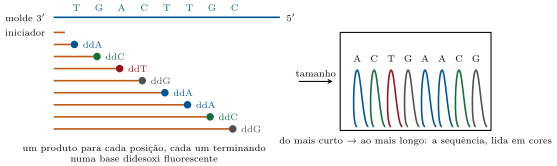
O sequenciamento de Sanger copia um molde de fita simples a partir de um iniciador com DNA-polimerase, na presença dos quatro nucleotídeos normais e de uma pequena proporção de didesoxinucleotídeos, que não têm a hidroxila 3 e por isso terminam a cadeia onde quer que sejam incorporados. Cada didesoxinucleotídeo carrega um corante fluorescente diferente. O produto é uma mistura de fragmentos, um para cada posição do molde, cada um terminando numa base de identidade conhecida; separados por tamanho num capilar de gel, eles passam por um detector em ordem de comprimento, e a sequência de cores é a sequência do molde. Uma corrida lê com taxa de erro abaixo de ; continua sendo o método para verificar uma construção ou um gene isolado.
Evidência. Sanger, Nicklen e Coulson publicaram o método em 1977 e o usaram naquele mesmo ano para ler os do fago X174 — o primeiro genoma de DNA completo — e, em 1981, os da mitocôndria humana. Fleischmann e colaboradores (1995) leram os de Haemophilus influenzae quebrando o genoma inteiro em fragmentos aleatórios, sequenciando deles e montando as leituras por computador — a estratégia de sequenciamento aleatório do genoma inteiro que todos os projetos posteriores ampliaram. ∎
Definição 4.2 (Sequenciamento massivamente paralelo)
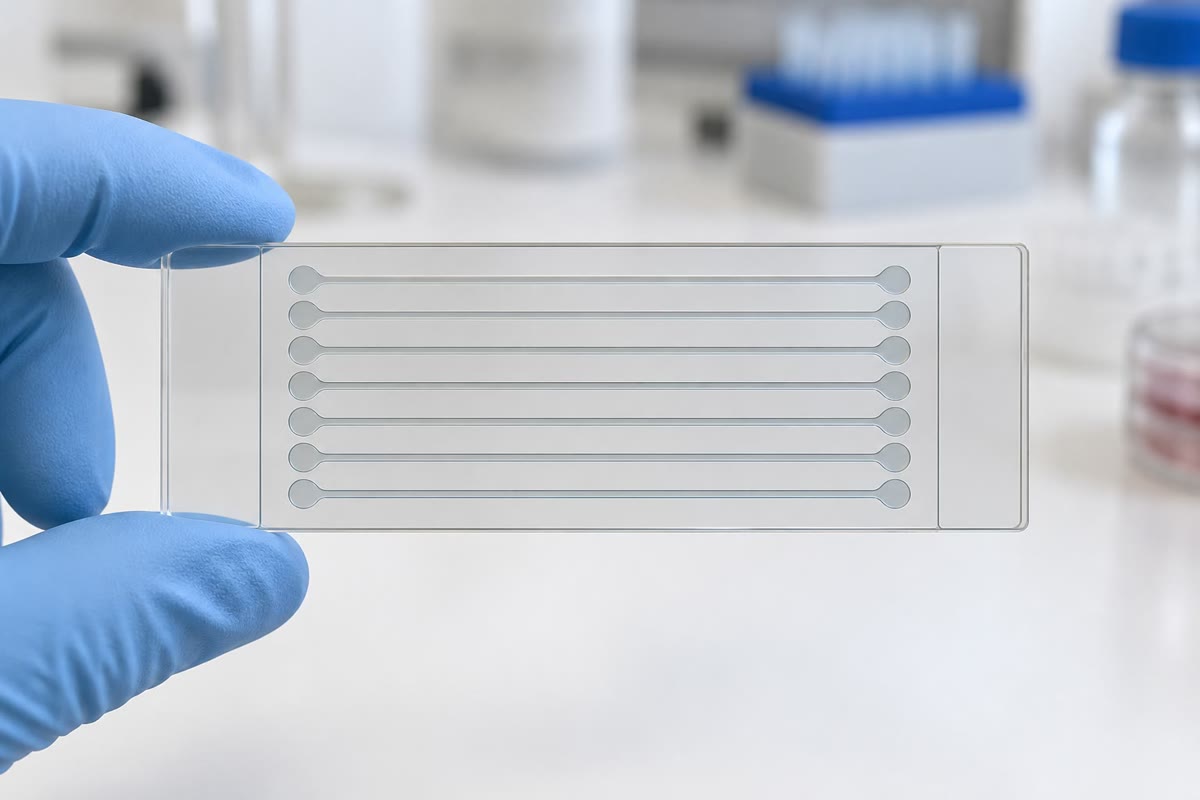
Os instrumentos de segunda geração leem de milhões a bilhões de fragmentos ao mesmo tempo. No sequenciamento por síntese os fragmentos, com adaptadores ligados às suas extremidades, são fixados numa célula de fluxo de vidro e amplificados no lugar em aglomerados de moléculas idênticas; os aglomerados são então estendidos uma base por ciclo com nucleotídeos fluorescentes reversivelmente bloqueados, fotografados, desbloqueados e estendidos de novo, de modo que cada ciclo acrescenta uma base à leitura de cada aglomerado. As leituras têm , em geral vindas das duas pontas de um fragmento (extremidades pareadas), com taxa de erro de cerca de por base, e uma corrida dá até bases. Os instrumentos de terceira geração, de leituras longas, leem moléculas isoladas sem amplificação: observando uma polimerase incorporar nucleotídeos fluorescentes em tempo real, ou passando o DNA por um nanoporo proteico e registrando a corrente iônica, que cada sequência de bases modula a seu modo. Leituras de e mais atravessam as repetições que as leituras curtas não vencem, a uma taxa bruta de erro maior que o consenso reduz.
Teorema 4.3 (Cobertura e lacunas num projeto de sequenciamento aleatório)
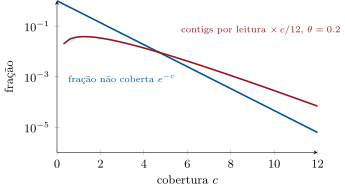
Sejam leituras de comprimento tomadas em posições aleatórias ao longo de um genoma de comprimento , e seja a cobertura, o número médio de leituras que cobrem uma base. Então uma dada base é coberta por um número de leituras que é Poisson de média : a fração do genoma que fica sem sequenciar é
e, se duas leituras só são reconhecidas como sobrepostas quando compartilham ao menos bases, de modo que , o número esperado de contigs (ilhas de leituras sobrepostas) é
e seu comprimento médio é , aproximadamente.
Demonstração. Os pontos de início das leituras caem ao acaso com densidade por base. Uma base é coberta pelas leituras que começam nas bases anteriores a ela; o número de inícios numa janela de comprimento é Poisson de média , e a probabilidade de nenhum é . Uma leitura é a mais à direita de seu contig se nenhuma outra leitura começa nas bases depois de seu próprio início (uma leitura que começasse mais tarde a sobreporia em menos de e não seria unida); essa probabilidade é e, como cada contig tem exatamente uma leitura mais à direita, o número esperado de contigs é . O comprimento médio do contig segue de dividido pelo número de contigs, corrigido pela fração não coberta. ∎
Exemplo 4.4 (Quanto basta)
Com a fração não sequenciada é — para um genoma de , vinte milhões de bases em algumas dezenas de milhares de lacunas. Com ela é , no total. Os genomas humanos são sequenciados de rotina a , não por causa das lacunas de cobertura (), mas porque cada base precisa ser lida várias vezes em cada um dos dois cromossomos para que uma variante heterozigota seja chamada com confiança contra uma taxa de erro de por leitura. Os genomas bacterianos são sequenciados a – pela mesma razão e porque é barato. A fórmula também mostra o que a cobertura não resolve: uma repetição mais longa que uma leitura é um lugar onde o grafo de sobreposições se ramifica, e nenhuma quantidade de leituras curtas a resolve. É para isso que servem as leituras longas.
4.2 Das leituras a um genoma
Definição 4.5 (Montagem e anotação)
A montagem reconstrói um genoma a partir de suas leituras por sobreposição: num grafo de sobreposições cada leitura é um nó unido às leituras que a sobrepõem; num grafo de de Bruijn, usado para bilhões de leituras curtas, cada -mero (subsequência de comprimento ) é um nó e o genoma é um caminho por eles. Os dois são rompidos por repetições mais longas que a leitura, que dão caminhos ramificados. Os contigs são ordenados e orientados em scaffolds por leituras de extremidades pareadas e por informação de longo alcance (leituras longas, mapas ópticos, mapas de contato cromossômico), e os scaffolds são colocados nos cromossomos. A qualidade de uma montagem é resumida pelo N50: o comprimento de contig tal que metade das bases montadas está em contigs pelo menos tão longos. A anotação então localiza os genes: nas bactérias, fases de leitura abertas mais longas do que o acaso daria; nos eucariontes, combinando sinais de sequência (sítios de splicing, promotores, viés de códons), homologia com proteínas conhecidas e transcritos sequenciados a partir do RNA. O resultado, para uma espécie, é um genoma de referência ao qual toda leitura posterior daquela espécie é alinhada, em vez de montada de novo.
Método 4.6 (De uma amostra às variantes)
Para um estudo de ressequenciamento de um indivíduo contra uma referência: (1) extraia o DNA, fragmente-o em e ligue adaptadores (a biblioteca); (2) sequencie até a cobertura necessária (30 para um genoma humano, 100 para um exoma, que captura os do genoma que codificam proteína); (3) alinhe cada leitura à referência, tolerando discordâncias; (4) em cada posição conte as bases nas leituras: uma posição em que cerca de metade das leituras discorda da referência é uma variante heterozigota, aquela em que quase todas discordam é homozigota, e aquela em que poucas discordam é erro; (5) filtre por profundidade, qualidade de base e equilíbrio entre as fitas; (6) anote cada variante com seu efeito sobre qualquer gene (sinônima, de sentido trocado, sem sentido, de splicing, de mudança de fase) e com sua frequência em bancos populacionais; (7) para um diagnóstico, guarde as variantes raras previstas como danosas em genes compatíveis com o fenótipo, e confirme por sequenciamento de Sanger.
4.3 Como são os genomas
Proposição 4.7 (Tamanho do genoma e número de genes)
Os tamanhos de genoma abrangem um fator de entre os eucariontes — na levedura, no verme, na mosca, num humano, numa cebola, num peixe pulmonado, no lírio Paris japonica —, ao passo que os números de genes mal abrangem um fator de : na levedura, no verme, na mosca, cerca de genes codificadores de proteína num humano, no arroz. Este é o paradoxo do valor C: o tamanho do genoma não mede complexidade, e o número de genes tampouco. O que varia é o conteúdo não codificante — íntrons, elementos transponíveis, repetições satélites — e o número de proteínas que um genoma pode produzir é multiplicado muito além de sua contagem de genes pelo splicing alternativo (Capítulo 2) e pela regulação, que é onde a complexidade de um organismo está escrita, na maior parte. Os genomas bacterianos, em contraste, são compactos, e seu tamanho de fato acompanha o número de genes: cerca de um gene por quilobase, codificante em E. coli.
Exemplo 4.8 (O genoma humano por conteúdo)
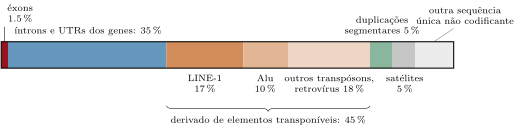
Dos : éxons codificadores de proteína, ; íntrons e regiões não traduzidas dos genes, cerca de ; elementos transponíveis e seus fósseis, cerca de — retrotranspósons LINE-1 , elementos Alu (mais de um milhão de cópias de uma sequência de ), retrovírus endógenos ; duplicações segmentares ; repetições simples e satélites, entre elas os centrômeros, cerca de ; o resto é sequência não codificante única, onde vivem os elementos regulatórios. Uns genes ainda codificam uma maquinaria LINE-1 ativa, e inserções novas ocorrem cerca de uma vez a cada vinte nascimentos. Cerca de do genoma está sob seleção purificadora detectável — bem mais que os éxons — e a maior parte disso é regulatória.
Definição 4.9 (Genômica comparativa)
Genes de duas espécies descendentes de um mesmo gene do ancestral comum são ortólogos; genes de uma mesma espécie descendentes de uma duplicação são parálogos. Blocos de cromossomo em que a ordem dos genes se conserva entre espécies são sintênicos; a sintenia permite localizar um gene num genoma a partir de sua posição em outro e revela os rearranjos que separam dois cariótipos (cerca de entre humano e camundongo). As sequências conservadas entre espécies distantes que não codificam proteína alguma — os elementos não codificantes conservados, alguns ultraconservados base a base ao longo de entre humano e peixe — são em sua maioria intensificadores de genes do desenvolvimento. As duplicações do genoma inteiro marcaram a história de várias linhagens: duas rodadas na origem dos vertebrados (os quatro agrupamentos Hox dos mamíferos contra o único dos invertebrados), uma no ancestral dos salmonídeos, uma na linhagem das leveduras, várias nas plantas com flor; os genes duplicados são em sua maioria perdidos ao longo de dezenas de milhões de anos, e os sobreviventes divergem em função.
Exemplo 4.10 (Humano e chimpanzé)
A sequência de cópia única alinhada difere entre humano e chimpanzé em das bases — uns milhões de substituições — e por inserções e deleções que juntas somam mais de cada genoma. Dois humanos diferem em cerca de uma base em mil, uns milhões de sítios, além de alguns milhares de variantes estruturais; dois chimpanzés, cuja população foi maior por mais tempo, diferem em bem mais. Uma criança carrega cerca de mutações novas ausentes nos dois pais, quatro quintos delas vindas do pai, e o número sobe cerca de duas por ano de idade paterna — a aritmética do Capítulo 3 aplicada às muitas divisões da espermatogênese.
4.4 Genomas e características
Definição 4.11 (Associação genômica ampla)
Um polimorfismo de nucleotídeo único (SNP) é uma posição em que duas bases ocorrem, cada uma em ao menos de uma população; cerca de dez milhões são comuns nos humanos. Um estudo de associação genômica ampla (GWAS) genotipa centenas de milhares de SNPs em milhares de pessoas com uma doença e em milhares sem ela, e pergunta, em cada SNP, se um alelo é mais frequente nos casos. Como se fazem um milhão de testes, um resultado só conta abaixo de um limiar de significância de cerca de ( dividido pelo milhão de testes efetivamente independentes). Os SNPs associados marcam uma região, e não uma variante causal, já que alelos vizinhos viajam juntos (desequilíbrio de ligação) ao longo de dezenas de quilobases. Para a maioria das doenças comuns, cada alelo associado desloca o risco em poucos por cento e a maior parte deles está em sequência regulatória; seu efeito combinado, somado ao longo de milhares de SNPs como um escore poligênico, explica uma fração da herdabilidade e prevê o risco mais ou menos tão bem quanto a história familiar.
Observação 4.12 (O que a genômica entregou e o que não entregou)
O sequenciamento foi decisivo onde um único gene tem grande efeito: vários milhares de doenças mendelianas já têm seu gene, e sequenciar o exoma de uma criança com um distúrbio sem diagnóstico dá um diagnóstico em cerca de um terço dos casos. Os genomas de tumores revelam quais condutores um tumor carrega e quais fármacos podem funcionar (Capítulo 11); os genomas de patógenos rastreiam surtos linhagem por linhagem (Capítulo 12); os genomas antigos reescreveram a pré-história humana, mostrando que as pessoas de fora da África carregam cerca de de DNA neandertal. Para as doenças comuns — diabetes, doença cardíaca, esquizofrenia — a genômica entregou milhares de efeitos pequenos e poucos mecanismos, e a promessa de prever a partir do genoma de uma pessoa saudável continua modesta. O genoma é uma lista de peças; a biologia de como as peças interagem não se lê nele.
4.5 Exercícios
Exercício 4.1 ★
Explique por que um didesoxinucleotídeo termina uma cadeia de DNA em crescimento, e por que uma reação de Sanger precisa conter as formas normal e didesoxi de cada nucleotídeo.
Solução
Solução de Exercício 4.1.
Um didesoxinucleotídeo não tem a hidroxila 3, de modo que nenhuma ligação fosfodiéster pode ser feita com o nucleotídeo seguinte e a cadeia para. Só com formas didesoxi, toda cadeia pararia na primeira posição; só com formas normais, nenhuma pararia. A mistura torna a terminação um evento aleatório em cada posição, de modo que os produtos formam uma escada completa, um comprimento para cada base do molde.
Exercício 4.2 ★
Uma corrida produz leituras pareadas de . Que cobertura isso dá de um genoma humano de ? E de um genoma bacteriano de ?
Solução
Solução de Exercício 4.2.
bases. Humano: . Bactéria: .
Exercício 4.3 ★
Defina contig, scaffold e N50. Uma montagem de tem dez contigs de e de . Qual é seu N50?
Solução
Solução de Exercício 4.3.
Um contig é uma sequência contígua montada a partir de leituras sobrepostas; um scaffold é um conjunto ordenado e orientado de contigs com lacunas de tamanho estimado entre eles; o N50 é o comprimento de contig em que os contigs ordenados alcançam metade das bases montadas. Aqui só os dez contigs de somam , além do ponto médio de (o sétimo chega a ): N50 .
Exercício 4.4 ★
Enuncie o paradoxo do valor C com dois exemplos, e diga o que responde principalmente pelo DNA em excesso dos genomas grandes.
Solução
Solução de Exercício 4.4.
O tamanho do genoma não acompanha a complexidade do organismo: uma cebola tem cinco vezes o DNA de um humano, um peixe pulmonado quarenta vezes; a levedura e o verme diferem dez vezes em DNA com números de genes semelhantes. O excesso é não codificante: elementos transponíveis e seus restos, íntrons, repetições satélites.
Exercício 4.5 ★★
Usando o Teorema 4.3, determine a cobertura necessária para deixar no máximo uma base em um milhão sem sequenciar, e o número esperado de contigs de um genoma de lido a com leituras de e sobreposição mínima de .
Exercício 4.6 ★★
Uma variante heterozigota é coberta por leituras. Supondo que cada leitura mostre um dos alelos com probabilidade , qual é a probabilidade de menos de leituras mostrarem o alelo variante (de modo que ele pudesse ser tomado por erro)? Use uma aproximação normal com média e desvio padrão . Por que é o padrão?
Solução
Solução de Exercício 4.6.
. A os dois alelos de um heterozigoto são quase sempre vistos muitas vezes, a cobertura é desigual (regiões ricas em GC recebem menos leituras, de modo que alguns sítios ficam com metade da média) e restam leituras bastantes para separar um alelo verdadeiro dos erros de .
Exercício 4.7 ★★
Um genoma tem uma repetição de presente em cópias. Explique por que uma montagem a partir de leituras de a colapsa, como fica o grafo resultante e que comprimento de leitura a resolveria.
Solução
Solução de Exercício 4.7.
Toda leitura de vinda de dentro da repetição é idêntica venha da cópia que vier, de modo que o montador constrói um único nó de com caminhos entrando e saindo; ele não tem como dizer qual entrada casa com qual saída, e a montagem se parte em lacunas, com a repetição presente uma única vez e com cobertura vezes a média. Leituras mais longas que a repetição mais flancos únicos dos dois lados — ou mais — atravessam cada cópia e a resolvem.
Exercício 4.8 ★★
Dois humanos diferem em uma base em mil. Quantas diferenças há em seus exomas ( de sequência codificadora)? Se dois terços das diferenças codificadoras são sinônimas ou benignas e o resto altera uma proteína, quantas variantes que alteram proteína uma pessoa carrega em relação a outra?
Solução
Solução de Exercício 4.8.
diferenças codificadoras; um terço, cerca de , altera a proteína.
Exercício 4.9 ★★
Um GWAS testa SNPs com limiar . Quantos falsos positivos se esperam se nenhum SNP estiver de fato associado? Um alelo de SNP eleva o risco de uma doença de frequência para . Explique por que um efeito desses é indetectável num estudo de mil pessoas e inútil para um indivíduo, mas pode ainda assim apontar para um mecanismo.
Solução
Solução de Exercício 4.9.
Falsos positivos esperados . Um risco relativo de sobre uma doença de muda alguns casos por mil; mil pessoas contêm cerca de vinte casos, longe demais do bastante para vê-lo (o poder cresce com o número de casos e com o quadrado do efeito). Para um indivíduo, ponto percentual não significa nada. Mas o alelo marca um gene cuja mudança modesta de atividade altera o risco da doença — o gene, e sua via, podem ser um alvo farmacológico cuja inibição completa tenha grande efeito.
Exercício 4.10 ★★★
Os genomas bacterianos são cerca de codificantes; o genoma humano, . Dê três hipóteses — de genética de populações, estrutural e regulatória — para a diferença e, para cada uma, uma observação genômica que a apoie ou a enfraqueça.
Solução
Solução de Exercício 4.10.
De genética de populações: nas bactérias, com populações enormes, a seleção remove até inserções levemente custosas; nos mamíferos, com populações efetivas pequenas, a deriva deixa acumular DNA não codificante levemente deletério — apoiada pela correlação inversa entre tamanho do genoma e tamanho populacional ao longo das linhagens, enfraquecida pelas exceções. Estrutural: os genomas eucariontes são invadidos por transpósons que as bactérias, com um viés a favor da deleção e sem refúgio meiótico para elementos egoístas, expurgam — apoiada pela correlação do tamanho do genoma com o conteúdo de transpósons. Regulatória: um desenvolvimento complexo precisa de mais DNA regulatório — apoiada pelos elementos não codificantes conservados em torno dos genes do desenvolvimento, enfraquecida pelo fato de que só do genoma humano mostra alguma seleção, de modo que a maior parte do DNA não codificante não é regulatória.
Exercício 4.11 ★★★
Deduza a contagem de contigs de Lander–Waterman para leituras de dois comprimentos misturados: leituras curtas de comprimento e leituras longas de comprimento , com as sobreposições contadas com o mesmo mínimo . (Trate cada leitura como a mais à direita de seu contig se nenhuma leitura de qualquer dos tipos começa dentro de seu próprio comprimento menos .) Mostre que algumas poucas leituras longas reduzem a contagem de contigs mais do que o mesmo número de bases em leituras curtas.
Solução
Solução de Exercício 4.11.
Os inícios dos dois tipos caem com densidade total . Uma leitura de comprimento é a mais à direita de seu contig se nenhuma leitura de qualquer dos tipos começa nas bases após ela: probabilidade . Logo, contigs . Uma leitura longa é a mais à direita com probabilidade exponencialmente menor que uma curta, e cada leitura longa também elimina a chance de uma lacuna ao longo de todo o seu comprimento; o mesmo número de bases em leituras curtas acrescenta muitos pontos de início, mas cada janela protegida é curta, e por isso as leituras longas vencem.
Exercício 4.12 ★★★
Argumenta-se que os quatro agrupamentos Hox dos mamíferos descendem de um só agrupamento por duas rodadas de duplicação do genoma inteiro na base dos vertebrados. Diga que padrão de parálogos pelo genoma, e que padrão nos genomas das lampreias e dos cordados invertebrados, essa hipótese prevê, e como se a distinguiria de duas duplicações independentes só do agrupamento.
Solução
Solução de Exercício 4.12.
Duas duplicações do genoma inteiro preveem que o padrão de quatro cópias seja genômico: quartetos de segmentos cromossômicos parálogos (paralogons) carregando as mesmas famílias gênicas na mesma ordem, com as duplicações datadas do mesmo momento para todas as famílias; um único agrupamento no anfioxo e em Ciona, que divergiram antes dos eventos; e nas lampreias, que divergiram por volta deles, um estado intermediário ou derivado de forma independente. Duplicações independentes só do agrupamento Hox preveem paralogons apenas para o Hox, vizinhos com histórias diferentes e datas de duplicação diferentes entre as famílias. Os paralogons genômicos e a datação compartilhada, como se observa, favorecem a duplicação do genoma inteiro.
4.6 Problema: dois genomas numa máquina
Problema 4.1
Problema de fim de semana — uma bactéria e um humano sequenciados na mesma corrida: as leituras repartidas, a cobertura e as lacunas calculadas, os contigs contados, as variantes heterozigotas chamadas contra a taxa de erro, o conteúdo do genoma humano pesado e um estudo de associação dimensionado, terminando na contagem de contigs em cobertura baixa, na cobertura que torna segura a chamada de uma variante e no número de mutações novas numa criança
Dados: uma corrida dá leituras de . Um genoma bacteriano tem ; o genoma humano, (haploide). Sobreposição mínima . Taxa de erro por base por leitura. Sequência codificadora humana ; o genoma é derivado de transpósons, com milhão de cópias Alu de . Dois humanos diferem em um sítio em . Taxa de mutação por base por geração.
Parte I — A bactéria.
- A bactéria recebe da corrida. Quantas leituras, e que cobertura?
- Que fração de seu genoma fica sem sequenciar? Quantas bases são essas?
- Calcule e o número esperado de contigs.
- Um ensaio piloto anterior usou apenas leituras. Cobertura, fração não coberta e número de contigs?
- O genoma contém cópias de um óperon de rRNA de . Explique o que acontece com elas na montagem e quantas pontas de contig só isso produz.
- A bactéria tem cerca de um gene por quilobase. Quantos genes e, se do genoma é codificante, qual é o comprimento médio de um gene?
Parte II — O humano.
- O resto da corrida vai para um genoma humano. Qual a cobertura do genoma diploide por cópia haploide (isto é, o total de bases dividido por )?
- Num sítio heterozigoto cada um dos dois alelos é coberto por cerca de metade das leituras. Com a cobertura da questão 7, qual é o número esperado de leituras que mostram cada alelo?
- Um erro mostra uma base errada numa leitura com probabilidade . Num sítio homozigoto coberto por leituras, qual é o número esperado de leituras que mostram uma base errada qualquer em particular ( cada)? Por que uma regra “chame uma variante se ao menos leituras e ao menos das leituras a mostrarem” rejeita os erros nessa cobertura?
- Quantos sítios heterozigotos um humano carrega (metade das diferenças entre dois genomas aleatórios está em cada um, grosso modo: tome um sítio em )? Quantos em sequência codificadora?
- As leituras são alinhadas a uma referência. Explique por que as leituras vindas de elementos Alu muitas vezes se alinham à cópia errada e que consequência isso tem para a chamada de variantes dentro deles.
- Uma criança é sequenciada junto com os dois pais. Quantas mutações novas você espera? Quantas leituras na criança, nessa cobertura, precisam mostrar uma variante ausente nos dois pais para que ela seja aceita, e por que a cobertura dos pais é tão importante quanto a da criança?
- Um laboratório clínico captura o exoma () e o sequencia a . Quantas leituras isso exige, e por que sai mais barato por paciente do que um genoma a , embora sua cobertura seja maior?
Parte III — O conteúdo de um genoma.
- Que fração do genoma humano é Alu, e que fração das leituras da questão 7 vem de elementos Alu?
- A referência tem , mas uma célula diploide contém ; e uma cebola de tem cerca de genes. Qual é a fração codificante do genoma da cebola, se seus genes têm em média de sequência codificadora?
- Humano e chimpanzé diferem em das bases alinhadas. Quantas substituições são essas em de sequência alinhável? Repartidas igualmente entre as duas linhagens ao longo de milhões de anos, que taxa de mutação por base por ano isso implica, e por geração de anos? Compare com a medida direta dada nos dados.
- Duas duplicações do genoma dos vertebrados deveriam dar até quatro cópias de cada gene ancestral. Os humanos têm cerca de genes e o cordado invertebrado Ciona cerca de . Que fração das duplicatas se perdeu, sob a hipótese de que o ancestral tinha ?
- Explique por que o número de genes é uma medida ruim de complexidade do organismo, usando a contagem de splicing alternativo do Capítulo 2 como um argumento.
- do genoma está sob seleção purificadora, mas apenas codifica proteína. O que provavelmente é o resto, e como você testaria um elemento candidato?
Parte IV — Um estudo de associação.
- SNPs são testados. Enuncie o limiar de Bonferroni para um erro por família de , e o número esperado de falsos positivos a .
- Uma doença tem prevalência de . Um alelo de risco de frequência eleva as chances em . Calcule o risco da doença para um portador de duas cópias, de uma cópia e de nenhuma, tomando o risco do não portador como . (Multiplique as chances.)
- Duzentos alelos desses são encontrados. Explique o que é um escore poligênico e por que o escore de uma pessoa no mais alto pode corresponder a um risco várias vezes maior, embora cada alelo quase nada faça.
- Explique por que um SNP que alcança significância em geral não é a variante causal, e que experimento identificaria a causal na região.
- Um genoma antigo de um osso de anos é sequenciado a . Que fração dele é lida? Por que isso ainda pode responder a perguntas sobre história populacional que um genoma moderno sozinho não responde?
- Resuma: o número de contigs da montagem piloto (questão 4), a cobertura por genoma haploide que dá cerca de leituras por alelo (questões 7–8) e o número de mutações novas numa criança (questão 12).
Solução
Solução de Problema 4.1.
1. leituras; . 2. : na prática, nenhuma base fica descoberta. 3. ; contigs : um contig em teoria, com lacunas apenas nas repetições. 4. ; fração não coberta , cerca de ; contigs . 5. Os sete óperons dão leituras idênticas e colapsam num único contig de , ao qual chegam sete flancos esquerdos únicos e do qual saem sete flancos direitos cujo pareamento é desconhecido: pontas de contig, sete lacunas. 6. Cerca de genes; sequência codificadora bp, gene médio de . 7. . 8. Cerca de leituras por alelo. 9. leitura mostrando uma dada base errada — a chance de três ou mais é de cerca de — e de são leituras; um erro não passa em nenhum dos dois testes, ao passo que um alelo heterozigoto verdadeiro é esperado em . 10. sítios heterozigotos; em sequência codificadora, . 11. Uma leitura de vinda de um Alu casa quase igualmente bem com muitas das milhão de cópias, e por isso é colocada na cópia errada ou recebe baixa confiança de mapeamento. As diferenças entre as cópias passam então a parecer variantes heterozigotas, e as variantes verdadeiras ficam escondidas entre elas: as chamadas de variantes dentro de Alu costumam ser filtradas, e os elementos são pontos cegos do sequenciamento de leituras curtas. 12. mutações novas. Cerca de leituras deveriam mostrar a variante na criança; mas, se o sítio de um dos pais é coberto por apenas cinco leituras, um alelo heterozigoto passa despercebido com probabilidade e uma variante herdada é chamada de nova — por isso os pais precisam ser sequenciados tão profundamente quanto a criança. 13. leituras, vinte vezes menos que o genoma: o custo de sequenciamento cai vinte vezes, mais do que o custo da etapa de captura. 14. bp, cerca de do genoma; das leituras, uns . 15. bp; . 16. substituições, por linhagem; taxa por base por ano, por geração de 25 anos — cerca do dobro da taxa medida em genealogias, , uma discrepância conhecida que sugere gerações mais longas no passado ou uma separação mais antiga. 17. Quatro cópias de dariam ; permanecem, de modo que, das cópias extras, só sobrevivem: das duplicatas se perderam. 18. O verme e o humano têm o mesmo número de genes; a complexidade está em como eles são usados — o splicing alternativo multiplica um gene em milhares de proteínas ( no Dscam), a regulação combina fatores de transcrição e intensificadores de maneiras específicas de cada tipo celular, os RNAs não codificantes acrescentam camadas, e as proteínas interagem em redes. 19. Elementos regulatórios (intensificadores, promotores, isolantes), genes de RNA não codificante, sinais de splicing e de localização, origens e sequências estruturais. Teste um candidato a intensificador colocando-o antes de um gene repórter num embrião transgênico e vendo onde o repórter é expresso, depois deletando o elemento no genoma com CRISPR e medindo os genes vizinhos. 20. ; a , falsos positivos esperados. 21. Chances do não portador ; com uma cópia, chances , risco ; com duas cópias, chances , risco . 22. O escore soma, sobre os alelos, o número de cópias de risco que a pessoa carrega, ponderado pelo logaritmo da razão de chances de cada alelo. A contagem tem média e desvio padrão ; o mais alto carrega cerca de alelos acima da média, e : quase o triplo das chances de uma pessoa média, a partir de alelos que individualmente mudam o risco em . 23. Os alelos dentro de um bloco de dezenas de quilobases são herdados juntos (desequilíbrio de ligação), de modo que qualquer um deles mostra a mesma associação; o SNP genotipado é apenas o que estava no arranjo. Para achar a variante causal: sequencie a região em casos e controles, estreite o conjunto estatisticamente e depois teste cada candidata — ensaios com repórter para a atividade intensificadora de cada alelo, edição de cada alelo em células com medida da expressão dos genes vizinhos, colocalização com sinais de loco de característica quantitativa de expressão. 24. do genoma é lido. Ele dá uma amostra direta de uma população num momento conhecido do passado — frequências alélicas antes de migrações e mesclas posteriores, o comprimento dos segmentos neandertais (longos, porque poucas gerações de recombinação os haviam quebrado) e daí uma data para a mescla — coisas que os genomas modernos só conseguem inferir por modelos. 25. Cerca de contigs no piloto; por genoma haploide, cerca de leituras por alelo; umas mutações novas numa criança.