
সব বই

পেশাদার

1 Markets I: The Ecosystem and Exchange-Traded Marketsবাজার অনলাইনইংরেজি 2 Markets II: Rates, FX and Creditবাজার অনলাইনইংরেজি 3 Markets III: Commodities, Energy and Cryptoবাজার অনলাইনইংরেজি 4 Quantitative Methodsপদ্ধতি অনলাইনইংরেজি 5 Derivatives and Volatilityডেরিভেটিভস অনলাইনইংরেজি 6 Rates, Credit, XVA and Riskসুদহার, ঋণ ও ঝুঁকি অনলাইনইংরেজি 7 Research Craft: Predictors, Backtests, Measurement, Portfoliosগবেষণা অনলাইনইংরেজি 8 Strategies I: Equities and Futuresকৌশল অনলাইনইংরেজি 9 Strategies II: Volatility, Relative Value, Macro and the Bank Desksকৌশল অনলাইনইংরেজি 10 Microstructure and Executionএক্সিকিউশন অনলাইনইংরেজি 11 Market Making and High-Frequency Tradingমার্কেট মেকিং অনলাইনইংরেজি 12 Machine Learning for Marketsমেশিন লার্নিং অনলাইনইংরেজি 13 Low-Latency Softwareপ্রযুক্তি অনলাইনইংরেজি 14 Networks, Hardware and Trading Infrastructureপ্রযুক্তি অনলাইনইংরেজি 15 Research, Data and Risk Platformsপ্রযুক্তি অনলাইনইংরেজি 16 The Desk and the Firmপ্রতিষ্ঠান অনলাইনইংরেজি 17 The Industry: Firms, Roles and Careersক্যারিয়ার অনলাইনইংরেজি 18 Interviews I: Maths, Probability and Speedক্যারিয়ার অনলাইনইংরেজি 19 Interviews II: Markets, Trading Games and the Final Roundক্যারিয়ার অনলাইনইংরেজি 20 Interviews III: Codeক্যারিয়ার অনলাইনইংরেজি
অ্যাপ পরিচিতি Coach সাইন ইন পড়া শুরু করো

বইগুলো এখনো বাংলা ভাষায় পাওয়া যায় না — Español সংস্করণ দেখানো হচ্ছে।

Biología · পরিভাষা

Secuenciación masiva en paralelo কী?

Definición 4.2 Biología universitaria — tercer año · অধ্যায় 4 — Genómica y secuenciación

Los instrumentos de segunda generación leen de millones a miles de millones de fragmentos a la vez. En la secuenciación por síntesis los fragmentos, con adaptadores ligados a sus extremos, se fijan a una celda de flujo de vidrio y se amplifican in situ en agrupaciones de moléculas idénticas; las agrupaciones se alargan luego una base por ciclo con nucleótidos fluorescentes y bloqueados de forma reversible, se fotografían, se desbloquean y se vuelven a alargar, de modo que cada ciclo añade una base a la lectura de cada agrupación. Las lecturas son de 100 a 300 bp100\text{ a }300\,\mathrm{bp}, casi siempre desde los dos extremos de un fragmento (extremos emparejados), con una tasa de error de unos 10−310^{-3} por base, y una carrera rinde hasta 101210^{12} bases. Los instrumentos de tercera generación, de lectura larga, leen moléculas sueltas sin amplificación: observando cómo una polimerasa incorpora nucleótidos fluorescentes en tiempo real, o haciendo pasar el ADN por un nanoporo proteico y registrando la corriente iónica, que cada secuencia de bases modula a su manera. Las lecturas de 10 a 100 kb10\text{ a }100\,\mathrm{kb} y más abarcan las repeticiones que las lecturas cortas no pueden, con una tasa bruta de error mayor que el consenso reduce.
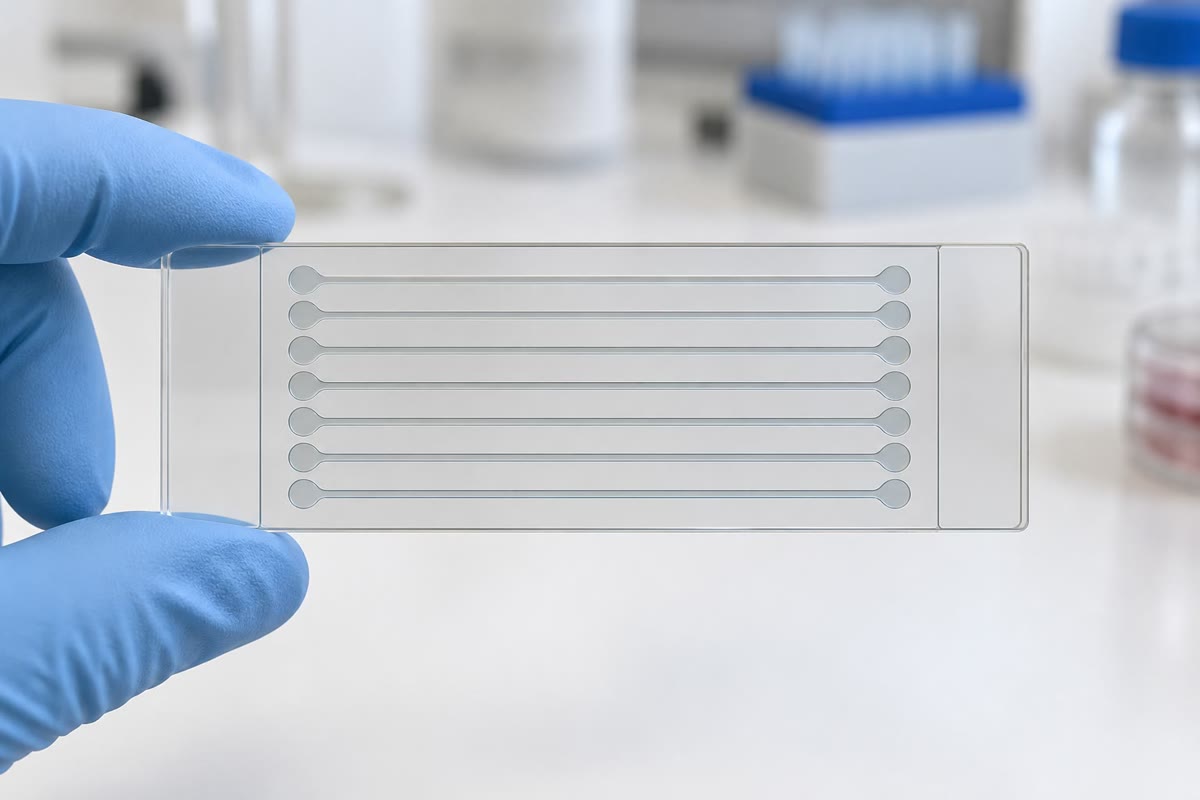
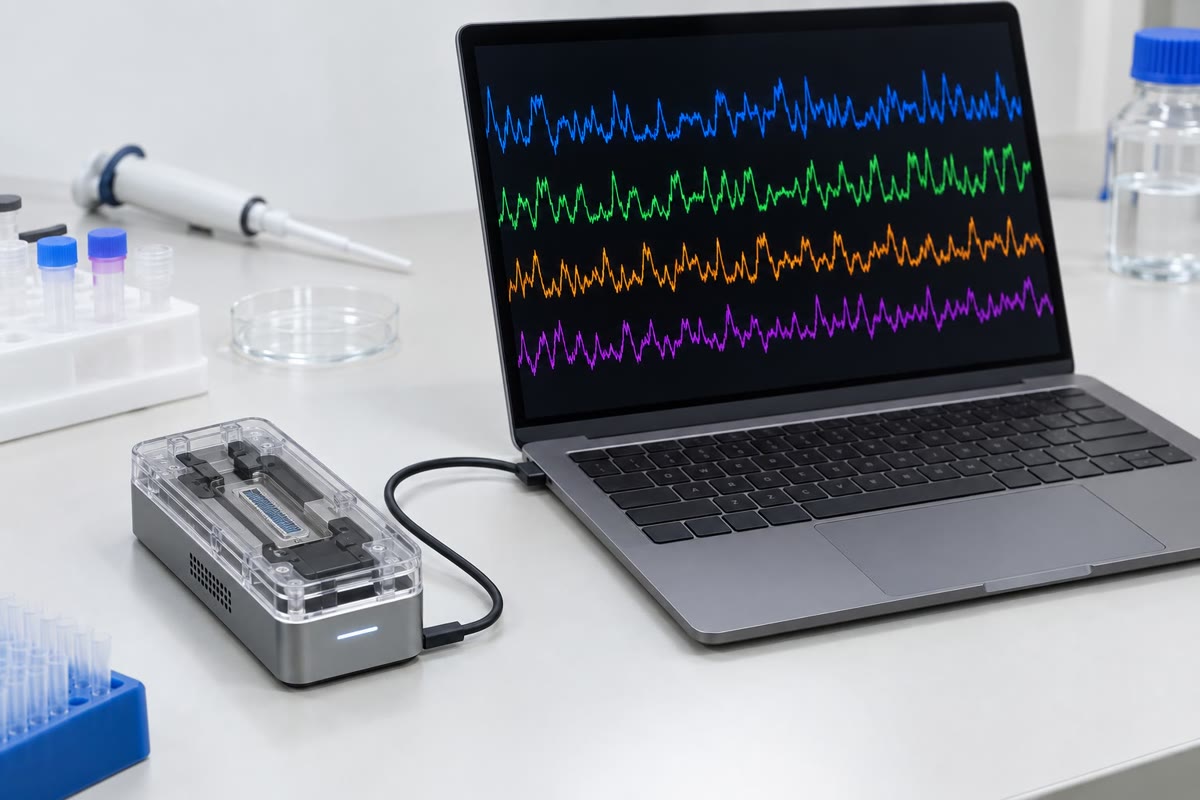
Izquierda: una celda de flujo, el portaobjetos de vidrio sobre el que se hacen crecer y se leen miles de millones de agrupaciones de ADN a razón de una base por ciclo. Derecha: un secuenciador de nanoporos de bolsillo que lee moléculas sueltas como cambios de una corriente iónica. Izquierda: una celda de flujo, el portaobjetos de vidrio sobre el que se hacen crecer y se leen miles de millones de agrupaciones de ADN a razón de una base por ciclo. Derecha: un secuenciador de nanoporos de bolsillo que lee moléculas sueltas como cambios de una corriente iónica.
Izquierda: una celda de flujo, el portaobjetos de vidrio sobre el que se hacen crecer y se leen miles de millones de agrupaciones de ADN a razón de una base por ciclo. Derecha: un secuenciador de nanoporos de bolsillo que lee moléculas sueltas como cambios de una corriente iónica.

উদাহরণ

Ejemplo 4.4 (Cuánto basta)

Con c=5c = 5 la fracción sin secuenciar es e−5=0.7 %e^{-5} = 0.7\,\% — para un genoma de 3.2 Gb3.2\,\mathrm{Gb}, veinte millones de bases en algunas decenas de miles de huecos. Con c=10c = 10 es 4.5×10−54.5\times 10^{-5}, 150 kb150\,\mathrm{kb} en total. Los genomas humanos se secuencian de rutina a c=30c = 30, no por los huecos de cobertura (e−30≈10−13e^{-30} \approx 10^{-13}), sino porque cada base ha de leerse varias veces en cada uno de los dos cromosomas para llamar con confianza una variante heterocigótica frente a una tasa de error de 10−310^{-3} por lectura. Los genomas bacterianos se secuencian a c=50c = 50–100100 por la misma razón y porque es barato. La fórmula muestra además lo que la cobertura no puede arreglar: una repetición más larga que una lectura es un punto donde el grafo de solapamientos se ramifica, y ninguna cantidad de lecturas cortas lo resuelve. Para eso están las lecturas largas.

প্রসঙ্গসহ পড়ো →