Biologie universitaire — 3e année · Bachelor Year 3
5Bio-informatique et analyse des séquences
Un biologiste qui vient de séquencer un gène d’un ver des grands fonds colle ses acides aminés dans un formulaire en ligne et apprend, trois secondes plus tard, que la protéine est une cousine lointaine d’une kinase humaine, avec d’identité sur résidus et une probabilité de que la ressemblance soit due au hasard. Derrière ces trois secondes se cachent un algorithme de programmation dynamique de 1970, une théorie statistique des alignements aléatoires, des matrices de substitution distillées de milliers de familles de protéines et une base de données de quelque cent milliards de résidus. Ce chapitre traite du raisonnement caché dans la boîte : comment deux séquences sont alignées de sorte que l’alignement soit démontrablement le meilleur, comment on fait dire quelque chose au score, comment on distingue une vraie correspondance d’une coïncidence, et comment on trouve des motifs dans un génome que personne n’a encore regardé. Les mathématiques sont élémentaires — une récurrence, un logarithme, une loi de Poisson — et il vaut la peine de les connaître, car toute conclusion tirée d’une comparaison de séquences repose sur elles.
5.1 Aligner deux séquences
Définition 5.1 (Alignement et score)
Un alignement de deux séquences les écrit l’une au-dessus de l’autre, avec des brèches (–) insérées de sorte que les colonnes apparient un résidu à un résidu ou un résidu à une brèche, et qu’aucune colonne n’apparie deux brèches. Son score est la somme sur les colonnes d’un score de substitution pour chaque paire de résidus et d’une pénalité de brèche pour chaque brèche : une pénalité linéaire par position de brèche ou, plus réaliste, une pénalité affine pour une suite de brèches, le coût d’ouverture étant supérieur au coût d’extension , puisqu’une insertion de plusieurs résidus est un seul événement évolutif. Un alignement global couvre les deux séquences d’un bout à l’autre ; un alignement local cherche la paire de sous-chaînes de meilleur score et néglige le reste, ce qu’on souhaite quand un domaine commun se trouve dans deux protéines par ailleurs sans lien.
Théorème 5.2 (Needleman–Wunsch)
Soient et , avec la pénalité de brèche linéaire . Définissons comme le meilleur score d’un alignement global des préfixes et . Alors , , et pour
est le score global optimal, un alignement optimal se retrouve en remontant depuis les choix qui ont produit chaque maximum, et le calcul entier prend étapes. La variante de Smith–Waterman pour l’alignement local ajoute comme quatrième possibilité dans le maximum, met les bords à , et lit la réponse dans la plus grande case du tableau.
Démonstration. Considérons la dernière colonne d’un alignement quelconque des deux préfixes. C’est l’une de trois choses : au-dessus de , au-dessus d’une brèche, ou une brèche au-dessus de . La retirer laisse un alignement de , de ou de respectivement, dont le score vaut au plus de cette paire ; et réciproquement chacun de ces alignements optimaux peut être prolongé par la dernière colonne correspondante. Le meilleur score se terminant par chaque type de colonne est donc de la paire plus courte augmenté du score de la colonne, et l’optimum est le plus grand des trois. Les bords sont forcés (seules des brèches sont possibles contre un préfixe vide). Une récurrence sur remplit le tableau ; le nombre de cases vaut . Pour l’alignement local, la possibilité supplémentaire signifie « commencer ici un nouvel alignement », ce qui fait de le meilleur score d’un alignement se terminant en , et le meilleur alignement local se termine quelque part. ∎
Exemple 5.3 (Un tableau quatre sur trois)
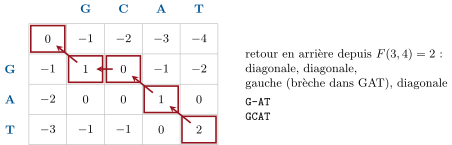
Aligner GAT et GCAT, avec pour une correspondance, pour un mésappariement et . Les bords valent en haut et sur le côté. En remplissant ligne par ligne : , , , ; , , , ; , , , . L’optimum vaut , et le retour en arrière — diagonale depuis (T,T), diagonale depuis (A,A), puis à gauche de (G,C) vers (G,G), puis diagonale — donne
trois correspondances et une brèche : .
Méthode 5.4 (Aligner deux séquences)
(1) Choisir le système de score : une matrice de substitution adaptée à la divergence attendue (BLOSUM62 pour des protéines de distance inconnue ; correspondance/mésappariement pour l’ADN), et des pénalités de brèche affines (typiquement ouverture , extension avec BLOSUM62). (2) Décider global ou local : global pour deux séquences que l’on croit homologues sur toute leur longueur, local sinon. (3) Remplir le tableau par la récurrence, en gardant pour chaque case un pointeur vers le choix qui a donné son maximum. (4) Remonter depuis (global) ou depuis la case maximale jusqu’à un zéro (local), en écrivant l’alignement de droite à gauche. (5) Juger le résultat non pas à son score brut mais à sa signification statistique (plus bas), et le regarder : de longues brèches, des suites de faible complexité et un alignement confiné à une répétition sont autant d’avertissements.
5.2 Le score : ce que vaut une correspondance
Définition 5.5 (Matrices de substitution)
Une matrice de substitution donne pour chaque paire d’acides aminés sous forme d’un score de log-cote :
où est la fréquence avec laquelle et se trouvent alignés dans des alignements de confiance de protéines apparentées, la fréquence à laquelle ils seraient appariés par hasard, et une échelle choisie pour rendre les entrées des entiers commodes. Un score positif signifie que la paire survient plus souvent chez les homologues que par hasard ; les scores d’identité sont les plus grands pour les acides aminés rares (tryptophane , cystéine dans BLOSUM62) et les plus petits pour les fréquents (leucine , alanine ), et les substitutions conservatives (isoleucine–valine ) ont un score positif tandis que les radicales (tryptophane–glycine ) l’ont négatif. Les matrices PAM (Dayhoff, 1978) ont été dérivées de protéines proches puis extrapolées à de plus grandes distances par multiplication matricielle ; les matrices BLOSUM (Henikoff et Henikoff, 1992) ont été comptées directement dans des blocs de séquences alignées regroupées à une identité donnée — BLOSUM62 à partir de blocs à — et elles sont la référence par défaut parce qu’elles ont été mesurées, et non extrapolées, à la distance où on les emploie.
Proposition 5.6 (Pourquoi la log-cote)
Pour qu’un système de score serve à l’alignement local, le score espéré d’une colonne appariée au hasard, , doit être négatif, et certains scores doivent être positifs ; sinon les alignements aléatoires croîtraient sans borne et le segment de meilleur score serait la séquence entière. Cela étant, tout système de ce genre équivaut à un système de log-cote pour certaines fréquences cibles — les alignements qu’il tiendra pour optimaux sont ceux dont les paires de résidus sont distribuées comme . Choisir la matrice, c’est donc choisir la divergence qu’on s’attend à détecter : une matrice pour des proches parents (BLOSUM80, PAM30) a des positifs plus tranchés et des négatifs plus sévères, une matrice pour des parents éloignés (BLOSUM45, PAM250) est plus plate.
Démonstration. Admis à ce niveau. ∎
Exemple 5.7 (Identité, similitude et zone crépusculaire)
Deux séquences protéiques aléatoires alignées de façon optimale avec des brèches atteignent par hasard d’identité. Au-dessus de d’identité sur une centaine de résidus, deux protéines sont presque sûrement homologues ; entre et s’étend la zone crépusculaire, où l’identité seule ne peut trancher et où les statistiques ci-dessous doivent le faire. Des homologues peuvent tomber bien en deçà de la zone : les sous-unités de l’hémoglobine et la myoglobine partagent d’identité, le lysozyme et l’-lactalbumine , et bien des paires de protéines de même repliement en partagent moins de , détectables seulement en comparant des profils ou des structures.
5.3 Interroger une base de données
Définition 5.8 (BLAST)
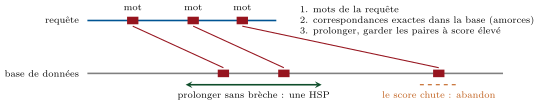
Aligner une requête de résidus contre une base de par programmation dynamique complète coûterait mises à jour de cases par recherche. BLAST (Altschul et ses collègues, 1990) échange un peu de sensibilité contre une vitesse mille fois plus grande en trois étapes : (1) dresser la liste des mots de la requête (trois résidus pour les protéines, onze bases pour l’ADN) et de leurs voisins de score élevé ; (2) balayer la base à la recherche de correspondances exactes de mots — les amorces de recherche ; (3) prolonger chaque amorce dans les deux directions sans brèche jusqu’à ce que le score descende d’une quantité fixée sous son meilleur, en gardant les paires de segments à score élevé (HSP), puis joindre les HSP voisines par une programmation dynamique avec brèches dans une bande étroite. Un vrai homologue contient presque toujours au moins un mot exact de trois résidus en commun ; une ressemblance fortuite en contient rarement un, et n’est jamais prolongée.
Théorème 5.9 (La statistique d’une correspondance fortuite)
Pour une requête de longueur cherchée dans une base de longueur totale , avec un système de score de score espéré négatif, le nombre d’alignements locaux sans brèche de score au moins qui surviennent par hasard suit une loi de Poisson de moyenne
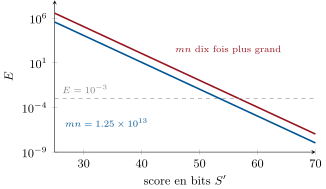
où et ne dépendent que du système de score et des fréquences des résidus ( est l’échelle de la matrice de log-cote). est la valeur E du score . En écrivant le score en bits, , la formule devient , et la probabilité qu’au moins un alignement fortuit atteigne vaut , qui égale lorsque est petit.
Démonstration partielle. La queue exponentielle est le théorème de Karlin–Altschul et elle est admise : le score maximal de segment d’une marche aléatoire à dérive négative a une distribution dont la queue décroît en , étant la racine positive de — exactement l’équation qui rend cohérente la matrice de log-cote. Cette queue étant donnée, le reste est du dénombrement. Les segments à score élevé peuvent commencer à l’une quelconque des paires de positions, ils sont rares et ils sont presque indépendants ; le nombre de ceux qui dépassent suit donc une loi de Poisson de moyenne proportionnelle à et à la probabilité de queue, . La probabilité qu’il n’y en ait aucun vaut . Le passage au score en bits est de l’algèbre : . Pour les alignements avec brèches la même forme vaut, et étant estimés par simulation. ∎
Exemple 5.10 (Lire une valeur E)
Une requête de résidus contre une base de résidus donne . Une correspondance de score bits a : c’est presque certainement un homologue. Une correspondance à a : onze scores de ce niveau sont attendus par hasard, et la correspondance ne veut rien dire. Le même alignement, au même score en bits, cherché dans une base dix fois plus grande, a un dix fois plus grand — la signification est une propriété de la recherche, non de la paire. Le seuil d’usage courant est pour un homologue sûr ; – mérite un second examen par une méthode de profil.
5.4 Profils, états cachés et motifs
Définition 5.11 (Alignement multiple et profils)
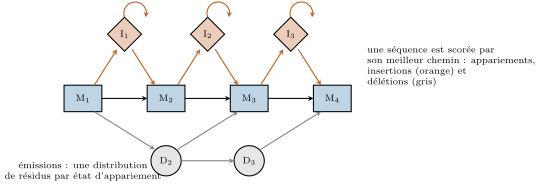
Un alignement multiple de séquences range une famille de séquences en colonnes de résidus homologues. La programmation dynamique exacte sur séquences coûte et devient impossible au-delà de trois ; les programmes pratiques alignent de façon progressive : d’abord la paire la plus proche selon un arbre guide, puis les séquences et les groupes s’ajoutent à l’alignement en croissance, avec des tours de raffinement. Un alignement achevé se résume en un profil : pour chaque colonne, la fréquence de chaque résidu et des brèches. Un modèle de Markov caché de profil formalise cela comme une chaîne d’états d’appariement, un par colonne conservée, chacun émettant des résidus avec ses propres probabilités, avec des états d’insertion et de délétion qui autorisent des résidus en trop ou manquants à chaque position ; le modèle d’une famille (une entrée Pfam) score une nouvelle séquence par la probabilité du meilleur chemin dans les états, et trouve des homologues bien en deçà de la zone crépusculaire de la comparaison par paires, parce qu’une colonne qui ne tolère que des résidus hydrophobes le dit, là où une séquence unique ne le peut pas.
Définition 5.12 (Motifs et contenu en information)
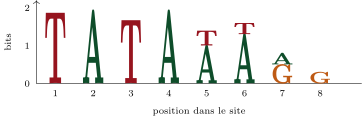
Un motif est un court patron — un site de facteur de transcription, un signal d’épissage, un site de phosphorylation — représenté par une matrice de poids-position donnant la fréquence de chaque base ou résidu à chaque position . Le contenu en information de la position vaut bits pour l’ADN, où est son entropie : bits pour une base invariante, pour une position où les quatre bases sont également probables. Le total se dessine en un logo de séquence, chaque position étant une pile de lettres dont la hauteur totale vaut et dont les lettres sont dimensionnées par leur fréquence.
Proposition 5.13 (Combien d’information il faut à un site)
Un site qui doit être trouvé fois dans un génome de positions, et nulle part ailleurs, a besoin d’environ bits de contenu en information : le motif doit ramener les positions candidates aux vraies, et chaque bit divise par deux le nombre de candidates. Les motifs observés des régulateurs bactériens bien étudiés collent à cette prédiction — les sites d’E. coli d’un répresseur qui se fixe en quelques dizaines d’endroits d’un génome de portent bits ; les motifs de facteurs de transcription eucaryotes, à bits dans un génome de , ne peuvent pas spécifier seuls leurs cibles, ce qui explique qu’ils agissent en combinaisons et dans la chromatine ouverte du Chapitre 1.
Démonstration. Une position au hasard correspond à un motif de contenu en information avec la probabilité voisine de (chaque bit de spécificité divise la chance par deux), de sorte que le nombre espéré de correspondances fortuites dans positions vaut . Pour que les vrais sites ressortent, cela doit être de l’ordre de ou moins : , c’est-à-dire . ∎
Exemple 5.14 (Correspondances fortuites attendues)
Un site de restriction de six bases fixées a bits et correspond à une position aléatoire avec la probabilité : environ fois dans un génome d’E. coli de lu sur les deux brins (le site est palindromique, donc une fois par position), et fois dans le génome humain. Un facteur eucaryote dont le motif porte bits correspond à millions de positions du génome humain, plusieurs milliers de fois plus que les gènes qu’il règle. Un motif seul est un piètre prédicteur dans un grand génome ; ce sont l’état de la chromatine, les motifs voisins et la conservation du site entre espèces qui font une prédiction.
5.5 De la séquence à la fonction
Méthode 5.15 (Annoter une protéine inconnue)
Étant donnée une nouvelle séquence codante : (1) la traduire dans le bon cadre et chercher un peptide signal, des segments transmembranaires et des régions de faible complexité ; (2) interroger les bases de protéines avec BLAST et lire les correspondances à , en notant si l’alignement couvre la protéine entière (un véritable orthologue) ou un segment (un domaine commun) ; (3) interroger les bases de domaines avec des HMM de profil, qui trouvent des familles que BLAST manque et découpent la protéine en domaines ; (4) inférer l’orthologie, et non la seule similitude, en vérifiant que la meilleure correspondance dans l’autre génome a la requête pour sa meilleure correspondance (meilleures correspondances réciproques) ou en plaçant la protéine dans un arbre de gènes (Chapitre 25) ; (5) transférer la fonction des orthologues avec prudence — un résidu catalytique conservé plaide pour une chimie conservée, un résidu manquant contre — et prédire la structure ; (6) traiter toute prédiction comme une hypothèse pour la paillasse.
Proposition 5.16 (La structure à partir de la séquence)
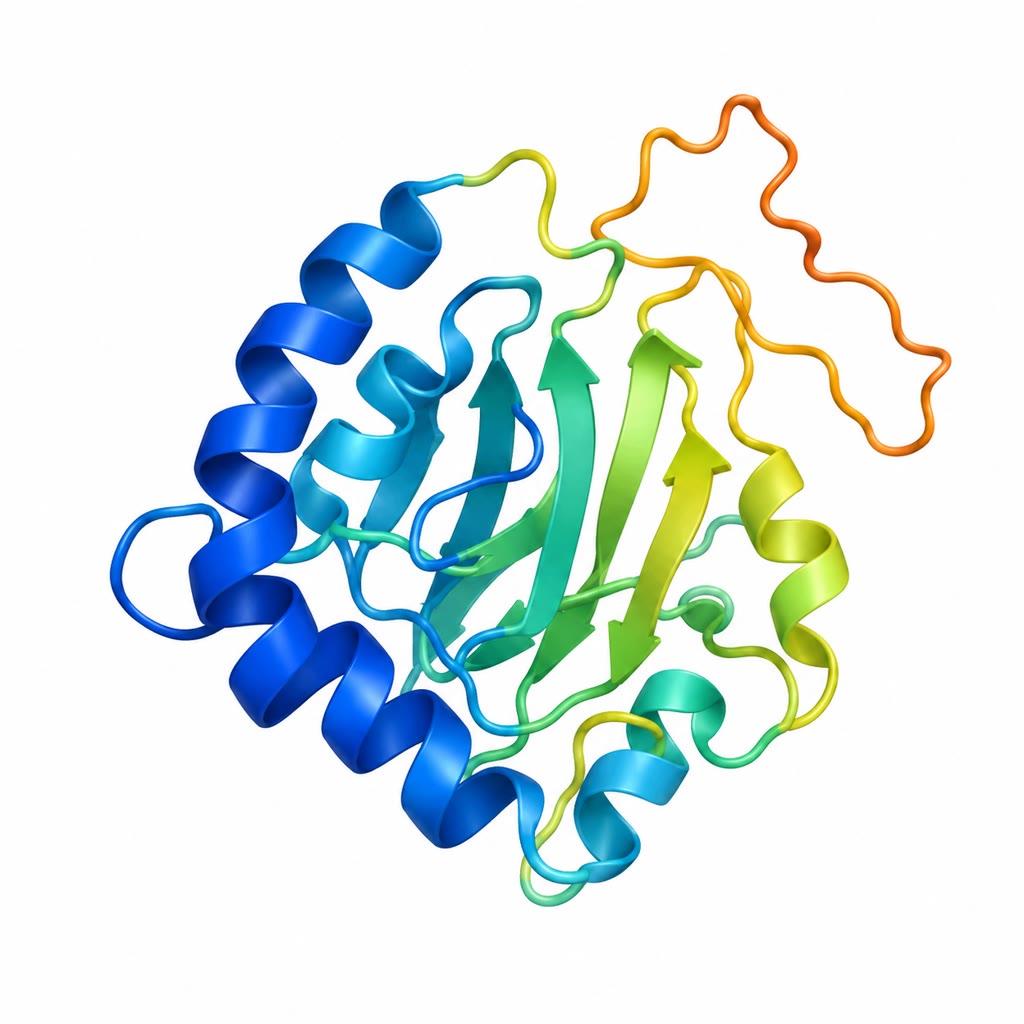
Le repliement d’une protéine est déterminé par sa séquence (Chapitre 7), et le calculer à partir de la séquence a été pendant cinquante ans le grand problème non résolu du domaine. Trois approches ont réussi tour à tour. La modélisation par homologie bâtit la structure d’une protéine sur celle d’un homologue résolu, de façon fiable au-dessus de d’identité. L’analyse de coévolution exploite le fait que deux résidus en contact dans le repliement tendent à muter ensemble dans un alignement multiple profond, de sorte que les paires de colonnes statistiquement couplées sont des contacts prédits, et qu’un nombre suffisant de contacts définit un repliement. Les méthodes d’apprentissage profond, entraînées sur les cent mille structures résolues et sur de tels alignements, prédisent aujourd’hui la plupart des structures de protéines globulaires à une exactitude proche de l’expérience (les évaluations CASP de 2020), et des bases de données contiennent une structure prédite pour à peu près toute séquence protéique connue. Ce qu’elles prédisent moins bien est ce qu’une structure unique ne saisit pas : les régions désordonnées, les conformations alternatives, l’effet d’une mutation ponctuelle et les complexes.
Remarque 5.17 (Les limites de l’inférence)
La plupart des annotations fonctionnelles des bases de données n’ont jamais été testées ; elles ont été transférées depuis un homologue, lui-même annoté par transfert. Les erreurs se propagent et se multiplient, et une annotation fausse sur une protéine bien connectée peut contaminer toute une famille. Les remèdes sont ceux d’en haut : distinguer l’orthologie de l’homologie, lire l’alignement, chercher les résidus catalytiques, et se souvenir que « protéine hypothétique » est une étiquette honnête que méritent encore un tiers des gènes de la plupart des génomes.
5.6 Exercices
Exercice 5.1 ★
Définir alignement global et alignement local, et donner une situation biologique qui appelle chacun d’eux.
Solution
Solution de Exercice 5.1.
Global : les deux séquences alignées d’un bout à l’autre, chaque résidu dans une colonne — pour deux protéines que l’on croit homologues sur toute leur longueur, par exemple des orthologues d’une enzyme de ménage. Local : la paire de sous-chaînes de meilleur score, le reste étant négligé — pour trouver un domaine commun (un domaine SH2 dans deux protéines de signalisation par ailleurs sans lien), ou un gène dans une longue séquence génomique.
Exercice 5.2 ★
Remplir le tableau de Needleman–Wunsch pour AGC contre AAC avec correspondance , mésappariement , brèche , et donner l’alignement optimal et son score.
Solution
Solution de Exercice 5.2.
Bords des deux côtés. Ligne A : . Ligne G : . Ligne C : . Optimum : AGC sur AAC sans brèche (correspondance, mésappariement, correspondance : ).
Exercice 5.3 ★
Dans BLOSUM62, tryptophane–tryptophane vaut et leucine–leucine . Expliquer, à partir de la formule de log-cote, pourquoi l’identité du résidu le plus rare vaut davantage.
Solution
Solution de Exercice 5.3.
. Le tryptophane est rare (), de sorte que la chance de voir deux tryptophanes alignés au hasard, , est minuscule, et qu’une paire de tryptophanes conservée est un signe d’homologie bien plus fort qu’une paire de leucines conservée () ; le rapport de log-cote est d’autant plus grand.
Exercice 5.4 ★
Qu’est-ce qu’une valeur E ? Une recherche renvoie une correspondance avec . Que signifie ce nombre, et cette correspondance est-elle un homologue ?
Solution
Solution de Exercice 5.4.
La valeur E est le nombre d’alignements de score au moins aussi élevé que l’on attendrait par hasard dans une recherche de cette requête contre une base de cette taille. signifie que trois scores de ce niveau sont attendus par hasard : la correspondance n’est pas une preuve d’homologie (elle peut en être une, mais la recherche ne peut pas le dire).
Exercice 5.5 ★★
Une requête de résidus est cherchée dans résidus. Calculer la valeur E des correspondances de scores en bits , et . Quel score en bits donne ? Comment la réponse change-t-elle si la requête ne fait que résidus ?
Solution
Solution de Exercice 5.5.
. ; ; . demande bits. Une requête de résidus a un dix fois plus petit, : bits suffisent — mais une requête courte atteint rarement même cela.
Exercice 5.6 ★★
Calculer le contenu en information d’un motif dont les quatre positions ont pour fréquences de bases (A, C, G, T) , , et . Combien de correspondances fortuites a-t-il dans un génome de ?
Solution
Solution de Exercice 5.6.
Contenus en information : , , , et avec , donc . Total bits. Correspondances fortuites : positions sur deux brins — le motif est presque inutile à lui seul.
Exercice 5.7 ★★
Expliquer pourquoi les pénalités de brèche affines sont plus réalistes que les linéaires, et pourquoi une pénalité d’ouverture très forte et une très faible donnent toutes deux de mauvais alignements.
Solution
Solution de Exercice 5.7.
Une insertion de plusieurs résidus est un seul événement mutationnel, de sorte que son coût ne devrait pas croître linéairement avec sa longueur : un coût d’ouverture plus un petit coût d’extension modélise cela. Une pénalité d’ouverture trop forte impose des mésappariements là où il faudrait une brèche et désaligne tout ce qui suit une vraie insertion ; une pénalité trop faible sème des brèches partout, apparie des résidus par hasard et gonfle l’identité.
Exercice 5.8 ★★
Une recherche BLAST d’une protéine humaine contre une base de mouche donne une meilleure correspondance à couvrant les résidus 50–180 d’une requête de résidus. La protéine de mouche est-elle l’orthologue de la protéine humaine ? Quel test supplémentaire feriez-vous ?
Solution
Solution de Exercice 5.8.
Pas forcément : l’alignement couvre un segment de résidus, ce qui est la signature d’un domaine commun plutôt que d’un orthologue aligné sur toute sa longueur. Test : chercher la protéine de mouche en retour dans le protéome humain (la requête en est-elle la meilleure correspondance, sur toute la longueur ?), identifier le domaine par un HMM de profil, et construire un arbre de gènes de la famille dans plusieurs espèces.
Exercice 5.9 ★★
Pourquoi les méthodes de profil détectent-elles des homologues que l’alignement par paires manque ? Donner l’exemple d’un motif de colonne qu’un profil saisit et qu’une séquence unique ne peut pas saisir.
Solution
Solution de Exercice 5.9.
Un profil enregistre, colonne par colonne, ce que la famille tolère : une position toujours hydrophobe sans jamais être le même résidu, un résidu catalytique invariant, une position qui est toujours une brèche dans la moitié de la famille. Un alignement par paires score chaque résidu contre un seul autre résidu et ne peut pas savoir qu’une valine en position 40 vaut « aussi bien » que l’isoleucine qui s’y trouve dans la requête. Le profil pondère en outre les colonnes conservées, de sorte qu’une faible similitude concentrée là où la famille est conservée devient significative.
Exercice 5.10 ★★★
Montrer que, sous un système de score de score espéré positif, l’alignement local de Smith–Waterman de deux longues séquences aléatoires a un score qui croît linéairement avec leur longueur, et expliquer pourquoi cela fait échouer la théorie des valeurs E. Qu’est-ce que cela implique pour l’alignement d’ADN avec correspondance et mésappariement à de GC ?
Solution
Solution de Exercice 5.10.
Avec un score espéré par colonne, le score cumulé le long de la diagonale de deux séquences aléatoires est une marche aléatoire à dérive positive : après colonnes il vaut environ , de sorte que le meilleur alignement local est pour l’essentiel la totalité, et que son score croît comme et non comme . La théorie de Karlin–Altschul, qui exige une dérive négative pour que les scores élevés soient de rares excursions, ne s’applique pas et aucun n’existe. Pour de l’ADN à de GC la chance d’une correspondance vaut , de sorte que le score espéré vaut : encore négatif, et la statistique tient ; mais un système tel que correspondance , mésappariement aurait une espérance de et rendrait le génome entier comme un seul alignement.
Exercice 5.11 ★★★
Le tableau de Needleman–Wunsch demande cases de mémoire ; pour deux chromosomes de cela fait . Décrire deux idées par lesquelles les aligneurs de génomes s’en dispensent (amorces et chaînage ; bande), et ce que chacune abandonne.
Solution
Solution de Exercice 5.11.
Amorces et chaînage : trouver par table de hachage les correspondances exactes ou presque exactes de -mers entre les deux séquences, garder celles qui s’alignent sur des diagonales cohérentes, les chaîner, et ne faire de programmation dynamique que dans les intervalles entre amorces chaînées ; on abandonne les alignements des régions sans amorce (les tronçons très divergents). Bande : si l’on sait les deux séquences presque colinéaires, ne calculer que les cases d’une bande de largeur autour de la diagonale, au coût au lieu de ; on abandonne tout alignement comportant une insertion plus large que la bande.
Exercice 5.12 ★★★
Un HMM de recherche de gènes bactériens a des états pour les trois positions du codon et pour l’ADN non codant. Expliquer comment le modèle peut distinguer le codant du non-codant sans aucune information sur les codons stop (penser à l’usage des codons), et pourquoi la même approche est bien plus difficile dans un génome humain.
Solution
Solution de Exercice 5.12.
Une séquence codante a une période de trois : les trois positions du codon ont des compositions en bases différentes (la troisième est la plus biaisée) et l’usage des codons est inégal dans chaque espèce. Un modèle à trois états codants en série, chacun émettant des bases avec la composition de cette position du codon, attribue à l’ADN codant une probabilité plus élevée que ne le fait l’état non codant, sur une fenêtre de quelques dizaines de codons, même sans les stops. Dans un génome humain les exons sont courts (), séparés par des introns de kilobases, de sorte que le signal codant est bref et interrompu ; le modèle doit en outre reconnaître les sites d’épissage, signaux faibles, et l’énorme quantité de séquence non codante produit beaucoup de faux segments codants.
5.7 Problème : une séquence des grands fonds
Problème 5.1
Problème du week-end — une protéine inconnue alignée à la main, cherchée dans les bases de données avec calcul de sa signification, son motif régulateur pesé en bits et son gène confronté à la statistique des cadres de lecture ouverts aléatoires, pour finir sur la valeur E de la meilleure correspondance, les bits qu’exige un site et la longueur qu’un cadre de lecture doit avoir pour être cru
Données : une protéine de résidus d’un annélide des grands fonds. Base de protéines : résidus. Génome du ver : , de GC. Score des alignements à la main : correspondance , mésappariement , brèche . Score en bits de la meilleure correspondance BLAST : ; de la dixième : .
Partie I — À la main.
- Aligner les peptides KQT et KAQT par la récurrence de Needleman–Wunsch : écrire le tableau et donner l’alignement optimal et son score.
- Recommencer avec Smith–Waterman (local) pour GATCAT contre ACAT : trouver le meilleur alignement local et son score.
- Combien de mises à jour de cases demande un alignement global de la protéine de résidus contre une protéine de résidus ? Et contre la base entière ?
- Si un ordinateur effectue mises à jour par seconde, combien de temps prend l’alignement complet de la base de la question 3 ? Pourquoi emploie-t-on BLAST à la place ?
- Un score d’identité BLOSUM62 vaut pour l’alanine () et pour le tryptophane (). Avec (unités de demi-bit), calculer les fréquences cibles et , ainsi que le rapport pour chacune. Interpréter.
- Deux protéines partagent d’identité sur résidus. Dire pourquoi l’identité seule ne peut pas trancher l’homologie ici, et ce qui le pourrait.
Partie II — La recherche.
- Calculer pour la requête contre la base, et .
- Calculer la valeur E de la meilleure correspondance () et de la dixième ().
- Quel score en bits correspond à pour cette recherche ? Et à ?
- La même meilleure correspondance est trouvée alors que la base a grossi jusqu’à résidus. Sa valeur E ?
- La dixième correspondance aligne les résidus 200–260 de la requête avec d’identité sur résidus. À l’aide de la valeur E, dire si c’est une preuve d’homologie, et ce qu’une recherche par profil pourrait y ajouter.
- La meilleure correspondance est une kinase humaine, alignée sur les résidus 10–290. Sa meilleure correspondance dans le protéome du ver est la requête. Qu’établit ce test réciproque, et que n’établit-il pas ?
Partie III — Un motif.
- En amont du gène se trouve un site candidat de facteur de transcription, de huit positions, de contenus en information bits. Total ?
- Combien de correspondances fortuites ce motif a-t-il dans le génome de (les deux brins, positions) ?
- Le facteur règle environ gènes. Combien de bits faudrait-il à un motif pour spécifier seul sites dans ce génome ?
- Quelle part du manque un second motif voisin de bits pourrait-il fournir, si les deux doivent se rencontrer à un espacement fixé ?
- Une position de fréquences pour (A, C, G, T) : calculer son entropie et son contenu en information.
- Expliquer, par l’argument informationnel, pourquoi les facteurs de transcription bactériens ont d’ordinaire des sites plus longs et plus conservés que les eucaryotes.
Partie IV — Le gène lui-même.
- Dans un ADN aléatoire de composition en bases uniforme, quelle est la probabilité qu’un codon soit un stop ? Quel est le nombre espéré de codons avant l’apparition d’un stop (loi géométrique) ?
- Le génome du ver a de GC. Recalculer la probabilité qu’un codon aléatoire soit un stop (TAA, TAG, TGA) avec les fréquences de bases réelles, et la longueur espérée du cadre de lecture. Dans quel sens une faible teneur en GC pousse-t-elle la recherche de gènes ?
- Quelle est la probabilité qu’un cadre de lecture ouvert aléatoire compte au moins codons ? Au moins ?
- Dans le génome de , six cadres sur deux brins donnent environ départs de codons. Combien de cadres de lecture ouverts aléatoires d’au moins codons attend-on ? Et d’au moins ?
- Expliquer pourquoi « cadre de lecture ouvert de plus de codons » est un chercheur de gènes utilisable chez une bactérie mais non dans ce génome, et ce qu’un chercheur de gènes eucaryote emploie à la place.
- Le gène du ver a six exons de en moyenne. Expliquer comment des lectures de séquençage d’ARN résolvent la structure en exons que la séquence génomique seule laisse ambiguë.
- Résumer : la valeur E de la meilleure correspondance (question 8), les bits nécessaires pour spécifier sites (question 15) et le nombre espéré de cadres de lecture aléatoires de codons dans le génome (question 22).
Solution
Solution de Problème 5.1.
1. Lignes K, Q, T ; colonnes K, A, Q, T ; bords et . Ligne K : ; ligne Q : ; ligne T : . Optimum : K-QT sur KAQT. 2. Meilleur score local : CAT contre CAT (résidus 4–6 de GATCAT avec 2–4 d’ACAT) ; ATCAT contre A-CAT vaut aussi . 3. mises à jour ; contre la base . 4. s, dix heures par requête ; les amorces de BLAST sautent presque tout le tableau et répondent en quelques secondes. 5. . Alanine : , , rapport . Tryptophane : , , rapport . Une paire de tryptophanes alignée est fois plus fréquente chez les homologues que par hasard, une paire d’alanines quatre fois seulement ; les paires d’alanines sont néanmoins plus nombreuses en valeur absolue, parce que l’alanine est fréquente. 6. tombe dans la zone crépusculaire, où les alignements aléatoires atteignent ; la valeur E de l’alignement, des motifs conservés aux bonnes positions, une correspondance avec un HMM de profil d’une famille connue, ou un repliement partagé trancheraient. 7. ; . 8. ; . 9. à bits ; à bits. 10. Dix fois : , toujours écrasant. 11. Avec , la dixième correspondance est ce que produit le hasard ; d’identité sur résidus n’est pas une preuve. Une recherche par profil des résidus 200–260 dans la base de domaines pourrait montrer si ce segment est un domaine connu, avec une statistique dont la comparaison par paires est dépourvue. 12. Des meilleures correspondances réciproques sur toute la longueur sont compatibles avec une orthologie un pour un ; elles ne la prouvent pas — une duplication dans une lignée après la séparation donne deux co-orthologues, et la perte du véritable orthologue peut laisser un paralogue comme meilleure correspondance. Le test est un arbre de gènes portant sur plusieurs espèces. 13. bits. 14. correspondances fortuites. 15. bits. 16. Une cooccurrence à espacement fixé ajoute les bits : , ce qui fournit des manquants ; environ bits (un facteur sur les correspondances fortuites) doivent venir d’ailleurs — accessibilité de la chromatine, autres partenaires. 17. bit ; bit. 18. Un facteur bactérien doit trouver ses quelques sites dans un génome de sans l’aide de la chromatine : il lui faut quelque bits, et ses sites sont longs et conservés. Un génome eucaryote est mille fois plus grand, ce qui demande dix bits de plus, et pourtant ses facteurs ont des sites courts ; ils obtiennent leur spécificité par la combinaison et par la restriction de la chromatine accessible, ce qui rend aussi la régulation plus évolutive, puisqu’un site court se gagne et se perd aisément. 19. ; le nombre espéré de codons avant un stop vaut . 20. , : , ; total , longueur espérée du cadre codons. Un ADN riche en AT est plein de stops, de sorte que les cadres ouverts aléatoires sont plus courts et que les longs ressortent davantage. 21. ; . 22. Chaque cadre ouvert maximal se termine sur un stop, et départs de codons contiennent stops : environ cadres aléatoires d’au moins codons, et d’au moins . 23. Une bactérie de compte quelque stops et donc environ cadres fortuits de codons, mais presque aucun de ; ses gènes font codons en moyenne et de l’ADN est codant, de sorte qu’un long cadre ouvert est presque toujours un gène. Chez le ver, de l’ADN code, les exons font codons en moyenne — moins que le seuil fortuit — et un million de cadres aléatoires de codons les submergent. Les chercheurs de gènes eucaryotes emploient les signaux de sites d’épissage, le biais d’usage des codons dans un modèle de Markov caché, l’homologie avec des protéines connues et, surtout, des transcrits séquencés. 24. Une lecture issue d’un messager épissé s’aligne sur le génome en deux morceaux séparés par un intron : la coupure marque les deux sites d’épissage à la base près ; la couverture en lectures délimite les exons et les lectures appariées relient les exons successifs en un seul transcrit, ce qui résout lequel de plusieurs sites d’épissage candidats est employé. 25. pour la meilleure correspondance ; environ bits pour spécifier sites dans le génome ; quelque cadres de lecture fortuits de codons dans le génome entier.