
সব বই

পেশাদার

1 Markets I: The Ecosystem and Exchange-Traded Marketsবাজার অনলাইনইংরেজি 2 Markets II: Rates, FX and Creditবাজার অনলাইনইংরেজি 3 Markets III: Commodities, Energy and Cryptoবাজার অনলাইনইংরেজি 4 Quantitative Methodsপদ্ধতি অনলাইনইংরেজি 5 Derivatives and Volatilityডেরিভেটিভস অনলাইনইংরেজি 6 Rates, Credit, XVA and Riskসুদহার, ঋণ ও ঝুঁকি অনলাইনইংরেজি 7 Research Craft: Predictors, Backtests, Measurement, Portfoliosগবেষণা অনলাইনইংরেজি 8 Strategies I: Equities and Futuresকৌশল অনলাইনইংরেজি 9 Strategies II: Volatility, Relative Value, Macro and the Bank Desksকৌশল অনলাইনইংরেজি 10 Microstructure and Executionএক্সিকিউশন অনলাইনইংরেজি 11 Market Making and High-Frequency Tradingমার্কেট মেকিং অনলাইনইংরেজি 12 Machine Learning for Marketsমেশিন লার্নিং অনলাইনইংরেজি 13 Low-Latency Softwareপ্রযুক্তি অনলাইনইংরেজি 14 Networks, Hardware and Trading Infrastructureপ্রযুক্তি অনলাইনইংরেজি 15 Research, Data and Risk Platformsপ্রযুক্তি অনলাইনইংরেজি 16 The Desk and the Firmপ্রতিষ্ঠান অনলাইনইংরেজি 17 The Industry: Firms, Roles and Careersক্যারিয়ার অনলাইনইংরেজি 18 Interviews I: Maths, Probability and Speedক্যারিয়ার অনলাইনইংরেজি 19 Interviews II: Markets, Trading Games and the Final Roundক্যারিয়ার অনলাইনইংরেজি 20 Interviews III: Codeক্যারিয়ার অনলাইনইংরেজি
অ্যাপ পরিচিতি Coach সাইন ইন পড়া শুরু করো

বইগুলো এখনো বাংলা ভাষায় পাওয়া যায় না — Français সংস্করণ দেখানো হচ্ছে।

Biologie · পরিভাষা

Séquençage massivement parallèle কী?

Définition 4.2 Biologie universitaire — 3e année · অধ্যায় 4 — Génomique et séquençage

Les instruments de deuxième génération lisent des millions à des milliards de fragments à la fois. Dans le séquençage par synthèse, les fragments, munis d’adaptateurs ligaturés à leurs extrémités, sont fixés sur une cellule de verre et amplifiés sur place en amas de molécules identiques ; les amas sont ensuite allongés d’une base par cycle avec des nucléotides fluorescents et réversiblement bloqués, imagés, débloqués, puis allongés de nouveau, de sorte que chaque cycle ajoute une base à la lecture de chaque amas. Les lectures font 100 aˋ 300 bp100\text{ à }300\,\mathrm{bp}, le plus souvent depuis les deux extrémités d’un fragment (extrémités appariées), avec un taux d’erreur d’environ 10−310^{-3} par base, et une course livre jusqu’à 101210^{12} bases. Les instruments de troisième génération, à longues lectures, lisent des molécules uniques sans amplification : en regardant une polymérase incorporer en temps réel des nucléotides fluorescents, ou en faisant passer l’ADN par un nanopore protéique et en enregistrant le courant ionique, que chaque suite de bases module à sa façon. Des lectures de 10 aˋ 100 kb10\text{ à }100\,\mathrm{kb} et davantage franchissent les répétitions que les lectures courtes ne franchissent pas, au prix d’un taux d’erreur brut plus élevé que le consensus réduit.
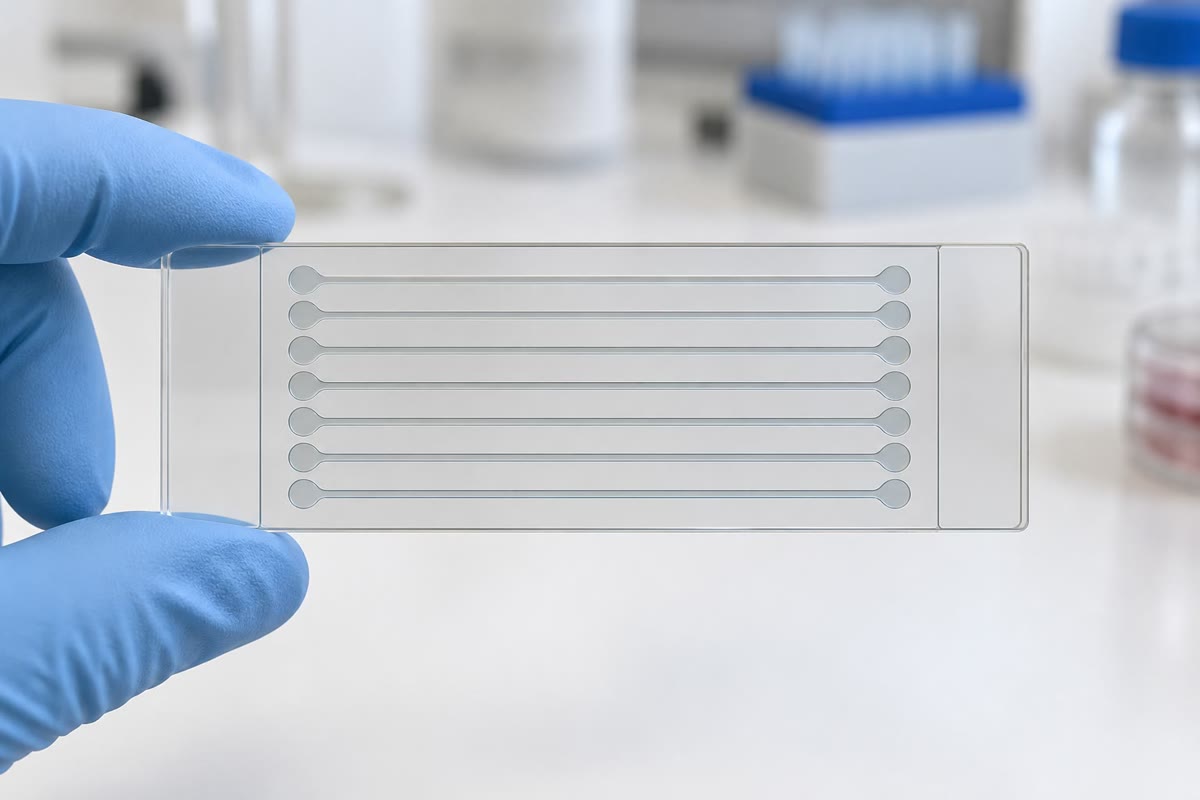
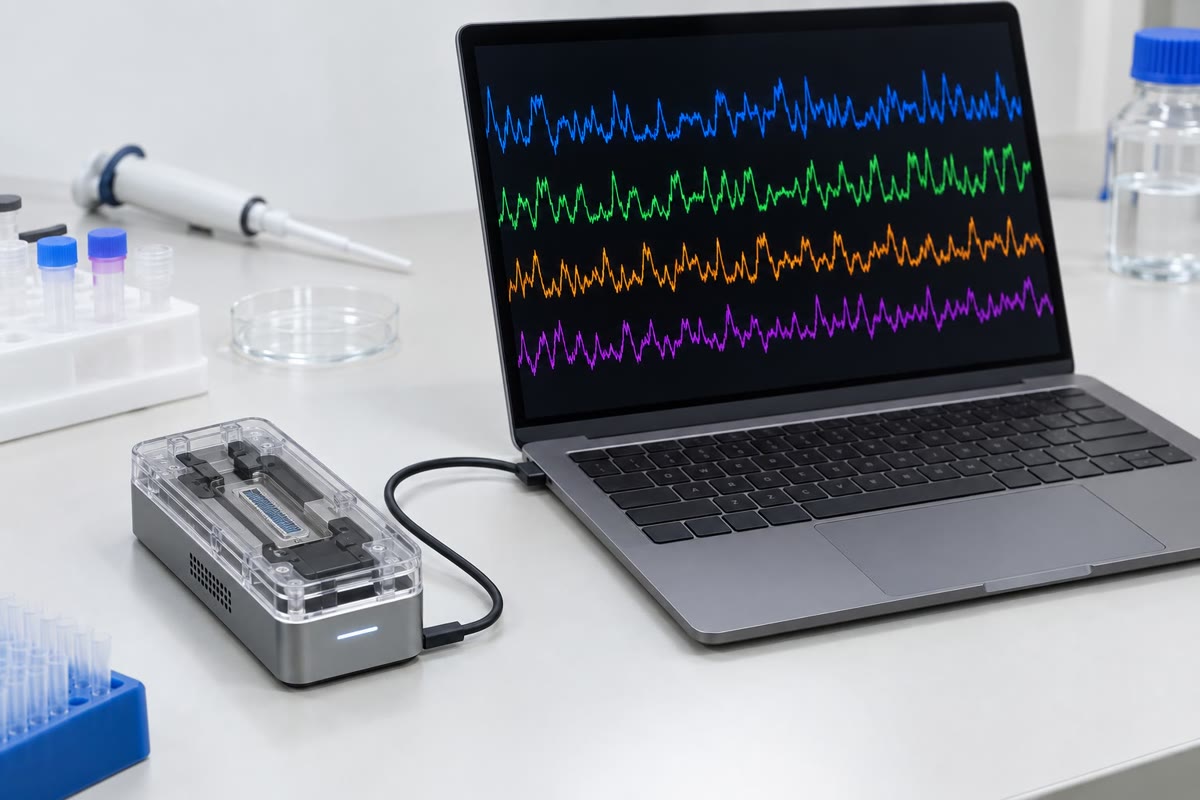
À gauche : une cellule de flux, la lame de verre sur laquelle des milliards d’amas d’ADN sont cultivés et lus une base par cycle. À droite : un séquenceur à nanopores de poche, qui lit des molécules uniques sous forme de variations d’un courant ionique. À gauche : une cellule de flux, la lame de verre sur laquelle des milliards d’amas d’ADN sont cultivés et lus une base par cycle. À droite : un séquenceur à nanopores de poche, qui lit des molécules uniques sous forme de variations d’un courant ionique.
À gauche : une cellule de flux, la lame de verre sur laquelle des milliards d’amas d’ADN sont cultivés et lus une base par cycle. À droite : un séquenceur à nanopores de poche, qui lit des molécules uniques sous forme de variations d’un courant ionique.

উদাহরণ

Exemple 4.4 (Combien suffit)

À c=5c = 5 la fraction non séquencée vaut e−5=0.7 %e^{-5} = 0.7\,\% — pour un génome de 3.2 Gb3.2\,\mathrm{Gb}, vingt millions de bases réparties en quelques dizaines de milliers de lacunes. À c=10c = 10 elle vaut 4.5×10−54.5\times 10^{-5}, soit 150 kb150\,\mathrm{kb} en tout. Les génomes humains sont couramment séquencés à c=30c = 30, non pas à cause des lacunes de couverture (e−30≈10−13e^{-30} \approx 10^{-13}), mais parce que chaque base doit être lue plusieurs fois sur chacun des deux chromosomes pour appeler un variant hétérozygote avec confiance contre un taux d’erreur de 10−310^{-3} par lecture. Les génomes bactériens sont séquencés à c=50c = 50–100100 pour la même raison et parce que c’est bon marché. La formule montre aussi ce que la couverture ne peut pas réparer : une répétition plus longue qu’une lecture est un endroit où le graphe de chevauchement se ramifie, et aucune quantité de lectures courtes ne la résout. C’est à cela que servent les longues lectures.

প্রসঙ্গসহ পড়ো →