Biologie universitaire — 3e année · Bachelor Year 3
4Génomique et séquençage
Le premier génome complet d’un organisme vivant libre, les d’une bactérie, a été publié en 1995 après un an de travail d’une équipe de quarante personnes. Le génome humain, milliards de paires de bases, a demandé treize ans et environ trois milliards de dollars à un consortium international, et a été déclaré achevé en 2003. Aujourd’hui une machine de paillasse lit un génome humain en une nuit pour quelques centaines de dollars, un hôpital séquence la tumeur d’un patient pour choisir un médicament, et un musée extrait et lit le génome d’un os vieux de quarante mille ans. La technique qui a rendu cela possible, les mathématiques qui transforment des millions de lectures courtes en un génome, et ce que les génomes achevés ont appris sur la taille, le contenu et l’histoire de notre ADN font l’objet de ce chapitre. Le chapitre suivant reprend les algorithmes qui comparent les séquences une fois qu’on les tient.
4.1 Lire l’ADN
Définition 4.1 (Séquençage par terminaison de chaîne)
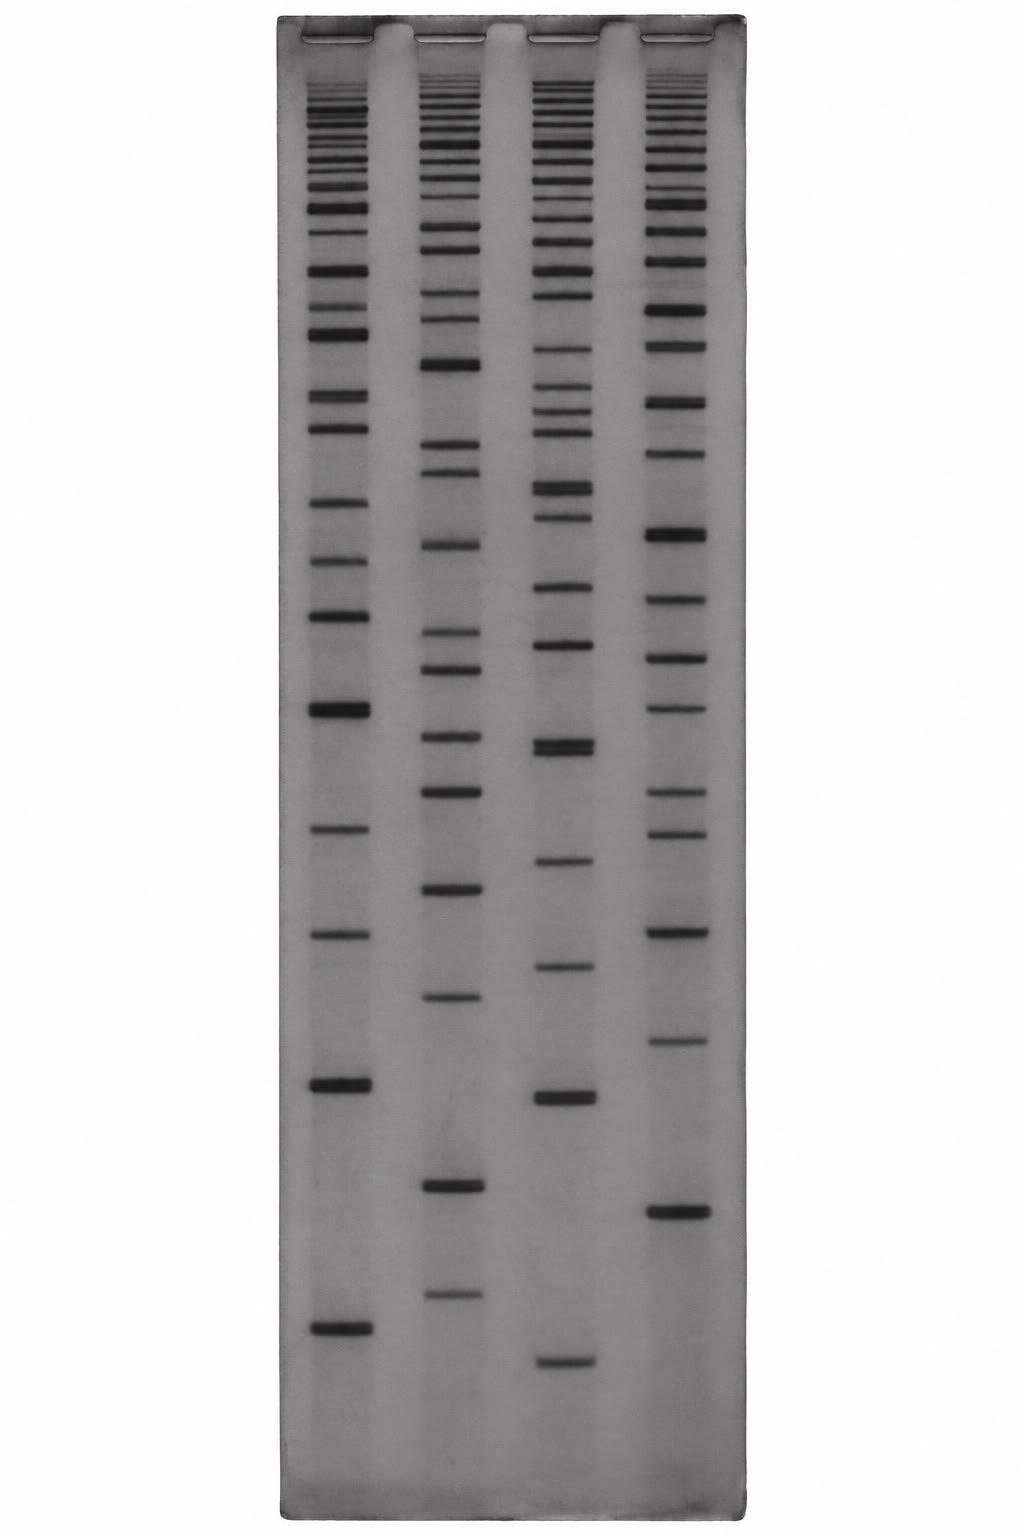
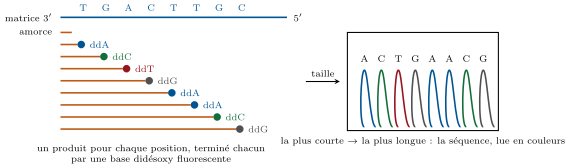
Le séquençage de Sanger recopie une matrice simple brin à partir d’une amorce, avec une ADN polymérase, en présence des quatre nucléotides normaux et d’une petite proportion de didésoxynucléotides, dépourvus de l’hydroxyle 3 et qui terminent donc la chaîne partout où ils sont incorporés. Chaque didésoxynucléotide porte un fluorophore différent. Le produit est un mélange de fragments, un pour chaque position de la matrice, se terminant chacun par une base d’identité connue ; séparés par la taille dans un capillaire de gel, ils passent devant un détecteur par ordre de longueur, et la suite des couleurs est la séquence de la matrice. Une course lit avec un taux d’erreur inférieur à ; elle reste la méthode pour vérifier une construction ou un gène isolé.
Faits expérimentaux. Sanger, Nicklen et Coulson ont publié la méthode en 1977 et s’en sont servis la même année pour lire les du phage X174 — le premier génome d’ADN complet — puis, en 1981, les de la mitochondrie humaine. Fleischmann et ses collègues (1995) ont lu les d’Haemophilus influenzae en brisant le génome entier en fragments aléatoires, en séquençant d’entre eux et en assemblant les lectures par ordinateur — la stratégie du shotgun de génome entier que tous les projets ultérieurs ont amplifiée. ∎
Définition 4.2 (Séquençage massivement parallèle)
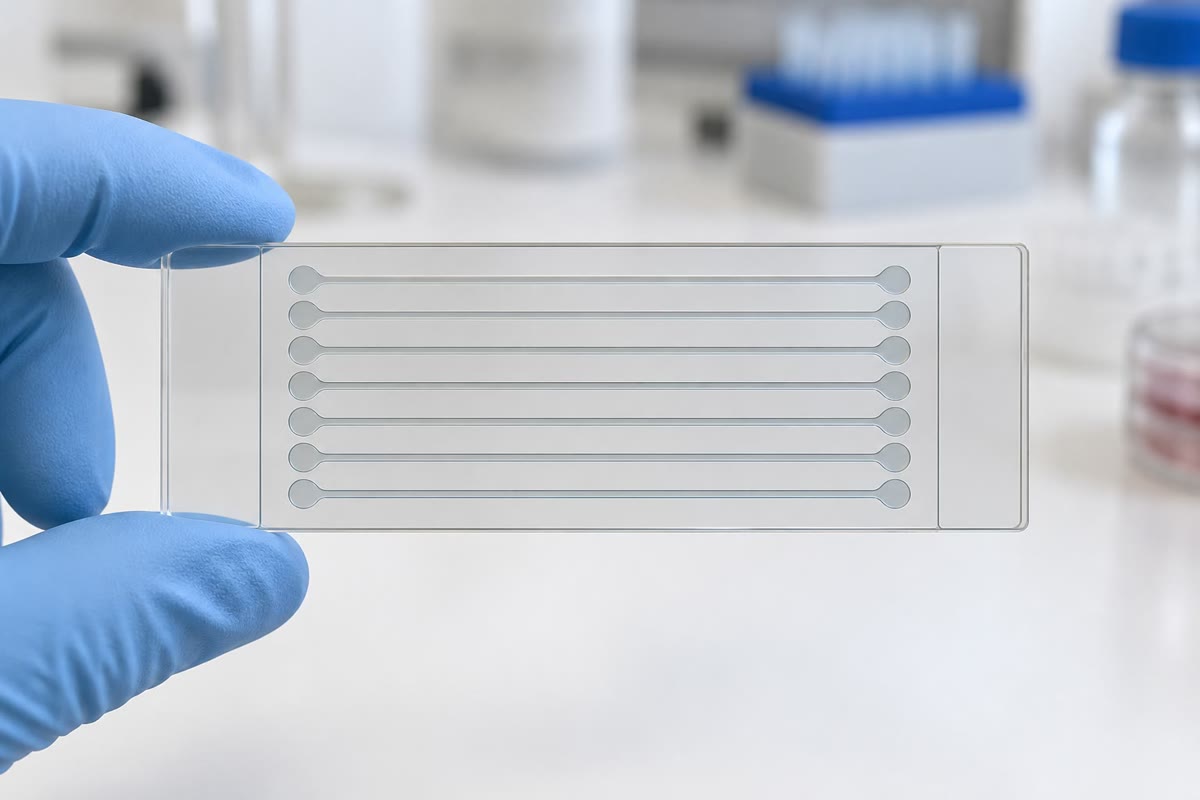
Les instruments de deuxième génération lisent des millions à des milliards de fragments à la fois. Dans le séquençage par synthèse, les fragments, munis d’adaptateurs ligaturés à leurs extrémités, sont fixés sur une cellule de verre et amplifiés sur place en amas de molécules identiques ; les amas sont ensuite allongés d’une base par cycle avec des nucléotides fluorescents et réversiblement bloqués, imagés, débloqués, puis allongés de nouveau, de sorte que chaque cycle ajoute une base à la lecture de chaque amas. Les lectures font , le plus souvent depuis les deux extrémités d’un fragment (extrémités appariées), avec un taux d’erreur d’environ par base, et une course livre jusqu’à bases. Les instruments de troisième génération, à longues lectures, lisent des molécules uniques sans amplification : en regardant une polymérase incorporer en temps réel des nucléotides fluorescents, ou en faisant passer l’ADN par un nanopore protéique et en enregistrant le courant ionique, que chaque suite de bases module à sa façon. Des lectures de et davantage franchissent les répétitions que les lectures courtes ne franchissent pas, au prix d’un taux d’erreur brut plus élevé que le consensus réduit.
Théorème 4.3 (Couverture et lacunes d’un projet shotgun)
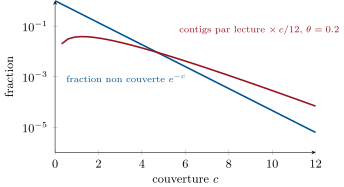
Soit lectures de longueur prises à des positions aléatoires le long d’un génome de longueur , et soit la couverture, nombre moyen de lectures couvrant une base. Une base donnée est alors couverte par un nombre de lectures qui suit une loi de Poisson de moyenne : la fraction du génome laissée non séquencée vaut
et si l’on ne reconnaît deux lectures comme chevauchantes que lorsqu’elles partagent au moins bases, en posant , le nombre espéré de contigs (îlots de lectures chevauchantes) vaut
et leur longueur moyenne vaut à peu près .
Démonstration. Les points de départ des lectures tombent au hasard avec la densité par base. Une base est couverte par les lectures qui commencent dans les bases qui la précèdent ; le nombre de départs dans une fenêtre de longueur suit une loi de Poisson de moyenne , et la probabilité qu’il n’y en ait aucun vaut . Une lecture est la plus à droite de son contig si aucune autre lecture ne commence dans les bases qui suivent son propre départ (une lecture commençant plus tard la chevaucherait de moins de et ne serait pas jointe) ; cette probabilité vaut , et comme chaque contig a exactement une lecture la plus à droite, le nombre espéré de contigs vaut . La longueur moyenne d’un contig s’obtient en divisant par le nombre de contigs, corrigé de la fraction non couverte. ∎
Exemple 4.4 (Combien suffit)
À la fraction non séquencée vaut — pour un génome de , vingt millions de bases réparties en quelques dizaines de milliers de lacunes. À elle vaut , soit en tout. Les génomes humains sont couramment séquencés à , non pas à cause des lacunes de couverture (), mais parce que chaque base doit être lue plusieurs fois sur chacun des deux chromosomes pour appeler un variant hétérozygote avec confiance contre un taux d’erreur de par lecture. Les génomes bactériens sont séquencés à – pour la même raison et parce que c’est bon marché. La formule montre aussi ce que la couverture ne peut pas réparer : une répétition plus longue qu’une lecture est un endroit où le graphe de chevauchement se ramifie, et aucune quantité de lectures courtes ne la résout. C’est à cela que servent les longues lectures.
4.2 Des lectures au génome
Définition 4.5 (Assemblage et annotation)
L’assemblage reconstitue un génome à partir de ses lectures par chevauchement : dans un graphe de chevauchement, chaque lecture est un sommet relié aux lectures qu’elle chevauche ; dans un graphe de de Bruijn, employé pour des milliards de lectures courtes, chaque -mer (sous-séquence de longueur ) est un sommet et le génome est un chemin qui les parcourt. Les deux sont brisés par les répétitions plus longues que la lecture, qui donnent des chemins ramifiés. Les contigs sont ordonnés et orientés en échafaudages grâce aux lectures à extrémités appariées et à des informations à longue portée (longues lectures, cartes optiques, cartes de contacts chromosomiques), et les échafaudages sont placés sur les chromosomes. La qualité d’un assemblage se résume par le N50 : la longueur de contig telle que la moitié des bases assemblées se trouve dans des contigs au moins aussi longs. L’annotation cherche ensuite les gènes : chez les bactéries, les cadres de lecture ouverts plus longs que le hasard ne le veut ; chez les eucaryotes, en combinant des signaux de séquence (sites d’épissage, promoteurs, usage des codons), l’homologie avec des protéines connues et des transcrits séquencés à partir de l’ARN. Le résultat, pour une espèce, est un génome de référence sur lequel toute lecture ultérieure de cette espèce est alignée plutôt que réassemblée.
Méthode 4.6 (D’un échantillon aux variants)
Pour une étude de reséquençage d’un individu contre une référence : (1) extraire l’ADN, le fragmenter à , ligaturer des adaptateurs (la banque) ; (2) séquencer à la couverture voulue (30 pour un génome humain, 100 pour un exome, qui capture les du génome qui codent une protéine) ; (3) aligner chaque lecture sur la référence, en tolérant des mésappariements ; (4) à chaque position, compter les bases dans les lectures : une position où la moitié environ des lectures s’écarte de la référence est un variant hétérozygote, une position où presque toutes s’en écartent un variant homozygote, une position où quelques-unes seulement s’en écartent une erreur ; (5) filtrer sur la profondeur, la qualité des bases et l’équilibre entre brins ; (6) annoter chaque variant par son effet sur les gènes (synonyme, faux-sens, non-sens, épissage, décalage du cadre) et par sa fréquence dans les bases de données de populations ; (7) pour un diagnostic, garder les variants rares prédits délétères dans des gènes compatibles avec le phénotype, et confirmer par un séquençage de Sanger.
4.3 À quoi ressemblent les génomes
Proposition 4.7 (Taille du génome et nombre de gènes)
Les tailles de génome couvrent un facteur chez les eucaryotes — pour la levure, pour le ver, pour la mouche, pour l’homme, pour l’oignon, pour un dipneuste, pour le lis Paris japonica — alors que les nombres de gènes couvrent à peine un facteur : chez la levure, chez le ver, chez la mouche, environ gènes codants chez l’homme, chez le riz. C’est le paradoxe de la valeur C : la taille du génome ne mesure pas la complexité, et le nombre de gènes non plus. Ce qui varie est le contenu non codant — introns, éléments transposables, répétitions satellites — et le nombre de protéines qu’un génome peut produire est multiplié bien au-delà de son nombre de gènes par l’épissage alternatif (Chapitre 2) et par la régulation, où s’écrit l’essentiel de la complexité d’un organisme. Les génomes bactériens, eux, sont compacts et leur taille suit bien le nombre de gènes : environ un gène par kilobase, de codant chez E. coli.
Exemple 4.8 (Le génome humain par son contenu)
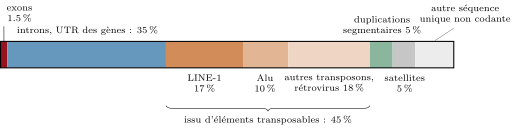
Sur les : exons codants, ; introns et régions non traduites des gènes, environ ; éléments transposables et leurs fossiles, environ — rétrotransposons LINE-1 , éléments Alu (plus d’un million de copies d’une séquence de ), rétrovirus endogènes ; duplications segmentaires ; répétitions simples et satellites, y compris les centromères, environ ; le reste en séquence unique non codante, où vivent les éléments régulateurs. Quelque gènes codent encore une machinerie LINE-1 active, et de nouvelles insertions surviennent à peu près une naissance sur vingt. Environ du génome est sous sélection purificatrice détectable — bien plus que les exons — et l’essentiel de cela est régulateur.
Définition 4.9 (Génomique comparée)
Des gènes de deux espèces descendus d’un même gène de leur ancêtre commun sont orthologues ; des gènes d’une même espèce descendus d’une duplication sont paralogues. Les blocs de chromosome où l’ordre des gènes est conservé entre espèces sont dits synténiques ; la synténie permet de localiser un gène dans un génome à partir de sa position dans un autre et révèle les remaniements qui séparent deux caryotypes (environ entre l’homme et la souris). Les séquences conservées entre espèces éloignées et qui ne codent aucune protéine — les éléments non codants conservés, dont certains sont ultraconservés à la base près sur entre l’homme et le poisson — sont pour la plupart des amplificateurs de gènes du développement. Des duplications du génome entier ont marqué l’histoire de certaines lignées : deux tours à l’origine des vertébrés (les quatre complexes Hox des mammifères contre l’unique complexe des invertébrés), un chez l’ancêtre des salmonidés, un dans la lignée des levures, plusieurs chez les plantes à fleurs ; les gènes dupliqués sont pour la plupart perdus en quelques dizaines de millions d’années, et les survivants divergent par leur fonction.
Exemple 4.10 (L’homme et le chimpanzé)
Les séquences en copie unique alignées diffèrent entre l’homme et le chimpanzé sur des bases — quelque millions de substitutions — et par des insertions et des délétions qui totalisent encore de chaque génome. Deux humains diffèrent à raison d’environ une base sur mille, soit quelque millions de sites, plus quelques milliers de variants structuraux ; deux chimpanzés, dont la population est plus grande depuis plus longtemps, un peu davantage. Un enfant porte environ mutations nouvelles absentes de ses deux parents, dont les quatre cinquièmes viennent du père, et ce nombre croît d’environ deux par année d’âge paternel — l’arithmétique du Chapitre 3 appliquée aux nombreuses divisions de la spermatogenèse.
4.4 Génomes et caractères
Définition 4.11 (Association pangénomique)
Un polymorphisme nucléotidique (SNP) est une position où deux bases apparaissent chacune chez au moins d’une population ; une dizaine de millions sont fréquents chez l’homme. Une étude d’association pangénomique (GWAS) génotype des centaines de milliers de SNP chez des milliers de personnes atteintes d’une maladie et des milliers d’indemnes, et demande à chaque SNP si un allèle est plus fréquent chez les cas. Comme un million de tests sont faits, un résultat ne compte qu’en deçà d’un seuil de signification voisin de ( divisé par le million de tests effectivement indépendants). Les SNP associés marquent une région et non un variant causal, puisque les allèles voisins voyagent ensemble (déséquilibre de liaison) sur des dizaines de kilobases. Pour la plupart des maladies fréquentes, chacun des allèles associés déplace le risque de quelques pour cent et se trouve le plus souvent en séquence régulatrice ; leur effet combiné, sommé sur des milliers de SNP en un score polygénique, explique une fraction de l’héritabilité et prédit le risque à peu près aussi bien que l’histoire familiale.
Remarque 4.12 (Ce que la génomique a tenu et n’a pas tenu)
Le séquençage a été décisif là où un seul gène a un grand effet : plusieurs milliers de maladies mendéliennes ont leur gène, et séquencer l’exome d’un enfant atteint d’un trouble non diagnostiqué donne un diagnostic dans un tiers des cas environ. Les génomes de tumeurs révèlent quels moteurs une tumeur porte et quels médicaments peuvent agir (Chapitre 11) ; les génomes de pathogènes retracent les épidémies souche par souche (Chapitre 12) ; les génomes anciens ont réécrit la préhistoire humaine, en montrant que les populations hors d’Afrique portent environ d’ADN de Néandertal. Pour les maladies fréquentes — diabète, maladies cardiaques, schizophrénie — la génomique a livré des milliers de petits effets et peu de mécanismes, et la promesse d’une prédiction à partir du génome d’une personne en bonne santé reste modeste. Le génome est une liste de pièces ; la biologie de leurs interactions ne s’y lit pas.
4.5 Exercices
Exercice 4.1 ★
Expliquer pourquoi un didésoxynucléotide termine une chaîne d’ADN en croissance, et pourquoi une réaction de Sanger doit contenir à la fois la forme normale et la forme didésoxy de chaque nucléotide.
Solution
Solution de Exercice 4.1.
Un didésoxynucléotide n’a pas d’hydroxyle 3, donc aucune liaison phosphodiester ne peut être formée avec le nucléotide suivant et la chaîne s’arrête. Avec les seules formes didésoxy, toute chaîne s’arrêterait à la première position ; avec les seules formes normales, aucune ne s’arrêterait. Le mélange fait de la terminaison un événement aléatoire à chaque position, si bien que les produits forment une échelle complète, une longueur pour chaque base de la matrice.
Exercice 4.2 ★
Une course produit lectures appariées de . Quelle couverture cela donne-t-il d’un génome humain de ? Et d’un génome bactérien de ?
Solution
Solution de Exercice 4.2.
bases. Homme : . Bactérie : .
Exercice 4.3 ★
Définir contig, échafaudage et N50. Un assemblage de compte dix contigs de et de . Quel est son N50 ?
Solution
Solution de Exercice 4.3.
Un contig est une séquence continue assemblée à partir de lectures chevauchantes ; un échafaudage est un jeu de contigs ordonnés et orientés, séparés par des lacunes de taille estimée ; le N50 est la longueur de contig à laquelle les contigs triés atteignent la moitié des bases assemblées. Ici les dix contigs de contiennent à eux seuls , au-delà du seuil de (le septième atteint ) : N50 .
Exercice 4.4 ★
Énoncer le paradoxe de la valeur C avec deux exemples, et dire ce qui explique surtout l’ADN en excès des grands génomes.
Solution
Solution de Exercice 4.4.
La taille d’un génome ne suit pas la complexité de l’organisme : un oignon a cinq fois l’ADN d’un homme, un dipneuste quarante fois ; la levure et le ver diffèrent d’un facteur dix en ADN pour des nombres de gènes voisins. L’excédent est non codant : éléments transposables et leurs restes, introns, répétitions satellites.
Exercice 4.5 ★★
À l’aide du Théorème 4.3, trouver la couverture nécessaire pour ne laisser au plus qu’une base sur un million non séquencée, et le nombre espéré de contigs pour un génome de lu à avec des lectures de et un chevauchement minimal de .
Exercice 4.6 ★★
Un variant hétérozygote est couvert par lectures. En supposant que chaque lecture montre l’un ou l’autre allèle avec la probabilité , quelle est la probabilité que moins de lectures montrent l’allèle variant (au point qu’on puisse le prendre pour des erreurs) ? Utiliser une approximation normale de moyenne et d’écart type . Pourquoi est-il la norme ?
Solution
Solution de Exercice 4.6.
. À , les deux allèles d’un hétérozygote sont presque toujours vus de nombreuses fois, la couverture est inégale (les régions riches en GC reçoivent moins de lectures, de sorte que certains sites n’en voient que la moitié de la moyenne), et il reste assez de lectures pour distinguer un vrai allèle des erreurs à .
Exercice 4.7 ★★
Un génome contient une répétition de présente en copies. Expliquer pourquoi un assemblage à partir de lectures de l’effondre, à quoi ressemble le graphe obtenu, et quelle longueur de lecture la résoudrait.
Solution
Solution de Exercice 4.7.
Toute lecture de prise à l’intérieur de la répétition est identique quelle que soit la copie d’où elle vient, de sorte que l’assembleur construit un seul sommet de avec chemins entrants et sortants ; il ne peut pas dire quelle entrée va avec quelle sortie, et l’assemblage se brise en lacunes, la répétition n’étant présente qu’une fois avec une couverture fois la moyenne. Des lectures plus longues que la répétition et ses flancs uniques des deux côtés — ou davantage — franchissent chaque copie et la résolvent.
Exercice 4.8 ★★
Deux humains diffèrent à raison d’une base sur mille. Combien de différences dans leurs exomes ( de séquence codante) ? Si les deux tiers des différences codantes sont synonymes ou bénignes et que le reste modifie une protéine, combien de variants modifiant une protéine une personne porte-t-elle par rapport à une autre ?
Solution
Solution de Exercice 4.8.
différences codantes ; un tiers, environ , modifient la protéine.
Exercice 4.9 ★★
Une GWAS teste SNP au seuil . Combien de faux positifs attend-on si aucun SNP n’est réellement associé ? Un allèle d’un SNP fait passer le risque d’une maladie de fréquence à . Expliquer pourquoi un tel effet est indétectable dans une étude de mille personnes et inutile pour un individu, et pourquoi il peut néanmoins désigner un mécanisme.
Solution
Solution de Exercice 4.9.
Faux positifs attendus . Un risque relatif de sur une maladie à change quelques cas pour mille ; mille personnes comptent une vingtaine de cas, bien trop peu pour le voir (la puissance croît avec le nombre de cas et le carré de l’effet). Pour un individu, point de pourcentage ne veut rien dire. Mais l’allèle signale un gène dont un changement modeste d’activité modifie le risque de maladie — le gène, et sa voie, peuvent être une cible médicamenteuse dont l’inhibition complète a un grand effet.
Exercice 4.10 ★★★
Les génomes bactériens sont codants à , le génome humain à . Donner trois hypothèses — de génétique des populations, structurale et régulatrice — pour expliquer cette différence, et pour chacune une observation génomique qui l’étaie ou la mine.
Solution
Solution de Exercice 4.10.
Génétique des populations : chez les bactéries, aux populations énormes, la sélection élimine même les insertions un peu coûteuses ; chez les mammifères, aux populations efficaces petites, la dérive laisse s’accumuler un ADN non codant légèrement délétère — étayé par la corrélation inverse entre taille du génome et taille de population selon les lignées, miné par des exceptions. Structurale : les génomes eucaryotes sont envahis par des transposons que les bactéries, avec leur biais vers la délétion et sans refuge méiotique pour les éléments égoïstes, expulsent — étayé par la corrélation entre taille du génome et contenu en transposons. Régulatrice : un développement complexe demande davantage d’ADN régulateur — étayé par les éléments non codants conservés autour des gènes du développement, miné par le fait que seulement du génome humain montre la moindre sélection, de sorte que la plus grande part de l’ADN non codant n’est pas régulatrice.
Exercice 4.11 ★★★
Établir le nombre de contigs de Lander–Waterman pour un mélange de lectures de deux longueurs : lectures courtes de longueur et lectures longues de longueur , les chevauchements étant comptés avec le même minimum . (Traiter chaque lecture comme la plus à droite de son contig si aucune lecture, de l’une ou l’autre sorte, ne commence dans sa propre longueur moins .) Montrer que quelques longues lectures réduisent le nombre de contigs plus qu’un même nombre de bases en lectures courtes.
Solution
Solution de Exercice 4.11.
Les départs des deux sortes tombent avec la densité totale . Une lecture de longueur est la plus à droite de son contig si aucune lecture, de l’une ou l’autre sorte, ne commence dans les bases qui la suivent : probabilité . D’où contigs . Une longue lecture est la plus à droite avec une probabilité exponentiellement plus faible qu’une courte, et chaque longue lecture supprime en outre le risque d’une lacune sur toute sa longueur ; le même nombre de bases en lectures courtes ajoute beaucoup de points de départ mais chaque fenêtre protégée est courte, de sorte que les longues lectures l’emportent.
Exercice 4.12 ★★★
On soutient que les quatre complexes Hox des mammifères descendent d’un seul complexe par deux tours de duplication du génome entier à la base des vertébrés. Dire quelle configuration de paralogues à l’échelle du génome, et quelle configuration dans les génomes des lamproies et des cordés invertébrés, cette hypothèse prédit, et comment on la distinguerait de deux duplications indépendantes du seul complexe.
Solution
Solution de Exercice 4.12.
Deux duplications du génome entier prédisent que le motif quadruple est à l’échelle du génome : des quatuors de segments chromosomiques paralogues (paralogons) portant les mêmes familles de gènes dans le même ordre, les duplications étant datées de la même époque pour toutes les familles ; un complexe unique chez l’amphioxus et chez Ciona, qui ont divergé avant les événements ; et chez les lamproies, qui ont divergé aux alentours, un état intermédiaire ou dérivé de façon indépendante. Des duplications indépendantes du seul complexe Hox prédisent des paralogons pour Hox seulement, des voisins d’histoires différentes, et des dates de duplication qui diffèrent d’une famille à l’autre. Les paralogons à l’échelle du génome et la datation commune, tels qu’on les observe, plaident pour la duplication du génome entier.
4.6 Problème : deux génomes sur une même machine
Problème 4.1
Problème du week-end — une bactérie et un homme séquencés sur la même course : les lectures réparties, la couverture et les lacunes calculées, les contigs dénombrés, les variants hétérozygotes appelés contre le taux d’erreur, le contenu du génome humain pesé et une étude d’association dimensionnée, pour finir sur le nombre de contigs à faible couverture, la couverture qui rend sûr l’appel d’un variant et le nombre de mutations nouvelles chez un enfant
Données : une course livre lectures de . Un génome bactérien fait ; le génome humain (haploïde). Chevauchement minimal . Taux d’erreur par base et par lecture. Séquence codante humaine ; le génome est issu à de transposons, avec million de copies d’Alu de . Deux humains diffèrent sur un site sur . Taux de mutation par base et par génération.
Partie I — La bactérie.
- On donne à la bactérie de la course. Combien de lectures, et quelle couverture ?
- Quelle fraction de son génome n’est pas séquencée ? Combien de bases cela fait-il ?
- Calculer et le nombre espéré de contigs.
- Un essai antérieur n’utilisait que lectures. Couverture, fraction non couverte et nombre de contigs ?
- Le génome contient copies d’un opéron d’ARN ribosomique de . Expliquer ce qu’elles deviennent dans l’assemblage et combien d’extrémités de contigs cela seul produit.
- La bactérie a environ un gène par kilobase. Combien de gènes et, si du génome est codant, quelle est la longueur moyenne d’un gène ?
Partie II — L’homme.
- Le reste de la course va à un seul génome humain. Quelle couverture du génome diploïde par copie haploïde (c’est-à-dire le nombre total de bases divisé par ) ?
- À un site hétérozygote, chacun des deux allèles est couvert par la moitié environ des lectures. Avec la couverture de la question 7, quel est le nombre attendu de lectures montrant chaque allèle ?
- Une erreur fait apparaître une base fausse dans une lecture avec la probabilité . À un site homozygote couvert par lectures, quel est le nombre attendu de lectures montrant une base fausse donnée ( chacune) ? Pourquoi une règle « appeler un variant si au moins lectures et au moins des lectures le montrent » rejette-t-elle les erreurs à cette couverture ?
- Combien de sites hétérozygotes un humain porte-t-il (la moitié environ des différences entre deux génomes pris au hasard se trouvent dans chacun ; prendre un site sur ) ? Et combien en séquence codante ?
- Les lectures sont alignées sur une référence. Expliquer pourquoi les lectures issues d’éléments Alu s’alignent souvent sur la mauvaise copie et quelle conséquence cela a pour l’appel des variants qu’elles contiennent.
- On séquence un enfant avec ses deux parents. Combien de mutations nouvelles attend-on ? Combien de lectures chez l’enfant, à cette couverture, doivent montrer un variant absent de ses deux parents pour qu’on y croie, et pourquoi la couverture des parents importe-t-elle autant que celle de l’enfant ?
- Un laboratoire clinique capture l’exome () et le séquence à . Combien de lectures cela demande-t-il, et pourquoi est-ce moins cher par patient qu’un génome à , alors même que la couverture est plus élevée ?
Partie III — Le contenu d’un génome.
- Quelle fraction du génome humain est de l’Alu, et quelle fraction des lectures de la question 7 vient d’éléments Alu ?
- La référence fait mais une cellule diploïde en contient ; et un oignon de a environ gènes. Quelle est la fraction codante du génome de l’oignon, si ses gènes comptent en moyenne de séquence codante ?
- L’homme et le chimpanzé diffèrent sur des bases alignées. Combien de substitutions cela fait-il sur de séquence alignable ? Réparties également entre les deux lignées sur millions d’années, quel taux de mutation par base et par an cela implique-t-il, et par génération de ans ? Comparer à la mesure directe donnée dans les données.
- Deux duplications du génome des vertébrés devraient donner jusqu’à quatre copies de chaque gène ancestral. L’homme a environ gènes et le cordé invertébré Ciona environ . Quelle fraction des doublons a été perdue, dans l’hypothèse où l’ancêtre en avait ?
- Expliquer pourquoi le nombre de gènes mesure mal la complexité d’un organisme, en prenant pour argument le dénombrement des épissages alternatifs du Chapitre 2.
- du génome est sous sélection purificatrice, mais seulement code une protéine. Que peut bien être le reste, et comment testerait-on un élément candidat ?
Partie IV — Une étude d’association.
- On teste SNP. Énoncer le seuil de Bonferroni pour une erreur par famille de , et le nombre espéré de faux positifs à .
- Une maladie a une prévalence de . Un allèle à risque de fréquence augmente la cote de . Calculer le risque de maladie d’un porteur de deux copies, d’une copie et d’aucune, en prenant pour le risque du non-porteur. (Multiplier les cotes.)
- On trouve deux cents allèles de ce genre. Expliquer ce qu’est un score polygénique, et pourquoi le score d’une personne du centile supérieur peut correspondre à un risque plusieurs fois plus élevé alors que chaque allèle ne fait presque rien.
- Expliquer pourquoi un SNP qui atteint la signification n’est généralement pas le variant causal, et quelle expérience identifierait le variant causal de la région.
- Un génome ancien, tiré d’un os vieux de ans, est séquencé à . Quelle fraction en est lue ? Pourquoi cela peut-il malgré tout répondre à des questions d’histoire des populations auxquelles un génome moderne seul ne répond pas ?
- Résumer : le nombre de contigs de l’assemblage d’essai (question 4), la couverture par génome haploïde qui donne environ lectures par allèle (questions 7–8) et le nombre de mutations nouvelles chez un enfant (question 12).
Solution
Solution de Problème 4.1.
1. lectures ; . 2. : en pratique aucune base non couverte. 3. ; contigs : un seul contig en théorie, des lacunes aux seules répétitions. 4. ; non couvert , soit environ ; contigs . 5. Les sept opérons donnent des lectures identiques et s’effondrent en un seul contig de , où entrent sept flancs gauches uniques et d’où sortent sept flancs droits dont l’appariement est inconnu : extrémités de contigs, sept lacunes. 6. Environ gènes ; codant bp, gène moyen . 7. . 8. Environ lectures par allèle. 9. lecture montrant une base fausse donnée — la chance d’en avoir trois ou plus est d’environ — et de font lectures ; une erreur ne passe ni l’un ni l’autre test, tandis qu’un vrai allèle hétérozygote est attendu dans . 10. sites hétérozygotes ; en séquence codante . 11. Une lecture de issue d’un Alu correspond presque aussi bien à beaucoup des million de copies, de sorte qu’elle est placée sur la mauvaise copie ou reçoit une faible confiance d’alignement. Les différences entre copies ressemblent alors à des variants hétérozygotes, et les vrais variants s’y perdent : les appels de variants à l’intérieur d’un Alu sont d’ordinaire écartés, et ces éléments sont les angles morts du séquençage à lectures courtes. 12. mutations nouvelles. Environ lectures devraient montrer le variant chez l’enfant ; mais si le site d’un parent n’est couvert que par cinq lectures, un allèle hétérozygote est manqué avec la probabilité et un variant hérité est appelé à tort comme nouveau — les parents doivent donc être séquencés aussi profondément que l’enfant. 13. lectures, vingt fois moins que le génome : le coût de séquençage tombe d’un facteur vingt, plus que ne coûte l’étape de capture. 14. bp, environ du génome ; des lectures, soit quelque . 15. bp ; . 16. substitutions, par lignée ; taux par base et par an, par génération de 25 ans — environ le double du taux généalogique de , écart connu qui suggère des générations plus longues dans le passé ou une séparation plus ancienne. 17. Quatre copies de feraient ; subsistent, donc des copies supplémentaires seulement survivent : des doublons ont été perdus. 18. Le ver et l’homme ont le même nombre de gènes ; la complexité tient à l’usage qui en est fait — l’épissage alternatif multiplie un gène en milliers de protéines ( pour Dscam), la régulation combine facteurs de transcription et amplificateurs de façon propre à chaque type cellulaire, les ARN non codants ajoutent des couches, et les protéines interagissent en réseaux. 19. Des éléments régulateurs (amplificateurs, promoteurs, isolateurs), des gènes d’ARN non codants, des signaux d’épissage et de localisation, des origines et des séquences structurales. On teste un amplificateur candidat en le plaçant devant un gène rapporteur dans un embryon transgénique et en regardant où le rapporteur est exprimé, puis en supprimant l’élément du génome par CRISPR et en mesurant les gènes voisins. 20. ; à , faux positifs attendus. 21. Cote du non-porteur ; une copie, cote , risque ; deux copies, cote , risque . 22. Le score somme, sur les allèles, le nombre de copies à risque que porte une personne, pondéré par le logarithme du rapport des cotes de chaque allèle. Ce compte a pour moyenne et pour écart type ; le centile supérieur porte environ allèles de plus que la moyenne, et : près du triple de la cote d’une personne moyenne, à partir d’allèles qui modifient chacun le risque de . 23. Les allèles d’un bloc de quelques dizaines de kilobases sont hérités ensemble (déséquilibre de liaison), de sorte que n’importe lequel montre la même association ; le SNP génotypé n’est que celui qui figure sur la puce. Pour trouver le variant causal : séquencer la région chez les cas et les témoins, réduire l’ensemble par la statistique, puis tester chaque candidat — essais rapporteurs pour l’activité amplificatrice de chaque allèle, édition de chaque allèle dans des cellules et mesure de l’expression des gènes voisins, colocalisation avec des signaux de caractères quantitatifs d’expression. 24. du génome est lu. Cela donne un échantillon direct d’une population à une date connue du passé — les fréquences alléliques avant les migrations et les métissages ultérieurs, la longueur des segments néandertaliens (longs, parce que peu de générations de recombinaison les avaient morcelés) et donc une date pour le métissage — ce que les génomes modernes ne peuvent qu’inférer par des modèles. 25. Environ contigs dans l’essai ; par génome haploïde, soit environ lectures par allèle ; quelque mutations nouvelles chez un enfant.