
সব বই

পেশাদার

1 Markets I: The Ecosystem and Exchange-Traded Marketsবাজার অনলাইনইংরেজি 2 Markets II: Rates, FX and Creditবাজার অনলাইনইংরেজি 3 Markets III: Commodities, Energy and Cryptoবাজার অনলাইনইংরেজি 4 Quantitative Methodsপদ্ধতি অনলাইনইংরেজি 5 Derivatives and Volatilityডেরিভেটিভস অনলাইনইংরেজি 6 Rates, Credit, XVA and Riskসুদহার, ঋণ ও ঝুঁকি অনলাইনইংরেজি 7 Research Craft: Predictors, Backtests, Measurement, Portfoliosগবেষণা অনলাইনইংরেজি 8 Strategies I: Equities and Futuresকৌশল অনলাইনইংরেজি 9 Strategies II: Volatility, Relative Value, Macro and the Bank Desksকৌশল অনলাইনইংরেজি 10 Microstructure and Executionএক্সিকিউশন অনলাইনইংরেজি 11 Market Making and High-Frequency Tradingমার্কেট মেকিং অনলাইনইংরেজি 12 Machine Learning for Marketsমেশিন লার্নিং অনলাইনইংরেজি 13 Low-Latency Softwareপ্রযুক্তি অনলাইনইংরেজি 14 Networks, Hardware and Trading Infrastructureপ্রযুক্তি অনলাইনইংরেজি 15 Research, Data and Risk Platformsপ্রযুক্তি অনলাইনইংরেজি 16 The Desk and the Firmপ্রতিষ্ঠান অনলাইনইংরেজি 17 The Industry: Firms, Roles and Careersক্যারিয়ার অনলাইনইংরেজি 18 Interviews I: Maths, Probability and Speedক্যারিয়ার অনলাইনইংরেজি 19 Interviews II: Markets, Trading Games and the Final Roundক্যারিয়ার অনলাইনইংরেজি 20 Interviews III: Codeক্যারিয়ার অনলাইনইংরেজি
অ্যাপ পরিচিতি Coach সাইন ইন পড়া শুরু করো

বইগুলো এখনো বাংলা ভাষায় পাওয়া যায় না — Bahasa Indonesia সংস্করণ দেখানো হচ্ছে।

Biologi · পরিভাষা

Penjajaran berganda dan profil কী?

Definisi 5.11 Biologi Universitas — Tahun 3 · অধ্যায় 5 — Bioinformatika dan Analisis Urutan

Sebuah penjajaran urutan berganda menata sebuah famili urutan menjadi lajur residu yang homolog. Pemrograman dinamis yang eksak atas kk urutan berbiaya nkn^{k} dan mustahil di atas tiga urutan; program yang praktis menjajarkan secara berangsur, mula-mula pasangan terdekat menurut pohon pemandu, lalu urutan dan kelompok dijajarkan pada penjajaran yang sedang tumbuh, dengan beberapa putaran penghalusan. Penjajaran yang rampung diringkaskan sebagai sebuah profil: bagi tiap lajur, frekuensi tiap residu dan frekuensi celahnya. Sebuah model Markov tersembunyi berprofil memformalkan hal itu sebagai rantai keadaan cocok, satu keadaan tiap lajur yang lestari, yang masing-masing memancarkan residu dengan peluangnya sendiri, dengan keadaan sisip dan keadaan hapus yang membolehkan residu tambahan atau residu yang hilang pada tiap kedudukan; model sebuah famili (sebuah entri Pfam) memberi skor pada urutan baru lewat peluang lintasan terbaiknya melalui keadaannya, dan menemukan homolog jauh di bawah zona remang perbandingan berpasangan, karena sebuah lajur yang hanya mentoleransi residu hidrofob mengatakannya, sedangkan satu urutan tunggal tidak.
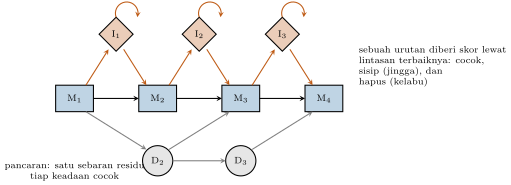
Sebuah model Markov tersembunyi berprofil bagi famili berlajur empat. Tiap keadaan cocok M memancarkan sebuah residu dengan frekuensi lajurnya sendiri; keadaan sisip I (dengan gelung sendiri) membolehkan residu tambahan, keadaan hapus D melewati satu lajur. Memberi skor sebuah urutan berarti mencari lintasannya yang paling mungkin.

উদাহরণ

Contoh 5.7 (Keidentikan, kemiripan, dan zona remang)

Dua urutan protein acak yang dijajarkan secara optimum dengan celah mencapai sekitar 15 sampai 20 %15\text{ sampai }20\,\% keidentikan secara kebetulan. Di atas 35 %35\,\% keidentikan sepanjang seratus residu, dua protein hampir pasti homolog; antara 20 %20\,\% dan 35 %35\,\% terletak zona remang, tempat keidentikan sendirian tak dapat memutuskan dan statistika di bawah harus memutuskannya. Homolog dapat jatuh jauh di bawah zona itu: subunit hemoglobin dan mioglobin berbagi 25 %25\,\% keidentikan, lisozim dan α\alpha-laktalbumin 40 %40\,\%, dan banyak pasangan protein berlipatan sama berbagi kurang dari 15 %15\,\%, yang hanya terdeteksi dengan membandingkan profil atau struktur.

Contoh 5.10 (Membaca sebuah nilai-E)

Sebuah kueri berisi 250250 residu terhadap pangkalan data berisi 5×10105\times 10^{10} residu memiliki mn=1.25×10¹³≈243.5mn = 1.25\times 10^{13} \approx 2^{43.5}. Sebuah kecocokan berskor bit 6060 memiliki E=243.5−60=2−16.5≈10−5E = 2^{43.5 - 60} = 2^{-16.5} \approx 10^{-5}: pada dasarnya pasti homolog. Kecocokan dengan S′=40S' = 40 memiliki E=23.5≈11E = 2^{3.5} \approx 11: sebelas skor semacam itu diharapkan muncul secara kebetulan, dan kecocokannya tak bermakna. Penjajaran yang sama, dengan skor bit yang sama, bila ditelusurkan pada pangkalan data sepuluh kali lebih besar, memiliki EE sepuluh kali lebih besar — kebermaknaan adalah sifat penelusurannya, bukan sifat pasangannya. Ambang yang lazim dipakai adalah E<10−3E < 10^{-3} bagi homolog yang meyakinkan; E≈0.01E \approx 0.01–11 pantas ditengok lagi dengan metode profil.

প্রসঙ্গসহ পড়ো →