
সব বই

পেশাদার

1 Markets I: The Ecosystem and Exchange-Traded Marketsবাজার অনলাইনইংরেজি 2 Markets II: Rates, FX and Creditবাজার অনলাইনইংরেজি 3 Markets III: Commodities, Energy and Cryptoবাজার অনলাইনইংরেজি 4 Quantitative Methodsপদ্ধতি অনলাইনইংরেজি 5 Derivatives and Volatilityডেরিভেটিভস অনলাইনইংরেজি 6 Rates, Credit, XVA and Riskসুদহার, ঋণ ও ঝুঁকি অনলাইনইংরেজি 7 Research Craft: Predictors, Backtests, Measurement, Portfoliosগবেষণা অনলাইনইংরেজি 8 Strategies I: Equities and Futuresকৌশল অনলাইনইংরেজি 9 Strategies II: Volatility, Relative Value, Macro and the Bank Desksকৌশল অনলাইনইংরেজি 10 Microstructure and Executionএক্সিকিউশন অনলাইনইংরেজি 11 Market Making and High-Frequency Tradingমার্কেট মেকিং অনলাইনইংরেজি 12 Machine Learning for Marketsমেশিন লার্নিং অনলাইনইংরেজি 13 Low-Latency Softwareপ্রযুক্তি অনলাইনইংরেজি 14 Networks, Hardware and Trading Infrastructureপ্রযুক্তি অনলাইনইংরেজি 15 Research, Data and Risk Platformsপ্রযুক্তি অনলাইনইংরেজি 16 The Desk and the Firmপ্রতিষ্ঠান অনলাইনইংরেজি 17 The Industry: Firms, Roles and Careersক্যারিয়ার অনলাইনইংরেজি 18 Interviews I: Maths, Probability and Speedক্যারিয়ার অনলাইনইংরেজি 19 Interviews II: Markets, Trading Games and the Final Roundক্যারিয়ার অনলাইনইংরেজি 20 Interviews III: Codeক্যারিয়ার অনলাইনইংরেজি
অ্যাপ পরিচিতি Coach সাইন ইন পড়া শুরু করো

বইগুলো এখনো বাংলা ভাষায় পাওয়া যায় না — Français সংস্করণ দেখানো হচ্ছে।

Biologie · পরিভাষা

Alignement multiple et profils কী?

Définition 5.11 Biologie universitaire — 3e année · অধ্যায় 5 — Bio-informatique et analyse des séquences

Un alignement multiple de séquences range une famille de séquences en colonnes de résidus homologues. La programmation dynamique exacte sur kk séquences coûte nkn^{k} et devient impossible au-delà de trois ; les programmes pratiques alignent de façon progressive : d’abord la paire la plus proche selon un arbre guide, puis les séquences et les groupes s’ajoutent à l’alignement en croissance, avec des tours de raffinement. Un alignement achevé se résume en un profil : pour chaque colonne, la fréquence de chaque résidu et des brèches. Un modèle de Markov caché de profil formalise cela comme une chaîne d’états d’appariement, un par colonne conservée, chacun émettant des résidus avec ses propres probabilités, avec des états d’insertion et de délétion qui autorisent des résidus en trop ou manquants à chaque position ; le modèle d’une famille (une entrée Pfam) score une nouvelle séquence par la probabilité du meilleur chemin dans les états, et trouve des homologues bien en deçà de la zone crépusculaire de la comparaison par paires, parce qu’une colonne qui ne tolère que des résidus hydrophobes le dit, là où une séquence unique ne le peut pas.
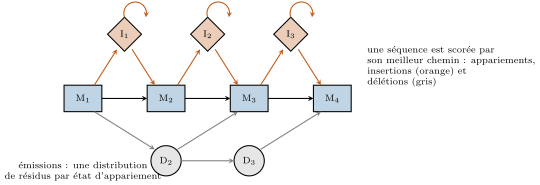
Un modèle de Markov caché de profil pour une famille à quatre colonnes. Chaque état d’appariement M émet un résidu avec les fréquences propres à la colonne ; les états d’insertion I (avec leurs boucles) admettent des résidus supplémentaires, les états de délétion D sautent une colonne. Scorer une séquence, c’est trouver son chemin le plus probable.

উদাহরণ

Exemple 5.7 (Identité, similitude et zone crépusculaire)

Deux séquences protéiques aléatoires alignées de façon optimale avec des brèches atteignent par hasard 15 aˋ 20 %15\text{ à }20\,\% d’identité. Au-dessus de 35 %35\,\% d’identité sur une centaine de résidus, deux protéines sont presque sûrement homologues ; entre 20 %20\,\% et 35 %35\,\% s’étend la zone crépusculaire, où l’identité seule ne peut trancher et où les statistiques ci-dessous doivent le faire. Des homologues peuvent tomber bien en deçà de la zone : les sous-unités de l’hémoglobine et la myoglobine partagent 25 %25\,\% d’identité, le lysozyme et l’α\alpha-lactalbumine 40 %40\,\%, et bien des paires de protéines de même repliement en partagent moins de 15 %15\,\%, détectables seulement en comparant des profils ou des structures.

Exemple 5.10 (Lire une valeur E)

Une requête de 250250 résidus contre une base de 5×10105\times 10^{10} résidus donne mn=1.25×10¹³≈243.5mn = 1.25\times 10^{13} \approx 2^{43.5}. Une correspondance de score 6060 bits a E=243.5−60=2−16.5≈10−5E = 2^{43.5 - 60} = 2^{-16.5} \approx 10^{-5} : c’est presque certainement un homologue. Une correspondance à S′=40S' = 40 a E=23.5≈11E = 2^{3.5} \approx 11 : onze scores de ce niveau sont attendus par hasard, et la correspondance ne veut rien dire. Le même alignement, au même score en bits, cherché dans une base dix fois plus grande, a un EE dix fois plus grand — la signification est une propriété de la recherche, non de la paire. Le seuil d’usage courant est E<10−3E < 10^{-3} pour un homologue sûr ; E≈0.01E \approx 0.01–11 mérite un second examen par une méthode de profil.

প্রসঙ্গসহ পড়ো →