Matemáticas universitarias — Grado 2 · Bachelor Year 2
22Variables aleatorias discretas
Las variables aleatorias organizan los cálculos de probabilidad en torno a funciones y no a sucesos. Sobre espacios numerables, la teoría se apoya en las familias sumables del Capítulo 7: la esperanza es la suma de una familia indexada por el espacio muestral, y todas sus propiedades —linealidad, transferencia, fórmula del producto para variables independientes— son teoremas sobre familias sumables. El capítulo demuestra las desigualdades clave de Markov, Chebyshev, Cauchy–Schwarz y Jensen, y termina con las leyes clásicas y la ley débil de los grandes números, cuya demostración ocupa dos líneas en cuanto se dispone de Chebyshev.
22.1 Variables aleatorias y sus leyes
Definición 22.1 (Variable aleatoria discreta; ley)
Sea un espacio de probabilidad numerable. Una variable aleatoria es una aplicación ( un conjunto cualquiera; variable aleatoria real cuando ). Su ley (o distribución) es la medida de probabilidad sobre el conjunto numerable definida por
Ejemplo 22.2 (Las leyes clásicas)
- Bernoulli : , . La indicatriz de un suceso.
- Binomial : , : el número de éxitos en ensayos de Bernoulli independientes (volumen de secundaria; se vuelve a demostrar más abajo mediante sumas de variables independientes).
- Geométrica : , : el rango del primer éxito (Ejemplo 21.5).
- Poisson : , ; una medida de probabilidad por la serie exponencial. La ley de los sucesos raros (Capítulo 23).
Observación 22.3 (Qué modela cada ley)
Las cuatro leyes responden a cuatro preguntas primitivas: la de Bernoulli, “¿ocurrió?”; la binomial, “¿cuántas veces en intentos?”; la geométrica, “¿cuánto hasta la primera vez?”; y la de Poisson, “¿cuántos sucesos a una tasa dada, cuando los intentos son muchos e individualmente improbables?”. Reconocer la pregunta es nueve décimas partes de la modelización: las sumas de indicatrices apuntan a la binomial, los tiempos de espera a la geométrica y los recuentos de sucesos raros a la de Poisson, con el paso de la binomial a la de Poisson precisado por la ley de los sucesos raros en el Capítulo 23.
Proposición 22.4 (Ausencia de memoria de la ley geométrica)
Si , entonces, para todos :
y las leyes geométricas son las únicas leyes sobre con esta propiedad.
Demostración. Sumando los pesos geométricos, . De ahí,
Recíprocamente, si cumple con , entonces por inducción; con , o bien , o bien la ley es : . ∎
Ejemplo 22.5 (Ningún número está nunca “a punto de salir”)
Lánzase un dado esperando un seis: el tiempo de espera es . La ausencia de memoria dice que, tras tiradas infructuosas, la espera restante , dado , es de nuevo : la espera esperada condicionada sigue siendo de tiradas, exactamente como al principio. El dado no recuerda, y ningún seis está nunca “a punto de salir”; la falacia del jugador es la creencia de que la ley condicionada debería haberse desplazado. Recíprocamente, la mitad de unicidad de la proposición dice que esa indiferencia caracteriza los tiempos de espera geométricos: todo tiempo de espera cuya previsión nunca se actualiza es geométrico. Las colas y los tiempos de vida reales sí suelen actualizarse, que es precisamente cómo se detecta que no son geométricos.
22.2 Esperanza
Definición 22.6 (Esperanza)
Una variable aleatoria real sobre tiene esperanza si la familia es sumable (Capítulo 7); y su esperanza es entonces
Teorema 22.7 (Teorema de transferencia)
tiene esperanza si y solo si la familia es sumable, y entonces
Más en general, para , la variable tiene esperanza si y solo si , y entonces .
Demostración. Pártase en los conjuntos de nivel , . Por el teorema de sumación por paquetes para familias sumables (Capítulo 7), la familia es sumable si y solo si lo es cada paquete (automático: ) y la familia de sumas de paquetes es sumable; y entonces las sumas totales coinciden. Para : aplíquese el enunciado ya demostrado a la variable , cuyos conjuntos de nivel son ; una segunda sumación por paquetes convierte en , agrupando ahora los paquetes los valores según su imagen , con la sumabilidad absoluta de una familia equivalente a la de la otra. ∎
Teorema 22.8 (Propiedades de la esperanza)
Sobre el conjunto de las variables aleatorias con esperanza:
- (Linealidad) .
- (Positividad y monotonía) ; ; y .
- (Dominación) Si y tiene esperanza, entonces también.
Demostración. Todas son propiedades de las sumas de familias sumables (Capítulo 7): la linealidad de la suma, la positividad término a término y el criterio de dominación para la sumabilidad. (Nótese que la linealidad es inmediata sobre la definición como suma sobre , mientras que resultaría incómoda sobre la fórmula de transferencia; una ventaja de definir aguas arriba.) ∎
Ejemplo 22.9
: escribiendo como suma de indicatrices de Bernoulli y usando la linealidad, ; sin necesidad de coeficientes binomiales. : , derivando la serie geométrica dentro de su disco (Capítulo 11). : .
Ejemplo 22.10 (La transferencia en acción)
Para , calculemos ; la ley de es incómoda, pero la transferencia no la pide nunca:
Dos lecciones. En lo computacional: reconocer una serie exponencial desplazada es todo el trabajo; la transferencia reduce las esperanzas de a manipulación de series. En lo estructural: el valor ingenuo de sustituir sería , y la respuesta verdadera es mayor,
exactamente como exige la desigualdad de Jensen para la función convexa . Las esperanzas de imágenes convexas quedan por encima del valor ingenuo de sustituir, y la transferencia más una comprobación con series hace concreta la desigualdad abstracta.
Teorema 22.11 (Independencia y productos)
Dos variables aleatorias son independientes si para todos ; equivalentemente, si los sucesos y son independientes para todos . Si e son variables reales independientes con esperanza, entonces tiene esperanza y
Demostración. La equivalencia de las dos formulaciones se sigue sumando la identidad puntual sobre (-aditividad dos veces). Para el producto: la familia doble es sumable, pues por Fubini para familias (Capítulo 7)
y por la independencia, esta familia es exactamente , cuya suma es por transferencia aplicada a la variable ; Fubini evalúa de nuevo la suma sin signos como el producto . ∎
Ejemplo 22.12 (Productos, con y sin independencia)
Lánzense dos dados equilibrados. Si es el segundo dado (independiente del primero), . Si, en cambio, (el “producto” de un dado consigo mismo),
las mismas leyes marginales en ambos escenarios, leyes conjuntas distintas y esperanzas del producto distintas. La moraleja, digna de grabarse: es un funcional del par, no de las dos marginales; y la diferencia es, por König–Huygens, precisamente la varianza del dado.
22.3 Varianza, covarianza y las desigualdades clásicas
Definición 22.13 (Momentos, varianza)
tiene momento de orden 2 si tiene esperanza (entonces también, por dominación: ). Su varianza y su desviación típica son entonces
(la segunda forma —la fórmula de König–Huygens— desarrollando el cuadrado y usando la linealidad:
donde el término central usa que es una constante). Para con momentos de orden dos, la covarianza es
Teorema 22.14 (Caja de herramientas de la varianza)
Para variables con momentos de orden dos:
- ;
y, más en general,
- si son independientes, (el recíproco es falso), de modo que las varianzas de variables independientes se suman.
Demostración. 1 y 2 son desarrollos de cuadrados más linealidad; los productos tienen esperanza por Cauchy–Schwarz más abajo (o por ). 3 es el Teorema 22.11 aplicado a las variables centradas. Un contraejemplo estándar del recíproco: uniforme sobre e están incorreladas (), pero son claramente dependientes. ∎
Teorema 22.15 (Desigualdades de Markov y de Chebyshev)
(Markov) Si tiene esperanza, entonces, para todo :
(Chebyshev) Si tiene momento de orden dos, entonces, para todo :
Demostración. 1. Punto a punto, (sobre el suceso, el miembro izquierdo es ; fuera de él, ). Tómense esperanzas: por monotonía y . 2. Aplíquese Markov a la variable no negativa al nivel : el suceso es exactamente . ∎
Ejemplo 22.16 (Incorreladas pero pegadas la una a la otra)
Lánzense dos dados equilibrados, e independientes, y póngase , . Por la bilinealidad de la covarianza,
la suma y la diferencia están incorreladas. ¿Independientes? Desde luego que no: fuerza , mientras que incondicionalmente. La correlación solo pone a prueba la parte lineal de una dependencia; aquí, la dependencia la lleva la restricción de que y tengan la misma paridad, invisible para la covarianza. (Para este par, la covarianza nula necesitaba : fueron las distribuciones idénticas, y no la independencia, las que hicieron el trabajo.)
Ejemplo 22.17 (Cuándo es exacta la de Markov)
La desigualdad de Markov es una igualdad precisamente cuando no se desperdicia nada en la cota : la variable ha de tomar solo los valores y . En concreto, si y , entonces y
Una lectura realista: en una población cuya riqueza media es y donde la riqueza es o , la proporción de millonarios es exactamente ; la cota de Markov, alcanzada exactamente por una desigualdad maximal. Siempre que se reparta por valores intermedios, la cota es estricta, a menudo desaforadamente; pero, como muestra el caso extremo, de la sola media no puede extraerse ninguna desigualdad mejor.
Ejemplo 22.18 (Chebyshev es óptima, sin hipótesis adicionales)
Fíjense y , y sea la variable que toma los valores con probabilidad cada uno y con probabilidad . Entonces , , y
igualdad en Chebyshev. Así pues, la desigualdad no puede mejorarse usando solo la varianza; el decaimiento es el precio exacto de la información de segundo momento. Un decaimiento más rápido exige hipótesis más fuertes: la acotación de la variable compra concentración exponencial, como anticipa el Ejercicio 22.7 y desarrolla sistemáticamente el problema de fin de semana de este capítulo.
Teorema 22.19 (Cauchy–Schwarz y Jensen)
Demostración. 1. Sumabilidad de : . La aplicación es una forma bilineal simétrica positiva sobre el espacio de las variables con momento de orden dos, así que se aplica la desigualdad de Cauchy–Schwarz abstracta del Capítulo 12 (para la desigualdad basta con que sea semidefinida positiva). Aplicándola a las variables centradas se obtiene la cota de la covarianza.
2. Primero, está en : es un intervalo que contiene todos los valores de , y la esperanza es monótona, de modo que está entre y . Por el teorema de la recta de apoyo para funciones convexas (Capítulo 8), hay con para todo y . Entonces, punto a punto sobre , ; tomando esperanzas,
∎
Ejemplo 22.20
Jensen con da : la positividad de la varianza; y con sobre : ; la media armónica está por debajo de la aritmética, ahora en forma aleatoria.
Observación 22.21 (Errores frecuentes)
(i) exige independencia (o, al menos, covarianza nula): tomando resulta siempre que . (ii) Igualmente, , y no : las varianzas solo se suman entre sumandos independientes (o incorrelados). (iii) no es ; para convexa, Jensen dice incluso en qué dirección va el error, como en el Ejemplo 22.10. (iv) La existencia es una hipótesis real: para la variable de San Petersburgo con (),
es finita casi seguramente y, sin embargo, no tiene esperanza, y no existe ningún precio de entrada justo para el juego. La sumabilidad en la definición de no es pedantería contable: es donde se detectan las colas pesadas. (v) Por último, el teorema de transferencia necesita la sumabilidad absoluta antes de que sea legítimo reordenar la suma sobre los valores (Capítulo 7).
Ejemplo 22.22 (Chebyshev sobre cien lanzamientos)
Para : y . Chebyshev con :
mientras que la suma binomial exacta da . El garantizado queda lejos de la verdad, pero solo necesitó la media y la varianza; el mismo certificado se aplica palabra por palabra a cualquier variable con y , por exótica que sea, y el Ejemplo 22.18 muestra que alguna variable así lo satura. La universalidad tiene un precio; cuando la distribución es genuinamente binomial, las herramientas exponenciales del problema de fin de semana cierran casi toda la brecha.
Ejemplo 22.23 (La correlación de una parte con su todo)
Para independientes e idénticamente distribuidas con varianza , ¿cuán correlacionado está un sumando con la suma ? Calculemos
de modo que el coeficiente de correlación es
sea cual sea la ley común: dados, monedas, recuentos de Poisson. Con sumandos, el mismo cálculo da : la influencia de cada término individual sobre el total se diluye como una raíz cuadrada, que es la sombra correlacional de la escala de las fluctuaciones. Cauchy–Schwarz garantiza siempre; aquí la cota se alcanza exactamente en el caso degenerado y decae de manera previsible después.
Ejemplo 22.24 (La desigualdad de las medias ponderada, desde Jensen)
Sea la variable que toma los valores positivos con probabilidades . La función es convexa sobre , de modo que Jensen da , es decir,
la desigualdad aritmético-geométrica ponderada, con igualdad si y solo si es constante. Con pesos iguales se recupera la desigualdad de las medias clásica. La probabilidad ha demostrado calladamente un teorema puramente algebraico: elegir una ley de probabilidad no es más que un instrumento contable para combinaciones convexas; el punto de vista baricéntrico del Capítulo 17 una vez más, ahora con Jensen de motor.
22.4 La ley débil de los grandes números
Teorema 22.25 (Ley débil de los grandes números)
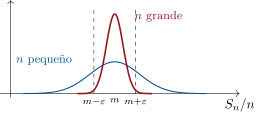
Sean variables aleatorias independientes dos a dos con la misma ley y con momento de orden dos; escríbanse y . Entonces, para todo :
Demostración. Por linealidad, ; por el Teorema 22.14 (la independencia dos a dos mata las covarianzas), , de modo que . La desigualdad de Chebyshev aplicada a da la cota. ∎
Observación 22.26
Este es el teorema que conecta la probabilidad con la frecuencia: para la indicatriz de un suceso en repeticiones independientes, es la frecuencia observada de , y la ley de los grandes números dice que se concentra en torno a a un ritmo . La ley fuerte ( casi seguramente) es un teorema del tercer año; su demostración con momentos de orden cuatro sí está al alcance, no obstante: véase el Ejercicio 22.9, que ejecuta Borel–Cantelli sobre la cota de tipo Chebyshev. La misma estimación de Chebyshev impulsó la demostración con polinomios de Bernstein del teorema de aproximación de Weierstrass del Capítulo 10: el lema de conteo de allí era la ley débil de los grandes números disfrazada.
Ejemplo 22.27 (Coleccionar cincuenta cromos)
El coleccionista de cromos del Ejercicio 22.3 con juguetes distintos: el total esperado es
cajas; cuatro veces y media la conjetura ingenua . El crecimiento armónico es toda la historia: los primeros juguetes llegan en unas cajas, mientras que el último juguete cuesta él solo cajas de media (una espera geométrica de parámetro ). Los problemas de compleción están dominados por su final de partida, y por eso el Ejercicio 22.12 encuentra fluctuaciones de orden —el tamaño de esa última espera geométrica— en torno a la media .
Ejemplo 22.28 (¿Cuán grande ha de ser ?)
Para fijar la frecuencia observada a menos de de con una confianza del , la cota de Chebyshev exige
La dependencia es brutal en (cuadrática) y suave en la confianza (lineal en ). Ambos rasgos son propiedades de la cota, no de la verdad: las desigualdades exponenciales del problema de fin de semana rebajan el precio de la confianza de a —la misma especificación costará allí unas muestras—, mientras que la escala es genuina e inmejorable. Saber qué parte de una cota está floja es tan útil como la cota misma.
Observación 22.29 (Perspectivas dentro de este volumen)
Hacia delante, todo lo de aquí alimenta el Capítulo 23: la esperanza de una astuta función de empaqueta toda la ley en una serie de potencias, los momentos se convierten en derivadas en , y las identidades de tipo Wald para sumas aleatorias sostienen la teoría de los procesos de ramificación; el teorema del producto para variables independientes se convierte en la multiplicatividad de las funciones generatrices. Hacia atrás, la esperanza es un baricentro con pesos de probabilidad (Capítulo 17), la desigualdad de Jensen es la geometría de las rectas de apoyo de las funciones convexas (Capítulo 8), y el método de los momentos exponenciales del problema de fin de semana de este capítulo es Markov aplicado a : una desigualdad, mejorada por un buen cambio de variable, abarcando tres capítulos.
22.5 Ejercicios
Ejercicio 22.1 ★
Calcula y para (mediante indicatrices), para (prueba que ) y para (prueba que ; usa y la derivada segunda de la serie geométrica).
Solución
Solución de Ejercicio 22.1.
Binomial: con de Bernoulli independientes; , y las varianzas de variables independientes se suman (Teorema 22.14):
Poisson: , luego
Geométrica (): derivando dos veces dentro del disco (Capítulo 11), , de modo que
Ejercicio 22.2 ★
Sean e independientes. Prueba que (convolución de los pesos; teorema del binomio), y que la ley condicionada de dado es la binomial .
Solución
Solución de Ejercicio 22.2.
Suma: para , por disjunción e independencia,
por el teorema del binomio: . Ley condicionada: para ,
la ley binomial : dado el recuento total, cada suceso “elige” de manera independiente la primera fuente con probabilidad proporcional a su tasa.
Ejercicio 22.3 ★
(Coleccionista de cromos, esperanza) Una marca de cereales esconde uno de juguetes distintos, uniformemente, en cada caja. Sea el número de cajas necesarias para reunir los juguetes. Escribiendo como suma de variables geométricas independientes (el tiempo hasta ver un juguete nuevo cuando aún faltan ), prueba que
(equivalente por la comparación serie-integral del Capítulo 6).
Solución
Solución de Ejercicio 22.3.
Cuando aún faltan juguetes, cada caja nueva trae uno nuevo con probabilidad , independientemente del pasado: el tiempo de espera hasta el siguiente juguete nuevo es geométrico , con , y (la primera caja siempre da un juguete nuevo: , coherente con ). Por linealidad,
usando (Capítulo 6). Lo caro es reunir los últimos juguetes: la mitad de las cajas se va en el puñado final.
Ejercicio 22.4 ★★
Sea con valores enteros. Demuestra la fórmula de la cola
(cuando alguno de los dos miembros es finito), escribiendo e intercambiando las sumaciones (Fubini para familias no negativas). Recupera para la ley geométrica.
Solución
Solución de Ejercicio 22.4.
Punto a punto, . La familia doble es no negativa, así que Fubini para familias (Capítulo 7) se aplica incondicionalmente: sumando primero en se obtiene , y sumando primero en , ; ambas son simultáneamente finitas e iguales. Para : (), luego .
Ejercicio 22.5 ★★
(El muestreo sin reemplazamiento está más concentrado) Una urna contiene bolas, de ellas blancas. Extráiganse sin reemplazamiento y sea el número de blancas (ley hipergeométrica). Usando indicatrices con la -ésima extracción: prueba que cada es de Bernoulli de parámetro (¡simetría!), concluye que exactamente igual que con reemplazamiento, y prueba que para , de donde .
Solución
Solución de Ejercicio 22.5.
Simetría: la -ésima bola extraída es una bola de la urna elegida uniformemente al azar (cualquiera de las bolas tiene la misma probabilidad de caer en la posición del orden de extracción), de modo que y por linealidad; sin necesitar independencia.
Covarianza: para , (a pares ordenados de posiciones distintas les corresponde un par ordenado de bolas distintas, uniformemente). De ahí,
extraer una bola blanca hace las blancas más escasas para las demás extracciones. Por el Teorema 22.14,
el muestreo sin reemplazamiento tiene la misma media pero menor varianza que con reemplazamiento (con igualdad solo para ), actuando las correlaciones negativas como estabilizador. Para la varianza se anula: el recuento es entonces determinista.
Ejercicio 22.6 ★★
Sea con momento de orden dos. Prueba que es mínima exactamente en , con mínimo . Prueba después que si y solo si . (Para el segundo punto: si , usa Chebyshev con y la continuidad monótona, Teorema 21.6.)
Solución
Solución de Ejercicio 22.6.
Desarrollando en torno a :
mínima exactamente en y con valor ; la esperanza es el mejor predictor constante en media cuadrática.
Si , entonces se anula con probabilidad , luego (la familia que la define tiene términos nulos salvo sobre un conjunto nulo). Recíprocamente, si , Chebyshev (Teorema 22.15) da para todo ; los sucesos crecen hacia , de modo que la continuidad monótona (Teorema 21.6) da .
Ejercicio 22.7 ★★★
(La concentración gana a Markov) Sea (número de caras en lanzamientos equilibrados). Compara las cotas que dan Markov (para ), Chebyshev y el método exponencial (de Chernoff):
y optimiza en para obtener una cota exponencialmente pequeña. (En : cota .)
Solución
Solución de Ejercicio 22.7.
y . Markov: : una cota constante, inútil para grande. Chebyshev: el suceso implica , luego la probabilidad es : decae, pero solo polinómicamente. Chernoff: por independencia, , y Markov aplicado a da, para todo ,
Minimícese el exponente: en , es decir, , lo que da
exponencialmente pequeño. La jerarquía Markov Chebyshev Chernoff es la escalera estándar: cada peldaño aplica Markov a una función de la variable que crece más deprisa.
Ejercicio 22.8 ★★★
(Weierstrass otra vez, probabilísticamente) Sean continua y . Prueba que el polinomio de Bernstein vale , y vuelve a deducir la estimación del Capítulo 10 en este lenguaje probabilista (pártase según y úsese Chebyshev).
Solución
Solución de Ejercicio 22.8.
Por el teorema de transferencia (Teorema 22.7) aplicado a con :
Fíjese y pártase según el suceso : fuera de , la diferencia es a lo sumo el módulo de continuidad ; y sobre , a lo sumo . Tomando esperanzas y usando Chebyshev con :
La continuidad uniforme de sobre hace : elíjase y después , y uniformemente; el teorema de aproximación de Weierstrass del Capítulo 10, cuyo “lema de conteo” es ahora reconocible como la desigualdad de Chebyshev para la ley binomial.
Ejercicio 22.9 ★★★
(Ley fuerte con momentos de orden cuatro) Sean independientes, idénticamente distribuidas y centradas (), con . Desarrollando y contando los términos que sobreviven (solo los de y , con ), prueba que para una constante . Deduce que para cada (Markov de orden 4) y concluye con Borel–Cantelli (Teorema 21.25) que casi seguramente, en la formulación adecuada: el suceso tiene probabilidad .
Solución
Solución de Ejercicio 22.9.
Desarróllese y tómense esperanzas. Por la independencia y el centrado, todo término que contenga un índice que aparezca exactamente una vez se anula ( sale factor). Términos supervivientes: los diagonales y los que emparejan dos parejas de índices iguales, para , que aparecen veces: elíjase la pareja no ordenada de valores ( maneras) y después las maneras de colocarlos en las cuatro ranuras: . Por tanto, con (Jensen o Cauchy–Schwarz),
Markov de orden 4:
una serie sumable. Por Borel–Cantelli 1 (Teorema 21.25), para cada el suceso tiene probabilidad , luego por subaditividad numerable. Sobre el complementario —de probabilidad — para todo hay un con para todo : precisamente . La ley fuerte de los grandes números vale con momento de orden cuatro; suprimir esa hipótesis (el teorema de Kolmogórov) es tarea del tercer año.
Ejercicio 22.10 ★
Se lanzan dos dados equilibrados; sea el mayor de los dos resultados. Usando la fórmula de la cola del Ejercicio 22.4 (versión finita), prueba que
Solución
Solución de Ejercicio 22.10.
(ambos dados a lo sumo , independientemente), de modo que y
holgadamente por encima de la media de un solo dado, como debe ser en un máximo.
Ejercicio 22.11 ★★
Sea el número de puntos fijos de una permutación uniformemente aleatoria de (). Escribiendo , calcula , para , y concluye que : de media queda una letra fija, con varianza exactamente , sea cual sea .
Solución
Solución de Ejercicio 22.11.
Con : , luego . Para : , de donde
Por la caja de herramientas de la varianza (Teorema 22.14),
Media , varianza , independientes de ; coherente con el límite de Poisson del problema de los emparejamientos (Ejercicio 21.5).
Ejercicio 22.12 ★★★
(Coleccionista de cromos, concentración) En el marco del Ejercicio 22.3, prueba que
usando la independencia de las etapas geométricas y (Ejercicio 22.1; el valor es el Ejemplo 14.12). Deduce con Chebyshev que en probabilidad: el tiempo total del coleccionista es salvo fluctuaciones de orden .
Solución
Solución de Ejercicio 22.12.
, donde es el tiempo hasta ver un juguete nuevo cuando faltan , siendo las etapas independientes. De ahí,
por el Ejemplo 14.12. Con y (Ejercicio 22.3), Chebyshev da, para ,
Como , dividiendo entre se ve que en probabilidad: las fluctuaciones de son de orden , despreciables frente a la media .
22.6 Problema: la caja de herramientas de la concentración, de Markov a Hoeffding
Problema 22.1
Problema de fin de semana — concentración exponencial a mano, y a cuánta gente ha de preguntar una encuesta
La desigualdad de Markov cuesta un momento y compra un decaimiento ; Chebyshev cuesta dos momentos y compra ; y el Ejemplo 22.18 muestra que eso es todo lo que esos momentos pueden comprar. Este problema sube el resto de la escalera: el método exponencial (de Chernoff) con su ritmo exacto para lanzamientos de moneda, la desigualdad de Hoeffding para todas las variables acotadas, y la recompensa: tamaños de muestra explícitos y honestos para encuestas, adjudicaciones electorales y contraste de monedas. En todo el problema, es una suma de variables de Bernoulli independientes y la frecuencia empírica.
Parte I — Calibración sobre la moneda equilibrada. Aquí y .
- Markov al nivel : prueba que , una cota que ni siquiera tiende a . ¿Dónde pierde tanto Markov?
Chebyshev: usando la simetría de la binomial equilibrada respecto de , prueba que
es decir, en : por fin, decaimiento polinómico.
(Chernoff, nivel general) Calcula y optimiza en : prueba que el óptimo es y que
Comprueba que recupera la cota del Ejercicio 22.7.
(El exponente es exacto) Sea un entero. A partir de que es el mayor de los términos de una distribución de probabilidad, demuestra que con , y deduce la cota inferior correspondiente
- Tabula las tres cotas en , : Markov , Chebyshev , Chernoff (el valor verdadero es ). ¿La moraleja, en una frase?
Parte II — La desigualdad de Hoeffding.
(Caso de Rademacher) Para con probabilidad cada uno, demuestra que
comparando las dos series término a término ().
Deduce, para variables de Rademacher independientes y todo :
- Tradúcelo a monedas equilibradas (): , y la versión bilateral con un factor .
(Lema de Hoeffding) Sea con , y . Justifica que es dos veces diferenciable con
una varianza de una variable reponderada que sigue tomando valores en ; acótala por (el argumento de minimalidad del Ejercicio 22.6) y concluye por Taylor:
(Desigualdad de Hoeffding) Para independientes con media común , deduce que
- Compara el ritmo de Chebyshev con el de Hoeffding: ¿qué hipótesis exige cada uno, y a partir de qué (aproximadamente) gana la cota exponencial en , ?
Parte III — ¿A cuánta gente ha de preguntar una encuesta? Una encuesta pregunta a votantes elegidos uniformemente y de manera independiente; cada uno responde con sinceridad; es el resultado verdadero y la cifra de la encuesta.
Prueba que la encuesta es precisa hasta con confianza (es decir, ) en cuanto
- Calcula el necesario para la especificación estándar de “tres puntos, noventa y cinco por ciento” (, ): ; y para un punto: . Obsérvese —y explíquese— el hecho llamativo de que la respuesta no involucra el tamaño de la población.
- Rehaz la pregunta 13 con Chebyshev (): con tres puntos. Nótese que muestrear sin reemplazamiento solo ayuda (Ejercicio 22.5: la varianza se encoge en ).
- (Adjudicar una elección) El resultado verdadero de un candidato es . ¿A cuántos votantes hay que encuestar para que ? Prueba que : adjudicar una carrera reñida cuesta mucho más que estimar un resultado.
- Lo que la matemática no cubre: enumera las hipótesis de modelización usadas (muestreo uniforme independiente, respuestas sinceras, fijo) y explica en un párrafo breve por qué los errores reales de las encuestas están dominados por el sesgo (muestreo no uniforme, falta de respuesta), que ningún aumento de reduce.
Parte IV — Más afiladas y más baratas.
(Mediana de medias: decaimiento exponencial a partir de dos momentos) Repártase un presupuesto de muestras en grupos independientes de ; sean las medias de los grupos y su mediana. Elíjase de modo que cada grupo cumpla (Chebyshev: basta ). Prueba que si , entonces al menos grupos yerran, y deduce que
concentración exponencial usando nada más allá de las varianzas.
- (Paley–Zygmund) Para con momento de orden dos, demuestra que (Cauchy–Schwarz sobre ): la herramienta en sentido inverso; los momentos también pueden forzar a los sucesos a ocurrir.
- (Pinsker en versión ligera) Prueba que sobre (la diferencia se anula hasta el segundo orden en y su derivada segunda es ): el exponente exacto de Chernoff siempre gana al cuadrático de Hoeffding.
- Desarrolla y combínalo con la pregunta 4: para desviaciones pequeñas, el exponente de Hoeffding es asintóticamente exacto; ningún método puede mejorarlo en más que factores polinómicos.
- Redacta la tabla de la caja de herramientas: para Markov, Chebyshev, la cota de cuarto momento del Ejercicio 22.9, Hoeffding y Chernoff con exponente , indica en una línea cada uno: hipótesis requerida, decaimiento obtenido y la pregunta de este problema donde resultó más afilado.
Parte V — Dividendos.
- (Contrastar una moneda) Una moneda es equilibrada o está sesgada con . Se lanza veces y se declara “sesgada” cuando . Prueba que ambas probabilidades de error son a lo sumo , y que lanzamientos garantizan que ambas queden por debajo del .
- (Los sucesos raros necesitan una cota consciente de la varianza) Sea y tómese la especificación relativa , . Compara los tamaños de muestra que exigen Hoeffding () y Chebyshev con la varianza verdadera (): la cota exponencial, ciega a la varianza, pierde frente al humilde momento de orden dos. Enuncia la moraleja y di de dónde vendrá la herramienta que falta (una cota exponencial consciente de la varianza; la aproximación de Poisson del Capítulo 23).
- (Ley fuerte para monedas) A partir de y de Borel–Cantelli (Teorema 21.25), demuestra que casi seguramente para lanzamientos de moneda independientes: formula el suceso casi seguro como , como en el Ejercicio 22.9, y concluye. (La acotación sustituye al cuarto momento usado allí.)
- Síntesis. En cinco frases: qué cuesta y qué compra cada peldaño de la escalera (momentos uno, dos y cuatro; exponencial acotada; exponente exacto); por qué encuestar a personas basta para un país de cualquier tamaño; y cuál de estas cotas afilará el volumen del tercer año hasta las constantes exactas del teorema central del límite.
Solución
Solución de Problema 22.1.
1. y Markov (Teorema 22.15) dan . Markov solo conoce la media: no puede distinguir una variable concentrada en de otra repartida entre y , así que tarifa la cola como si toda la masa pudiera estar allí.
2. La binomial equilibrada es simétrica respecto de ( y tienen la misma ley), de modo que, con , los dos sucesos y son disjuntos y equiprobables: . Chebyshev con :
que vale en .
3. Por la independencia y el teorema del producto, . Markov aplicado a :
La derivada del exponente en es , que se anula en , es decir, ; allí, y el exponente vale
con e sobre : . En : , la cota del Ejercicio 22.7.
4. Los números suman , y el mayor es el de (la moda de es aquí). Un máximo de números que suman es al menos :
De ahí, : salvo el factor polinómico , el exponente de Chernoff es la verdad.
5. , : Markov ; Chebyshev ; Chernoff , frente al valor exacto . Moraleja: cada momento de información divide la cota polinómicamente; el momento exponencial cambia su naturaleza.
6. y ; la afirmación se sigue término a término de , que vale por inducción: .
7. Por la independencia, , de modo que Markov da ; minimizando en resulta .
8. Con , , luego y la pregunta 7 da la cota . El suceso simétrico tiene la misma cota, de donde el factor para .
9. es una serie de funciones regulares de cuyas derivadas término a término están dominadas, sobre todo intervalo compacto de , por (pues ): por el teorema de derivación para series normalmente convergentes (Teorema 10.7) es dos veces diferenciable, y la regla del cociente da y , donde es la esperanza para los pesos reponderados : no negativos, de suma y llevados por los mismos valores . Una varianza de una variable con valores en es a lo sumo : por el Ejercicio 22.6, vale . Taylor con resto integral, usando y :
es decir, para todo real.
10. Por la independencia, ; Markov y la optimización dan
y aplicar esto a las variables (también en ) acota la otra cola, de donde el bilateral.
11. Chebyshev solo necesita un momento de orden dos y da ; Hoeffding necesita la acotación y da . En , : las cotas son (aproximadamente) frente a ; se cruzan cerca de , a partir de donde gana la cota exponencial, y con creces (: frente a ).
12. Por Hoeffding (pregunta 10), en cuanto , es decir, .
13. , : : personas. Para : . El tamaño de la población no aparece nunca porque cada votante muestreado se modela como una extracción de Bernoulli nueva: la dificultad de la encuesta es la varianza de una moneda, no el tamaño del país. Reducir a la mitad el margen cuesta cuatro veces la muestra: la ley .
14. Chebyshev: para , es decir, con tres puntos: unas veces lo que exige Hoeffding. Sin reemplazamiento, la varianza queda multiplicada por (Ejercicio 22.5), de modo que el mismo solo puede hacerlo mejor: el cálculo con reemplazamiento es el conservador.
15. , así que, por la cota unilateral de Hoeffding, en cuanto : votantes. El coste escala como el inverso del cuadrado de la ventaja, no de la precisión deseada: las carreras reñidas son caras.
16. Se usó: que la muestra se extrae uniformemente y de manera independiente del electorado; que toda persona muestreada responde, y con sinceridad; y que no se mueve durante el trabajo de campo. Las encuestas reales violan las tres: las personas localizables y dispuestas no son una muestra uniforme (sesgo de selección y de no respuesta), y las respuestas pueden ser insinceras o inestables. Son errores de sesgo: desplazan respecto de en una cantidad independiente de , de modo que ningún tamaño de muestra los reduce; la matemática de esta parte controla únicamente el término de fluctuación.
17. Chebyshev para un grupo de tamaño : para . Si yerran menos de grupos, entonces más de de los valores están en el intervalo abierto , y su mediana también; de modo que fuerza al menos errores entre grupos independientes. La cota de la unión sobre los conjuntos posibles de grupos que yerran da
decaimiento exponencial en el número de grupos, comprado con nada más que varianzas; útil precisamente cuando los sumandos no están acotados y Hoeffding no está disponible.
18. Cauchy–Schwarz (Teorema 22.19):
elévese al cuadrado y divídase.
19. Sea . Entonces , se anula en , y
puesto que . Así pues, crece desde sobre , luego y : .
20. y dan , y (la función es simétrica respecto de ), de modo que . La pregunta 4 acota entonces la cola verdadera por debajo mediante : para pequeño, el exponente de Hoeffding es asintóticamente exacto; solo son posibles mejoras polinómicas en .
21. Markov: un momento, decaimiento , útil solo como motor de los demás (la pregunta 1 lo muestra plano). Chebyshev: dos momentos, decaimiento , óptimo sin hipótesis adicionales (Ejemplo 22.18), y la mejor herramienta en la pregunta 23. Cuarto momento (Ejercicio 22.9): decaimiento , justo la sumabilidad necesaria para una ley fuerte. Hoeffding: variables acotadas, decaimiento , el caballo de batalla de la parte III. Chernoff con el ritmo exacto : momentos exponenciales completos, exponente insuperable (preguntas 4 y 20), el punto de referencia de todo lo demás.
22. Si la moneda es equilibrada: . Si : . Ambos errores quedan por debajo de cuando , es decir, : lanzamientos. (Distinguir hipótesis separadas puntos cuesta lo mismo que estimar con puntos.)
23. Hoeffding: . Chebyshev con la varianza verdadera : : nueve veces más barato. El exponente de Hoeffding tarifa la varianza en su peor caso , absurdamente pesimista cuando ; el humilde momento de orden dos sabe más. La herramienta que falta es una cota exponencial consciente de la varianza (la desigualdad de Bernstein, tercer año) o, para sucesos raros, la aproximación de Poisson demostrada en el Capítulo 23, que trabaja en la escala relativa natural.
24. Fíjese : (una serie de tipo geométrico), de modo que Borel–Cantelli 1 (Teorema 21.25) da ; es decir, el suceso tiene probabilidad para cada . La intersección numerable sigue teniendo probabilidad (subaditividad sobre los complementarios), y sobre ella : la ley fuerte de los grandes números para lanzamientos de moneda, con la acotación desempeñando el papel que allí desempeñaba el cuarto momento (Ejercicio 22.9).
25. Un momento compra una cota plana; dos compran , y no más (el ejemplo de optimalidad); cuatro compran , suficiente para telescopar en una ley casi segura; la acotación compra ; y el momento exponencial completo compra el ritmo exacto , que ningún método supera. Encuestar a personas basta para cualquier país porque la fluctuación de la muestra la gobierna la varianza de la moneda, no el tamaño de la población; las etiquetas de precio y son universales. El teorema central del límite del volumen del tercer año sustituye estas desigualdades, en la escala , por una ley límite exacta con constantes explícitas, convirtiendo toda cota de este problema en una igualdad asintótica.