Biología universitaria — tercer año · Bachelor Year 3
25Evolución molecular y filogenómica
En 1968 Motoo Kimura hizo una cuenta que inquietó a todo un campo. Al comparar las hemoglobinas, los citocromos y otras proteínas de mamíferos cuyos antepasados comunes databan los fósiles, halló que los aminoácidos se habían sustituido a un ritmo de aproximadamente una sustitución por sitio y por mil millones de años —lo que, a lo largo de un genoma de mamífero y de una generación, daba una sustitución nueva fijada en la población cada dos años más o menos. Haldane había demostrado una década antes que la selección natural puede fijar a lo sumo una sustitución cada trescientas generaciones antes de que el coste en descendencia perdida se vuelva impagable. La aritmética dejaba una sola salida: la mayoría de los cambios que se acumulan en el ADN no los impulsa la selección en absoluto, sino que son neutros y los fija el azar en poblaciones finitas, a un ritmo que —como muestra el primer teorema de este capítulo— es sencillamente el ritmo de mutación. La teoría neutralista se convirtió en la hipótesis nula de la evolución molecular, la línea de base frente a la cual se detecta la selección; el reloj molecular se convirtió en una manera de datar lo que los fósiles no podían; y los genomas secuenciados desde entonces han dado las herramientas para ver, gen a gen, dónde ha actuado la selección, cómo nacen genes nuevos de los viejos y por qué el árbol de un gen no siempre es el árbol de su especie.
25.1 Deriva, mutación y el ritmo neutro
Teorema 25.1 (El ritmo neutro de sustitución)
En una población diploide de individuos, una mutación nueva sin efecto sobre la eficacia biológica tiene una probabilidad de acabar reemplazando a todos los demás alelos (fijación) y de perderse. Si cada una de las copias del gen muta a un ritmo por generación, surgen mutaciones neutras nuevas por generación y, a la larga, el ritmo al que se acumulan las sustituciones es
el ritmo de sustitución neutro es igual al ritmo de mutación, con independencia del tamaño de la población. Una mutación destinada a fijarse tarda en promedio generaciones en conseguirlo, de modo que las poblaciones grandes albergan más variación en tránsito, pero no la fijan más deprisa. Para una mutación con ventaja selectiva , la fórmula de Kimura da la probabilidad de fijación
de modo que una ventaja del se fija con una probabilidad de alrededor del —cuarenta veces la de una mutación neutra en una población de dos mil, pero perdida aun así cuarenta y nueve veces de cada cincuenta—; y una desventaja con no se fija prácticamente nunca, mientras que una con se comporta como neutra: la selección solo ve lo que la deriva no anega, y la frontera está en —efectivamente neutra.
Demostración. Neutralidad: alguna copia presente hoy será la antepasada de toda la población en un futuro lejano, y por simetría cada una de las copias tiene la misma probabilidad de serlo; la nueva mutante es una copia, de ahí . Ritmo: sustituciones por generación (mutaciones que surgen por generación) (probabilidad de que cada una se fije) . La fórmula de Kimura se sigue de la aproximación por difusión al cambio de frecuencia alélica bajo deriva y selección, admitida aquí; sus límites se comprueban directamente: cuando , , el valor neutro; para el denominador vale y el numerador . Tiempo de fijación: la frecuencia de un alelo neutro hace un paseo aleatorio con varianza por generación, y el tiempo esperado para llegar a desde , condicionado a lograrlo, es de generaciones (Kimura y Ohta, 1969), admitido. ∎
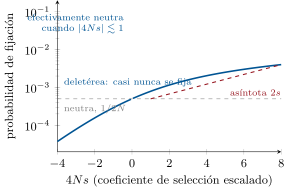
Evidencia. Kimura (1968) y King y Jukes (1969) hicieron el razonamiento a partir de los ritmos: el ritmo observado de sustitución de aminoácidos en las proteínas de los mamíferos implicaba más sustituciones por generación de las que permitía el coste de la selección de Haldane, de modo que la mayoría tenía que ser neutra. Las predicciones de la teoría se cumplieron después: los ritmos son máximos allí donde la función está menos constreñida —los sitios sinónimos, los intrones, los seudogenes, la tercera posición del codón— y mínimos en las histonas y en la ubiquitina, que cambian un residuo cada cien millones de años; el nivel de variación dentro de una especie acompaña a la mutación y al tamaño de la población; y el ritmo de sustitución por año es aproximadamente constante entre linajes de tamaños poblacionales muy distintos, como exige la fórmula y como no hace una explicación seleccionista. La polémica que siguió no la derribó: fijó el ritmo neutro como la hipótesis nula frente a la cual se mide la selección. ∎
25.2 El reloj molecular
Proposición 25.2 (El reloj y sus irregularidades)
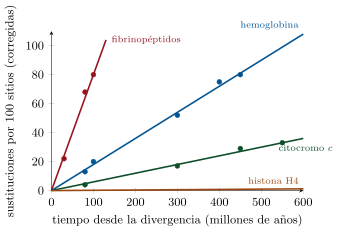
Si las sustituciones se acumulan a un ritmo constante por sitio y año en dos linajes que se separaron hace años, la fracción de sitios en los que difieren es, para valores pequeños, : la divergencia de dos secuencias es un reloj molecular (Zuckerkandl y Pauling, 1965), que puede calibrarse con una separación datada por fósiles y leerse después para separaciones sin fósiles. El reloj es estocástico —un proceso de Poisson, de modo que tiene una varianza aproximadamente igual a su media sobre un número fijo de sitios— y es irregular de tres maneras conocidas. Cada proteína tiene su propio ritmo, fijado por la fracción de sus sitios a los que la función permite cambiar: los fibrinopéptidos a , la hemoglobina a , el citocromo a y la histona H4 a sustituciones por sitio y por mil millones de años. Los ritmos difieren entre linajes: como el ritmo neutro es por generación, los animales de generación corta (roedores) acumulan más cambio al año que los de generación larga (primates, ballenas) —el efecto del tiempo de generación, compensado en parte porque los ritmos de mutación por generación suben con la duración de la generación. Y se satura: una vez que han cambiado muchos sitios, los cambios siguientes caen en sitios ya cambiados, de modo que la diferencia bruta ha de corregirse por impactos múltiples, como hacen las distancias del capítulo del alineamiento. Los relojes relajados modernos dejan que el ritmo varíe entre ramas dentro de un modelo estadístico y se calibran con muchos fósiles a la vez; datan la separación de humanos y chimpancés en seis o siete millones de años, la de los órdenes de mamíferos placentarios cerca del final del Cretácico y la de animales y hongos en el Precámbrico, con incertidumbres del diez al veinte por ciento que proceden sobre todo de los fósiles.
Demostración. Cada linaje acumula sustituciones por sitio, de modo que la diferencia entre ambos es allí donde los sitios no han recibido dos impactos; un par datado por fósiles da . La varianza de Poisson y los ritmos por proteína son los de Zuckerkandl y Pauling, los de Dickerson (1971) y los ajustes de Kimura a conjuntos de proteínas de vertebrados; la corrección por saturación es la fórmula de Jukes–Cantor del capítulo del alineamiento, . La variación de ritmo entre linajes se mostró con pruebas de ritmos relativos: con un grupo externo y dos especies y , las distancias deberían ser cero bajo un reloj estricto, y no lo son para roedores frente a primates. ∎
25.3 Leer la selección en las secuencias
Definición 25.3 (dN/dS)
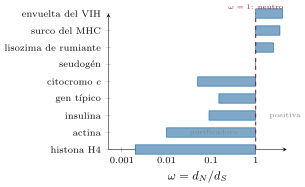
En un gen codificante de proteína, una sustitución es sinónima si deja el aminoácido sin cambiar y no sinónima si lo cambia. Como el código genético deja cambiar en silencio la mayoría de las terceras posiciones y algunas de las primeras, alrededor de una cuarta parte de las mutaciones posibles de un gen típico son sinónimas. Sea el número de sustituciones sinónimas por sitio sinónimo y el de sustituciones no sinónimas por sitio no sinónimo, corregidos ambos por impactos múltiples. Los cambios sinónimos son casi neutros, de modo que estima —el reloj—; y la razón
mide lo que la selección le ha hecho a la proteína: si los cambios de aminoácido son tan libres como los silenciosos (sin restricción, como en un seudogén); bajo selección purificadora, con la mayoría de los cambios eliminados —el gen típico tiene a , y las histonas —; bajo selección positiva, con los cambios de aminoácido favorecidos más deprisa de lo que permite la deriva sola —el surco de unión al antígeno de las moléculas del MHC, las proteínas de superficie de los virus en carrera de armamentos con los anticuerpos, las proteínas del espermatozoide y del óvulo en la fecundación, y la lisozima de los rumiantes, reclutada para digerir bacterias en el estómago. Calculado a lo largo de una rama de un árbol o sitio a sitio, cartografía dónde y cuándo cambió la selección una proteína en lugar del azar.
Método 25.4 (Estimar )
(1) Alinéense las dos secuencias codificantes codón a codón (alinéense las proteínas y trasládese después al ADN, de modo que ningún hueco rompa la pauta de lectura). (2) Cuéntense para cada codón los sitios sinónimos y no sinónimos: cada una de sus tres posiciones se puntúa por la fracción de cambios posibles que son silenciosos —una tercera posición cuádruplemente degenerada cuenta como un sitio sinónimo, una posición en la que todo cambio altera el aminoácido como un sitio no sinónimo, y una posición doblemente degenerada como un tercio de uno y dos tercios del otro. Súmese sobre los codones: sitios sinónimos y no sinónimos, con codones. (3) Cuéntense las diferencias sinónimas y no sinónimas entre las secuencias, resolviendo los codones que difieren en dos posiciones promediando sobre los caminos posibles. (4) diferencias, diferencias; corríjase cada uno por impactos múltiples con Jukes–Cantor. (5) ; contrástese frente a la varianza muestral, que es grande cuando es pequeño —dos secuencias muy emparentadas dan una razón poco fiable, y dos muy lejanas tienen un saturado. (6) Para el dónde y el cuándo: ajústese por rama de un árbol, o por sitio con una mezcla de clases de sitios, y compruébese si una clase con mejora el ajuste.
25.4 Genes nuevos a partir de genes viejos
Definición 25.5 (Duplicación, familias y transferencia)
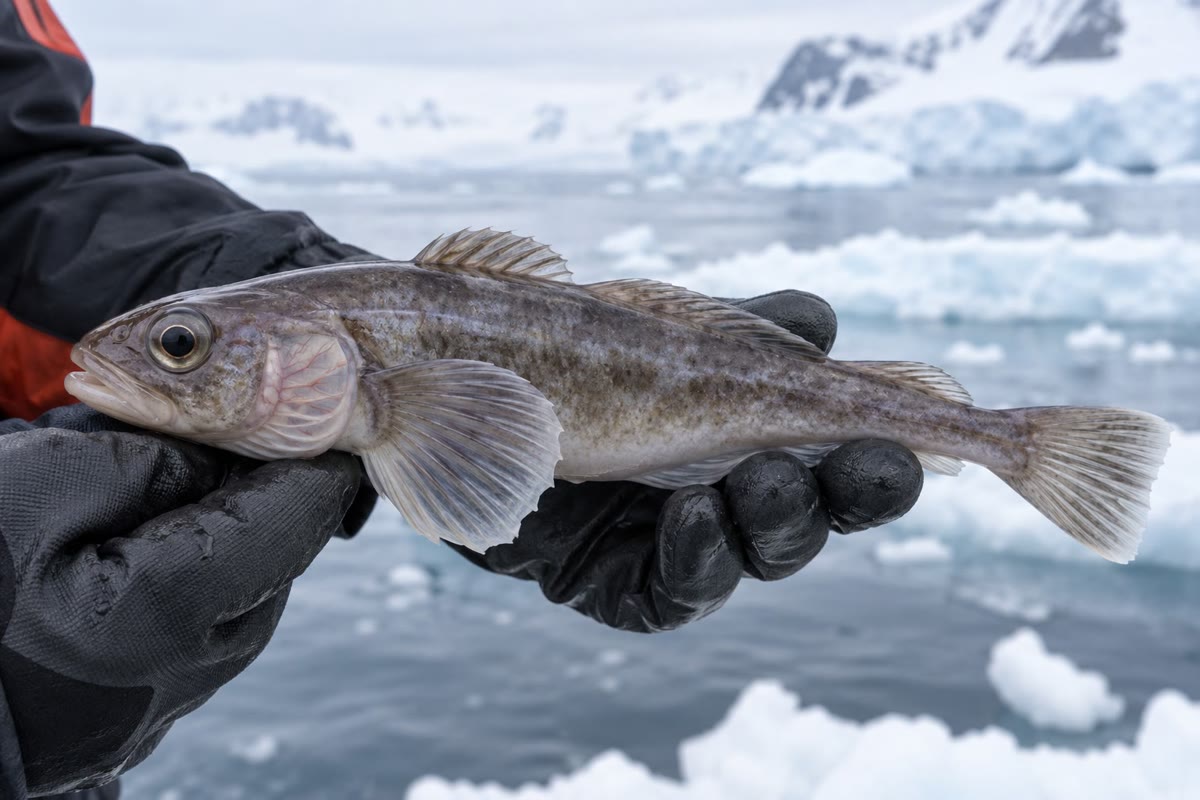
La mayoría de los genes nuevos son copias de genes viejos. Una duplicación génica —por sobrecruzamiento desigual, por retrotransposición o por la duplicación de un genoma entero, como ocurrió dos veces en el origen de los vertebrados y otra vez en el antepasado de los peces teleósteos y en muchos linajes vegetales— deja dos parálogos donde había uno; los genes de especies distintas descendientes de un solo gen ancestral son ortólogos. El destino habitual de la copia es la decadencia: liberada de la restricción (), acumula un codón de parada o un desplazamiento de pauta y se vuelve un seudogén, de los cuales el genoma humano lleva unos veinte mil. A veces sobreviven las dos: por neofuncionalización, cuando una copia adquiere una función nueva mientras la otra conserva la vieja (la glucoproteína anticongelante del pez de hielo, a partir de un gen de tripsinógeno; las opsinas roja y verde de los primates, a partir de una duplicación de hace cuarenta millones de años que dio la visión tricromática que describió el volumen del Año 1; las cristalinas del cristalino, a partir de enzimas metabólicas); o por subfuncionalización, cuando cada copia conserva parte de la expresión o de la actividad del antepasado, de modo que hacen falta las dos. La duplicación repetida construye familias génicas —las globinas, los grupos Hox del capítulo del desarrollo, los mil genes de receptores olfativos de un ratón, un tercio de ellos seudogenes en el ser humano. La otra fuente de genes nuevos es la transferencia horizontal: las bacterias adquieren genes de bacterias no emparentadas mediante plásmidos, fagos y ADN libre, que es como la resistencia a los antibióticos cruza especies en un hospital y por qué la “especie” de una bacteria es un genoma central rodeado de una nube cambiante; en los eucariotas la transferencia es más rara pero real —el T-DNA que Agrobacterium inserta en las plantas, los genes bacterianos de los rotíferos bdeloideos y las antiguas transferencias masivas que fueron la mitocondria y el cloroplasto. Allí donde la transferencia es común, la historia de la vida es una red, y el árbol dibujado a partir de un gen cualquiera es el árbol de ese gen.
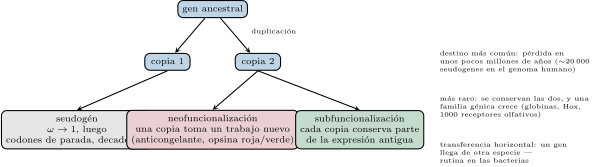
Evidencia. Ohno (1970) propuso la duplicación como fuente principal de genes nuevos antes de que se hubiera secuenciado una sola familia; las globinas lo confirmaron, con su árbol de , , , , mioglobina y las globinas vegetales y bacterianas ajustando las fechas de duplicación a la radiación de los vertebrados. Chen, DeVries y Cheng (1997) mostraron que el gen anticongelante del pez de hielo comparte su secuencia señal y sus secuencias flanqueantes con el tripsinógeno y que las repeticiones anticongelantes surgieron por expansión de un trozo de nueve nucleótidos que abarcaba una unión entre intrón y exón: una proteína nueva a partir de las piezas sueltas de una enzima digestiva, datada por el reloj en la congelación del océano Antártico. Thornton y sus colaboradores (2006) reconstruyeron la secuencia ancestral de los receptores de esteroides, sintetizaron la proteína de cuatrocientos cincuenta millones de años y hallaron que respondía solo a los estrógenos; dos sustituciones posteriores, identificadas y puestas a prueba, cambiaron la preferencia de la copia duplicada al cortisol —un antepasado resucitado, y el camino entre él y sus descendientes recorrido en el laboratorio. ∎
25.5 Árboles de genes y árboles de especies
Proposición 25.6 (Clasificación incompleta de linajes)
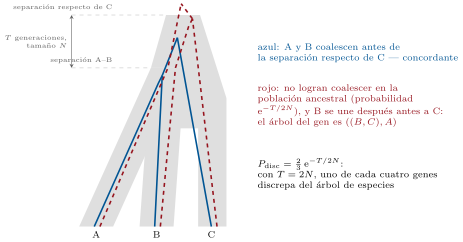
El árbol de un gen no tiene por qué coincidir con el árbol de las especies que lo llevan. Considérense tres especies con árbol de especies , con la separación – precedida por una población ancestral de tamaño que persistió generaciones antes de la separación respecto de . Dos copias del gen, una de y otra de , seguidas hacia atrás, coalescen en un antepasado común a un ritmo por generación; la probabilidad de que aún no hayan coalescido cuando entran en la población ancestral de las tres es , y entonces los tres linajes coalescen en orden aleatorio, de modo que dos tercios de las veces el árbol del gen agrupa a o a con . La probabilidad de que el árbol del gen discrepe del árbol de especies es, por tanto,
Para humanos, chimpancés y gorilas, con un de unos cientos de miles de generaciones y un cercano a , alrededor de un tercio del genoma respalda un árbol en el que los humanos están más cerca de los gorilas, o los chimpancés de los gorilas, que en el árbol de especies —y así se observa. Esta clasificación incompleta de linajes, junto con la duplicación y la pérdida y con la transferencia horizontal, es la razón de que la filogenómica infiera el árbol de especies a partir de miles de árboles de genes bajo un modelo coalescente, en lugar de concatenarlos y dibujar uno solo; permite además estimar los propios tamaños de las poblaciones ancestrales a partir de la fracción de árboles discordantes, y leer hibridaciones antiguas (el ADN neandertal de los humanos modernos, el flujo génico entre osos o entre mariposas) en árboles que discrepan en un sentido que la deriva sola no produciría.
Demostración. Dos linajes de una población diploide de eligen padres de entre copias cada generación y comparten uno con probabilidad ; a lo largo de generaciones, la probabilidad de no hacerlo nunca es . Los tres linajes que entran en la población ancestral común son intercambiables, de modo que el primer par en coalescer es cada uno de los tres pares con probabilidad ; solo el par coincide con el árbol de especies, de ahí que de estos casos sean discordantes. Ni el ritmo del coalescente ni la intercambiabilidad dependen del gen, de modo que la fórmula vale para cada locus neutro por separado, y la fracción de árboles discordantes de un genoma estima . ∎
Ejemplo 25.7 (Leer la historia de un genoma)
Las quinientas especies de cíclidos del lago Victoria surgieron en los quince mil años transcurridos desde que el lago volvió a llenarse —demasiado deprisa para que la mutación suministrara las diferencias entre ellas. Sus genomas muestran cómo: las variantes que distinguen a un pez que se alimenta del fondo de uno que raspa algas ya estaban presentes como variación permanente en los peces de río que colonizaron el lago, clasificadas y recombinadas, y aumentadas por hibridación entre linajes; los genes de las opsinas se afinaron para aguas claras o turbias mediante sustituciones que el de sus ramas muestra haber sido seleccionadas; y los árboles de genes discrepan entre sí a lo largo del genoma exactamente con el patrón que predicen la clasificación incompleta de linajes y el flujo génico. Una radiación no es el origen de genes nuevos, sino la redistribución de alelos viejos en combinaciones nuevas bajo una selección nueva —cosa que las secuencias registran, alelo a alelo, si uno sabe leer un árbol que en realidad es un bosque.
Observación 25.8 (El azar como línea de base)
La teoría neutralista no afirma que la selección sea poco importante; es un enunciado de lo que ocurre cuando la selección está ausente, lo bastante preciso para contrastarse. Como el ritmo neutro es el ritmo de mutación, la divergencia mide el tiempo; como el cambio neutro llena los sitios que la selección deja libres, mide la restricción; como los linajes neutros coalescen a un ritmo conocido, la discrepancia de los árboles de genes mide el tamaño de poblaciones que nadie vio. La selección es entonces lo que queda cuando se ha restado el azar —un gen con un por encima de uno, un barrido que ha vaciado de variación una región, un árbol que discrepa en un sentido que la deriva no puede explicar. El anticongelante del pez de hielo antártico, la lisozima estomacal del rumiante y la tercera opsina del primate son las excepciones halladas de este modo, y cada una es la historia de un gen copiado y un trabajo nuevo. El resto del genoma es un reloj.
25.6 Ejercicios
Ejercicio 25.1 ★
Enúnciese el ritmo neutro de sustitución y explíquese con palabras por qué no depende del tamaño de la población.
Solución
Solución de Ejercicio 25.1.
: el ritmo neutro de sustitución por sitio y generación es igual al ritmo de mutación. En cada generación surgen mutaciones neutras nuevas y cada una tiene una probabilidad de fijarse; una población mayor produce más mutaciones y da a cada una una probabilidad proporcionalmente menor, y los dos efectos se cancelan exactamente.
Ejercicio 25.2 ★
Defínanse ortólogo, parálogo y seudogén, con un ejemplo de cada uno en la familia de las globinas.
Solución
Solución de Ejercicio 25.2.
Ortólogos: genes de dos especies descendientes de un solo gen de su antepasado común —la -globina humana y la -globina de ratón. Parálogos: genes de un mismo genoma descendientes de una duplicación —la - y la -globina humanas, o la y la . Seudogén: una copia decaída que ya no codifica una proteína —el gen del grupo de la -globina humana, con sus codones de parada incluidos.
Ejercicio 25.3 ★
¿Qué mide ? Interprétense , y , y nómbrese un gen de cada clase.
Solución
Solución de Ejercicio 25.3.
compara el ritmo de sustitución que cambia aminoácidos con el ritmo de sustitución silenciosa, que es la línea de base neutra. : selección purificadora fuerte, con el de los cambios de aminoácido eliminados —actina, histona H3. : sin restricción —un seudogén. : selección positiva, con los cambios de aminoácido favorecidos —el surco de unión a péptidos del MHC, la envuelta del VIH, la lisozima de los rumiantes.
Ejercicio 25.4 ★
¿Por qué concluyó Kimura que la mayoría de las sustituciones son neutras? Reenúnciese el razonamiento con los números del comienzo del capítulo.
Solución
Solución de Ejercicio 25.4.
Las proteínas comparadas entre mamíferos cambian a alrededor de una sustitución por sitio y por mil millones de años; sobre un genoma de mil millones de sitios codificantes y una generación de unos pocos años, eso es del orden de una sustitución fijada por generación, o una cada dos años. El coste de la selección de Haldane permite alrededor de una sustitución seleccionada cada trescientas generaciones. Los ritmos difieren en un factor de cien o más, de modo que casi todos los cambios fijados han de ser neutros.
Ejercicio 25.5 ★★
. Calcúlese la probabilidad de fijación de una mutación nueva con , , y , con la fórmula de Kimura, y coméntese cuáles son efectivamente neutras.
Solución
Solución de Ejercicio 25.5.
Neutra: . , con : . : . : . Ninguna es efectivamente neutra: para eso haría falta , es decir, ; un coeficiente de selección de una décima de uno por ciento ya es decisivo en una población de cinco mil.
Ejercicio 25.6 ★★
Dos especies difieren en el de los sitios de un gen cuyo ritmo neutro es de por sitio y año. Estímese su tiempo de divergencia con y sin la corrección de Jukes–Cantor. ¿Con qué diferencia bruta alcanza la corrección un factor de dos?
Solución
Solución de Ejercicio 25.6.
Sin corregir: . Con Jukes–Cantor: , . La corrección alcanza un factor de dos cuando , en : para entonces la diferencia bruta ha perdido casi toda su información.
Ejercicio 25.7 ★★
Un gen de 300 codones tiene 700 sitios no sinónimos y 200 sinónimos. Entre dos especies muestra 7 diferencias no sinónimas y 10 sinónimas. Calcúlense , y (sin corregir). ¿Qué régimen selectivo? ¿Y si los recuentos fueran 35 y 10?
Solución
Solución de Ejercicio 25.7.
, , : selección purificadora que elimina cuatro quintas partes de los cambios de aminoácido. Con y : , : sin restricción detectable —un seudogén, o un gen en el que la selección positiva en algunos sitios equilibra la purificadora en otros.
Ejercicio 25.8 ★★
Las secuencias neutras de humano y chimpancé difieren en el ; la separación ocurrió hace y el tiempo de generación es de . Estímense el ritmo de mutación por sitio y generación, y el número de mutaciones nuevas en un genoma diploide de bases en cada generación.
Solución
Solución de Ejercicio 25.8.
por sitio y año; por sitio y generación; mutaciones nuevas por genoma diploide y generación. La secuenciación directa de padres e hijos encuentra unas setenta: la estimación por divergencia queda inflada por el polimorfismo ya presente en la población ancestral, que añade unos cientos de miles de generaciones a la separación aparente.
Ejercicio 25.9 ★★
Con y generaciones entre las dos separaciones, calcúlese la fracción de árboles de genes discordantes con el árbol de especies para humano, chimpancé y gorila. ¿Qué la dejaría en el ?
Solución
Solución de Ejercicio 25.9.
; fracción discordante, . Para el : , generaciones.
Ejercicio 25.10 ★★★
Muéstrese que la fórmula de Kimura se reduce a cuando y a para , y que para con se comporta como . Estímese entonces cuán deletérea ha de ser una mutación, en una población de , para que su probabilidad de fijación quede cien veces por debajo de la neutra.
Solución
Solución de Ejercicio 25.10.
Cuando : y , y la razón vale . Para el denominador es y el numerador . Para con : numerador , denominador , de modo que . Cien veces por debajo de la neutra con : ; da . Así que y : una desventaja de una centésima de uno por ciento basta, en diez mil individuos, para que la fijación sea cien veces más rara que por azar.
Ejercicio 25.11 ★★★
Una prueba de ritmos relativos: un grupo externo está a una distancia corregida de del ratón y de del ser humano, y el ratón y el ser humano distan . Calcúlense las longitudes de las ramas del ratón y del ser humano desde su separación (supóngase que el punto de separación equidista de por los dos caminos) y su razón. Con una generación de ratón de y una humana de , ¿qué razón predeciría un reloj estricto por generación, y qué dice la observación sobre los ritmos de mutación por generación?
Solución
Solución de Ejercicio 25.11.
Con el punto de separación a una distancia de por ambos caminos, , y : , de modo que y , con una razón de . Un reloj estricto por generación daría la razón de los recuentos de generaciones, . El observado significa que el ratón ha acumulado solo el doble de cambio anual que el ser humano pese a tener cincuenta veces más generaciones: el ritmo de mutación por generación ha de ser unas veces mayor en el ser humano —más divisiones celulares de la línea germinal por generación— de modo que por año los dos linajes difieran solo en un factor de dos.
Ejercicio 25.12 ★★★
Un gen duplicado queda liberado de la restricción () a un ritmo neutro por sitio y año. En una secuencia codificante de 1000 bases, ¿cuántos años cabe esperar, a grandes rasgos, hasta el primer codón de parada o desplazamiento de pauta (supóngase que alrededor del de las mutaciones puntuales aleatorias de una secuencia codificante crean un codón de parada, e ignórense las inserciones y deleciones)? Compárese con el tiempo del que dispone la selección para hallar una función nueva, y explíquese por qué la mayoría de los duplicados muere.
Solución
Solución de Ejercicio 25.12.
Las sustituciones que crean codones de parada llegan a por año: cabe esperar la primera al cabo de unos (los desplazamientos de pauta reducen esto casi a la mitad). En esa ventana, una mutación beneficiosa, una de cada a de todas las mutaciones, tiene mucha menos probabilidad de llegar que un codón de parada, e incluso cuando llega se fija con probabilidad solo . De modo que la copia suele estar muerta antes de que la selección pueda hallarle un uso —la semivida observada de los duplicados en los vertebrados es de unos pocos millones de años.
25.7 Problema: el ritmo del cambio
Problema 25.1
Problema de fin de semana — la historia de un genoma en números: el ritmo de mutación a partir de la divergencia entre humano y chimpancé, la carga de sustitución de Kimura, las probabilidades de fijación de las mutaciones seleccionadas, el de un gen a partir de recuentos de codones, el reloj leído para una duplicación y la discordancia de los árboles de genes entre los grandes simios, para terminar en el ritmo de mutación, el del gen y la fracción discordante
Datos: divergencia neutra humano–chimpancé ; separación hace ; generación ; genoma diploide de bases, con un codificante. Población ancestral . Gen: 400 codones, 920 sitios no sinónimos y 280 sinónimos; diferencias humano–ratón, 46 no sinónimas y 84 sinónimas. Separación humano–ratón, . Globina: y difieren en el de los sitios de aminoácido (bruto); ritmo de la hemoglobina, por sitio y año. Simios: entre las separaciones del gorila y del chimpancé, generaciones. Límite de Haldane: una sustitución seleccionada cada 300 generaciones.
Parte I — El ritmo.
- A partir de , calcúlese por sitio y año, y después por sitio y generación.
- Mutaciones nuevas por genoma diploide y generación, y cuántas de ellas caen en secuencia codificante.
- Sustituciones fijadas por generación en todo el genoma al ritmo neutro (la población fija por sitio y generación). Compárese con el límite de Haldane y sáquese la conclusión de Kimura.
- En una población de , ¿cuántas mutaciones neutras nuevas surgen por sitio y generación en toda la población, y qué fracción de ellas llegará a fijarse?
- ¿Cuánto tarda una mutación neutra destinada a fijarse, en generaciones y en años? Compárese con el tiempo transcurrido desde la separación humano–chimpancé.
- Explíquese por qué, pese a la pregunta 5, la divergencia entre dos especies mide el tiempo desde su separación y no el tiempo desde que se fijaron sus alelos.
Parte II — Las probabilidades de la selección.
- Probabilidad de fijación de una mutación neutra en , y de una con , y .
- ¿Para qué vale ? Interprétese la frontera.
- Una mutación deletérea con : probabilidad de fijación respecto de la neutra. ¿Y con ?
- Si una fracción de las mutaciones nuevas de un gen son beneficiosas con y el resto neutras, ¿qué fracción de las sustituciones de ese gen son adaptativas? Coméntese lo poco que se asoma la selección a la secuencia aun cuando actúa.
- Calcúlense y para el gen humano–ratón, corríjase cada uno con Jukes–Cantor y dese .
- Interprétese ; y estímese el ritmo neutro que implica el del gen (por sitio y año) con el tiempo de separación. ¿Es coherente con la pregunta 1?
Parte III — Relojes y copias.
- Corríjase por impactos múltiples la diferencia entre las globinas y (úsese , la versión para proteínas con muchos estados) y dátese la duplicación con el ritmo de la hemoglobina.
- La fecha cae cerca del origen de los vertebrados con mandíbulas (). ¿Qué permite tener cadenas y separadas que no permite una sola cadena?
- Los fibrinopéptidos cambian a por sitio y año. Dos especies se separaron hace : ¿diferencia bruta esperada? ¿Por qué es inútil esta proteína para datar separaciones de ?
- La histona H4 cambia a : ¿cuántas sustituciones en 100 sitios a lo largo de ? ¿Por qué es inútil para datar separaciones recientes?
- Un gen duplicado deriva con desde el momento de la duplicación. Si el de las sustituciones de secuencia codificante crean codones de parada y el gen tiene 1200 sitios a un ritmo de por sitio y año, estímese el tiempo esperado hasta el primer codón de parada.
- ¿Por qué da una duplicación de genoma entero a los duplicados más posibilidades de sobrevivir que una sola duplicación en tándem?
Parte IV — Árboles dentro de árboles.
- Probabilidad de que un linaje humano y uno de chimpancé no logren coalescer en las generaciones anteriores a la separación del gorila.
- Fracción de árboles de genes discordantes con el árbol de especies. Observada: alrededor del . ¿Es coherente?
- De los árboles discordantes, ¿qué fracción agrupa al humano con el gorila y qué fracción al chimpancé con el gorila? ¿Qué indicaría una desviación fuerte de la igualdad?
- Si la población ancestral hubiera sido de , ¿qué fracción discordante cabría esperar? ¿Qué dice, por tanto, la fracción observada sobre el número de nuestros antepasados?
- ¿Por qué concatenar mil genes en un solo alineamiento da un árbol seguro pero posiblemente equivocado, y qué hace en su lugar un método coalescente?
- El ADN neandertal de los humanos no africanos ronda el , y los árboles que lo llevan agrupan a algunos europeos con los neandertales más a menudo que a los africanos. ¿Por qué no es esto una clasificación incompleta de linajes?
- Resúmase: (pregunta 1), el del gen (pregunta 11) y la fracción discordante (pregunta 20).
Solución
Solución de Problema 25.1.
1. por sitio y año; por sitio y generación. 2. mutaciones nuevas por genoma diploide; el de ellas, unas , en secuencia codificante. 3. Por genoma haploide, sustituciones fijadas por generación, frente al de Haldane: veinte mil veces más de lo que la selección podría impulsar, de modo que la abrumadora mayoría son neutras. 4. mutaciones nuevas por sitio y generación en la población; se fijará de ellas. 5. generaciones, —casi tanto como el tiempo transcurrido desde la separación. 6. La divergencia cuenta las mutaciones que surgieron a lo largo de los dos linajes separados desde su antepasado común; cada una se fija dentro de su propio linaje, y el ritmo a largo plazo es sea cual sea el tiempo que tarde cada una, ya que las mutaciones surgen de forma continua y el retardo solo demora el flujo, sin cambiarlo. (La única corrección es por el polimorfismo presente en la separación, que hace que el antepasado común de dos alelos sea más antiguo que la separación de las especies.) 7. Neutra, ; : ; : ; : . 8. : por debajo de esto la deriva anega a la selección y la mutación se comporta como neutra; por encima, la selección gobierna las probabilidades. 9. : , cero a todos los efectos — de la neutra. , con : , el de la neutra: las mutaciones levemente deletéreas sí se fijan. 10. Sustituciones beneficiosas por sitio y generación: ; neutras: . Fracción adaptativa, . Aunque cada mutación beneficiosa tiene dos mil veces más probabilidad de fijarse que una neutra, son tan raras que solo una sustitución de cada cincuenta es adaptativa: la selección actúa y apenas se asoma. 11. , . Corregidos: , . . 12. Selección purificadora que elimina alrededor del de los cambios de aminoácido —un gen típico. por sitio y año: el doble del valor humano–chimpancé, como cabe esperar de una comparación que incluye el linaje de tictac rápido de los roedores; el mismo orden de magnitud. 13. por sitio; . 14. Dos cadenas distintas forman el tetrámero , cuya unión cooperativa del oxígeno, efecto Bohr y control alostérico por el 2,3-bisfosfoglicerato dependen de la interfaz entre subunidades distintas; y el grupo pudo diversificarse después en cadenas embrionarias, fetales y adultas con afinidades distintas. 15. sustituciones por sitio; con la saturación entre veinte aminoácidos, la diferencia bruta es de alrededor de . A , : todos los sitios han cambiado muchas veces y la diferencia bruta se sitúa en su techo del , sin llevar información alguna sobre el tiempo. 16. sustituciones entre dos linajes en 100 sitios a lo largo de mil millones de años. Para una separación de la esperanza es : casi siempre cero diferencias, sin resolución. 17. por año: cabe esperar la primera parada al cabo de unos . 18. Duplicar el genoma entero duplica todos los genes a la vez, de modo que se conserva la estequiometría de las proteínas que interaccionan y ningún desequilibrio de dosis selecciona contra las copias; una duplicación en tándem aislada cambia la dosis de un solo gen y a menudo es deletérea, o bien es redundante de inmediato y queda libre para decaer. 19. . 20. : coherente con el observado. 21. La mitad cada una: el de todos los árboles agrupa al humano con el gorila y el al chimpancé con el gorila. Un exceso claro de uno indicaría flujo génico entre esas dos especies después de su separación, cosa que la deriva no puede producir. 22. : , y una discordancia del . El observado exige, por tanto, una población ancestral de unos cincuenta mil —varias veces el tamaño efectivo del ser humano actual. 23. La concatenación supone que todo gen tiene el árbol de especies; con clasificación incompleta de linajes los genes tienen muchos árboles, y para ramas internas cortas el árbol de genes más común puede diferir del árbol de especies, de modo que más datos hacen más segura la respuesta equivocada. Un método coalescente calcula, para cada árbol de especies candidato, la distribución esperada de árboles de genes, y elige el árbol de especies que mejor explica las frecuencias observadas. 24. La clasificación incompleta de linajes ocurrió en la población ancestral común de todos los humanos modernos, de modo que haría a toda población humana igualmente emparentada con los neandertales. Un exceso en los no africanos significa que los alelos neandertales entraron después de que los antepasados de los no africanos salieran de África: mestizaje, hace unos cincuenta mil años. 25. por sitio y generación; ; alrededor del de los árboles de genes discordantes con el árbol de especies.