Biología universitaria — primer año · Bachelor Year 1
19Expresión génica: transcripción y traducción
Un gen de treinta mil pares de bases se lee en un cuarto de hora hasta formar una copia de trabajo, se recorta a dos mil letras, se envía fuera del núcleo y lo traducen veinticinco ribosomas a la vez en una proteína de quinientos aminoácidos: uno cada cuatro segundos, mientras dure la copia. La célula gasta en esto más energía que en ninguna otra cosa. Este capítulo sigue la información desde el ADN hasta la proteína: la copia de un gen a ARN, la edición de ese ARN en los eucariotas, el código que asigna aminoácidos a los tripletes de bases, el ribosoma que lo lee, y lo que le ocurre a una proteína una vez fabricada.
19.1 Del gen a la proteína
Proposición 19.1 (El flujo de la información)
La información genética fluye del ADN al ARN y del ARN a la proteína. La transcripción copia una hebra de un gen a un ARN de la misma secuencia que la otra hebra (con U en lugar de T); la traducción lee el ARN mensajero de tres bases en tres bases y ensambla los aminoácidos correspondientes en un polipéptido. Todos los pasos usan el apareamiento de bases: el ADN con el ARN en la transcripción, y el mensajero con el ARN de transferencia en la traducción. La secuencia de una proteína es, pues, una transcripción de la secuencia de su gen, y el cambio de una sola base puede cambiar un aminoácido: es el vínculo entre mutación y fenotipo. La información no fluye de vuelta de la proteína al ácido nucleico; el único paso inverso, el ARN copiado a ADN por los retrovirus, no toca la proteína.
19.2 La transcripción
Definición 19.2 (ARN polimerasa, promotor, transcripción)
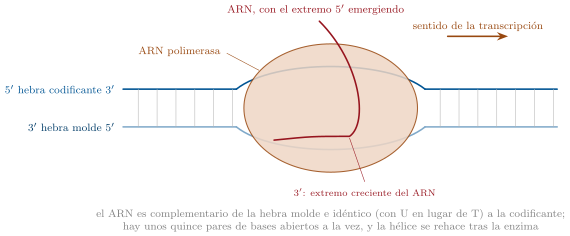
La ARN polimerasa sintetiza ARN sobre un molde de ADN, de , a partir de los cuatro ribonucleósidos trifosfato y sin cebador. Empieza en un promotor, una secuencia situada justo aguas arriba del gen que la enzima reconoce y a la que se une; en las bacterias una subunidad llamada (sigma) se encarga del reconocimiento, en dos tramos conservados diez y treinta y cinco pares antes del inicio. La enzima abre unos quince pares de la hélice formando una burbuja de transcripción, copia la hebra molde (leída de ) a un ARN de secuencia idéntica a la otra hebra, la codificante, y avanza a unos cincuenta nucleótidos por segundo mientras vuelve a cerrar la hélice tras de sí; el ARN se desprende a medida que se fabrica. Se detiene en un terminador: en las bacterias, una secuencia autocomplementaria cuyo ARN se pliega en una horquilla que libera el transcrito. Muchas polimerasas pueden seguirse unas a otras a lo largo de un gen, de modo que puede iniciarse un transcrito cada segundo.
Proposición 19.3 (Transcripción y maduración del ARN en eucariotas)
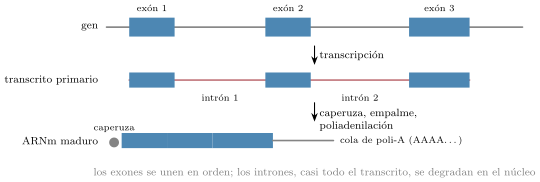
Los eucariotas tienen tres polimerasas: la I para los ARN ribosómicos grandes, la II para los ARN mensajeros y la III para los ARN de transferencia y otros ARN pequeños. La polimerasa II no reconoce su promotor por sí sola: un conjunto de factores generales de transcripción se ensambla sobre él (en una secuencia TATA situada unos treinta pares aguas arriba en muchos genes) y recluta la enzima, y proteínas reguladoras unidas cerca o lejos modulan la velocidad (Capítulo 20). El transcrito primario se madura en el núcleo: se añade una guanina modificada, la caperuza, al extremo , una cola de unas doscientas adeninas (poli-A) al extremo , y se retiran los intrones por corte y empalme: un complejo de ARN pequeños y proteínas, el espliceosoma, reconoce el GU del inicio de cada intrón y el AG de su final, corta y une los exones. Solo entonces se exporta al citosol el mensajero maduro. Muchos genes se cortan y empalman de más de una manera (empalme alternativo), de modo que un gen rinde varias proteínas; los veinte mil genes humanos fabrican quizá cien mil.
Evidencia. Sharp y Roberts (1977) hibridaron un ARN mensajero vírico con el ADN de su gen y observaron los híbridos al microscopio electrónico: el ARN se apareaba con el ADN en varios tramos y, entre ellos, el ADN formaba bucles sin aparear: los intrones, presentes en el gen y ausentes del mensaje. Los genes bacterianos, tratados igual, no daban bucles. El tamaño del transcrito primario de un gen, medido en el núcleo, coincide con el gen; el tamaño del mensajero citoplásmico coincide solo con los exones. ∎
19.3 El código genético
Definición 19.4 (El código genético)
El código genético asigna aminoácidos a los tripletes de bases del mensajero, los codones. De los 64 codones, 61 especifican los veinte aminoácidos y tres (UAA, UAG, UGA) son señales de parada; AUG especifica metionina y es además el codón de inicio, de modo que todo polipéptido nuevo empieza por metionina. El código es degenerado — casi todos los aminoácidos tienen varios codones, que difieren sobre todo en la tercera posición —, no solapado, se lee sin puntuación en un marco de lectura fijado por el codón de inicio, y es casi universal: el mismo en bacterias, plantas y animales, con variantes menores en las mitocondrias; un gen humano introducido en una bacteria se lee correctamente.
| primera | segunda base | tercera | |||
| base | U | C | A | G | base |
| U | Phe Phe Leu Leu | Ser Ser Ser Ser | Tyr Tyr parada parada | Cys Cys parada Trp | U C A G |
| C | Leu Leu Leu Leu | Pro Pro Pro Pro | His His Gln Gln | Arg Arg Arg Arg | U C A G |
| A | Ile Ile Ile Met | Thr Thr Thr Thr | Asn Asn Lys Lys | Ser Ser Arg Arg | U C A G |
| G | Val Val Val Val | Ala Ala Ala Ala | Asp Asp Glu Glu | Gly Gly Gly Gly | U C A G |
Proposición 19.5 (Cómo se descifró el código)
El código es un código de tripletes no solapado, y el significado de cada codón puede determinarse por vía química.
Evidencia. Crick y Brenner (1961) produjeron en un gen de fago mutaciones que añadían o quitaban una base: un cambio de esos destruía la función del gen, y dos también, pero tres inserciones (o tres deleciones) próximas entre sí la restablecían: el mensaje se lee de tres en tres, desde un punto de partida fijo, y una inserción desplaza el marco de todo lo que viene después. Nirenberg y Matthaei (1961) añadieron un ARN sintético formado solo por uracilos a un extracto acelular de E. coli con los veinte aminoácidos: se fabricó una cadena solo de fenilalanina, luego UUU significa Phe; otros mensajeros sintéticos, y después la unión de trinucleótidos sueltos a ribosomas con sus ARN de transferencia, asignaron los sesenta y cuatro en 1966. ∎
Ejemplo 19.6 (Leer un mensaje)
El mensajero -…GCAUGGCUUUCGGAUAA…- se lee desde el AUG: AUG GCU UUC GGA UAA — Met-Ala-Phe-Gly-parada: un péptido de cuatro residuos. Elimínese la primera G tras el AUG y el marco se desplaza: AUG CUU UCG GAU AA… — Met-Leu-Ser-Asp…, una proteína distinta de longitud distinta. Cámbiese UUC por UUU y no cambia nada: ambos son Phe, una mutación silenciosa.
19.4 La traducción
Definición 19.7 (El ARN de transferencia y sus sintetasas)
Un ARN de transferencia (Capítulo 11) es el adaptador entre el codón y el aminoácido: su anticodón, tres bases en un bucle, se aparea de forma antiparalela con un codón del mensaje, y su extremo lleva el aminoácido correspondiente. El apareamiento en la tercera posición del codón es laxo (balanceo), de modo que unos cuarenta ARNt bastan para sesenta y un codones. A cada ARNt lo carga su propia aminoacil-ARNt sintetasa, una enzima que reconoce a la vez el aminoácido y el ARNt y los une en dos etapas a costa de un ATP (escindido hasta AMP: dos enlaces ricos en energía), y que corrige el aminoácido mientras lo hace. Esas veinte enzimas son donde el código se aplica realmente: el ribosoma no comprueba qué aminoácido lleva un ARNt, solo que su anticodón encaje.
Definición 19.8 (El ribosoma)
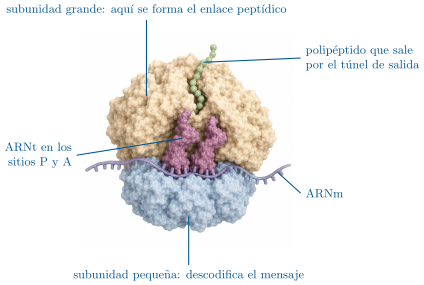
El ribosoma es una partícula de dos subunidades, cada una de ARN ribosómico y proteínas (en las bacterias: una subunidad pequeña 30S y una grande 50S, juntas 70S, ; los ribosomas eucariotas son mayores, 80S). La subunidad pequeña se une al mensajero y lo descodifica; la grande sostiene los ARNt y forma el enlace peptídico, y el catalizador es el propio ARN ribosómico. Tres sitios para ARNt abarcan ambas subunidades: el A (aminoacil, donde entra el siguiente ARNt cargado), el P (peptidil, que sostiene la cadena en crecimiento) y el E (salida).
Proposición 19.9 (El ciclo de elongación)
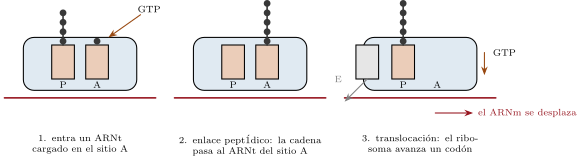
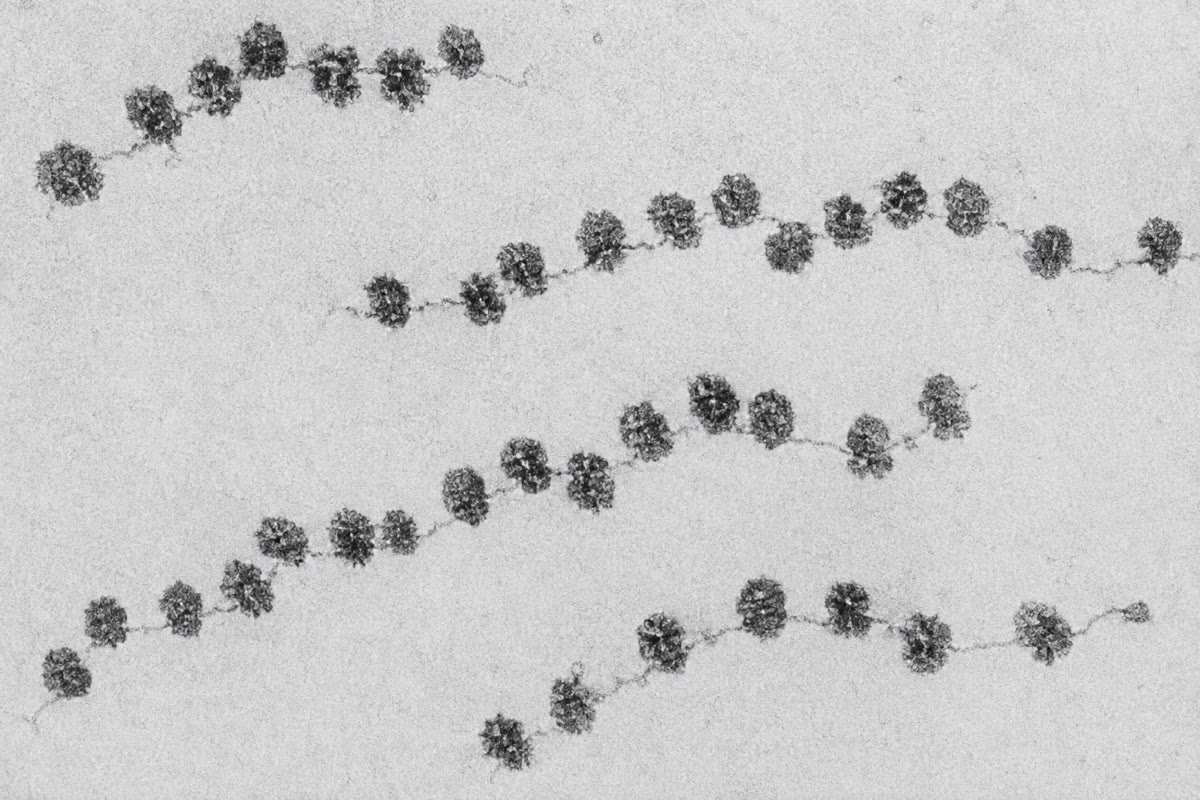
La traducción empieza cuando la subunidad pequeña encuentra el codón de inicio — en las bacterias apareando una secuencia del ARN ribosómico con un sitio situado justo aguas arriba del AUG, y en los eucariotas uniéndose a la caperuza y rastreando hasta el primer AUG — y el ARNt iniciador (metionina) se aloja en el sitio P; después se une la subunidad grande. Cada vuelta de elongación añade un residuo: un factor de elongación entrega y comprueba un ARNt cargado cuyo anticodón encaje con el codón del sitio A (un GTP); el ARN ribosómico de la subunidad grande transfiere la cadena en crecimiento desde el ARNt del sitio P al aminoácido del ARNt del sitio A y forma el enlace peptídico; el ribosoma avanza un codón (un segundo GTP), con lo que los ARNt pasan a P y a E, y el vacío se marcha. En un codón de parada, un factor de liberación entra en el sitio A y la cadena se libera por hidrólisis. Los ribosomas bacterianos añaden de quince a veinte residuos por segundo y los eucariotas de dos a cinco; varios ribosomas leen un mismo mensaje a la vez y forman un polisoma.
Método 19.10 (Cálculo de la síntesis de una proteína)
- Longitud: una proteína de residuos necesita una secuencia codificante de nucleótidos (incluido el codón de parada), dentro de un mensajero más largo por sus extremos no traducidos y, en el gen, por sus intrones.
- Tiempo: divídase por la velocidad de elongación (de por segundo en las bacterias y de en los eucariotas); el mensaje lo lee un ribosoma cada nucleótidos, así que la producción por mensaje es una cadena cada (separación / velocidad) segundos.
- Energía: cuatro enlaces fosfato ricos en energía por residuo (dos para cargar el ARNt y dos GTP en el ribosoma), más la transcripción del mensaje a dos por nucleótido, repartida entre todas las cadenas que rinde ese mensaje.
- Fidelidad: alrededor de un aminoácido equivocado por cada codones; una proteína de residuos está mal en algún punto en una copia de cada veinte, lo que se tolera porque las proteínas son reemplazables y los errores no se heredan.
19.5 Después de la traducción
Proposición 19.11 (Qué le ocurre a un polipéptido nuevo)
La cadena se pliega a medida que emerge, con la ayuda de las chaperonas (Capítulo 12). Su destino está escrito en su secuencia: un péptido señal del extremo N se une a una partícula de reconocimiento de la señal que detiene la traducción, acopla el ribosoma al retículo endoplasmático y enhebra la cadena en su luz (Capítulo 6); otras secuencias dirigen proteínas a las mitocondrias, los cloroplastos, el núcleo o los peroxisomas tras la síntesis; y una proteína sin señal se queda en el citosol. Muchas proteínas se modifican: se retira la metionina inicial, se añaden azúcares en el RE y en el Golgi, las quinasas y las fosfatasas añaden y retiran fosfatos, se unen lípidos, se cortan trozos (la insulina se fabrica como una sola cadena y se corta en dos; los zimógenos se cortan para activarse). Y toda proteína acaba degradada: se marca con una proteína pequeña, la ubiquitina, y el proteasoma la despliega y la digiere, tras una vida de minutos (las proteínas reguladoras) a meses (la hemoglobina), de modo que las proteínas presentes son las que la célula está fabricando en ese momento.
Ejemplo 19.12 (Las cifras de una célula)
Una E. coli en crecimiento contiene unos ribosomas, cada uno de los cuales añade veinte residuos por segundo: residuos por segundo, un millón de proteínas de residuos en una hora, es decir, su propio contenido, que es lo que exige duplicarse cada hora. La mitad de su energía va a la síntesis de proteínas. Una célula hepática contiene diez millones de ribosomas y fabrica proteínas para semanas de uso y no para dividirse; una célula plasmática, que secreta anticuerpos, dedica casi todos a una sola proteína y vierte dos mil moléculas por segundo.
19.6 Ejercicios
Ejercicio 19.1 ★
Dese el ARN transcrito a partir de la hebra molde -TACGGATTC-, y la hebra codificante.
Ejercicio 19.2 ★
Enumérense las tres modificaciones que sufre un transcrito primario eucariota antes de salir del núcleo.
Solución
Solución de Ejercicio 19.2.
Una caperuza (guanina modificada), una cola de poli-A y la retirada de los intrones por corte y empalme.
Ejercicio 19.3 ★
Con la tabla del código, tradúzcase -AUGCCGAAAGUUUGA-.
Solución
Solución de Ejercicio 19.3.
AUG CCG AAA GUU UGA: Met-Pro-Lys-Val, y después parada.
Ejercicio 19.4 ★
Nómbrense los tres sitios para ARNt del ribosoma y qué ocurre en cada uno.
Solución
Solución de Ejercicio 19.4.
A: se admite y se comprueba el ARNt cargado entrante. P: el ARNt que lleva la cadena en crecimiento; el enlace se forma entre esa cadena y el aminoácido del sitio A. E: el ARNt vaciado, de salida.
Ejercicio 19.5 ★★
Un mensajero de nucleótidos tiene de región no traducida y de región no traducida y poli-A. ¿Cuántos residuos tiene la proteína? ¿Cuánto tarda un ribosoma en fabricarla a cuatro residuos por segundo, y cuántos ribosomas pueden leer el mensaje a la vez, a uno por cada nucleótidos?
Solución
Solución de Ejercicio 19.5.
Codificantes: nucleótidos: 599 residuos (600 codones, uno de parada). Tiempo: . Ribosomas: a la vez.
Ejercicio 19.6 ★★
Explíquese por qué tres inserciones restablecen el marco de lectura de un gen y una o dos no, y qué aspecto tiene la proteína fabricada a partir de la inserción triple.
Solución
Solución de Ejercicio 19.6.
El mensaje se lee de tres en tres desde un inicio fijo; una o dos bases de más desplazan todos los codones siguientes y el resto de la proteína es disparate, que suele terminar en una parada prematura. Tres bases de más añaden un codón y restablecen el marco: la proteína tiene un residuo de más y unos pocos equivocados entre las inserciones, y a menudo sigue funcionando.
Ejercicio 19.7 ★★
Una mutación cambia el codón CAG por UAG en mitad de un gen de codones; otra cambia CAG por CAA; y una tercera lo cambia por CGG. Dese el efecto de cada una sobre la proteína.
Solución
Solución de Ejercicio 19.7.
CAG (Gln) a UAG (parada): la cadena termina en el residuo 150, una proteína truncada y casi con seguridad inactiva (mutación sin sentido). CAG a CAA: sigue siendo Gln, silenciosa. CAG a CGG: Arg en lugar de Gln, una sustitución (de sentido erróneo) cuyo efecto depende de la posición.
Ejercicio 19.8 ★★
Explíquese por qué la fidelidad de la traducción descansa en las aminoacil-ARNt sintetasas y no en el ribosoma, y descríbase un experimento que lo demostrara (una cisteína unida a su ARNt se convierte químicamente en alanina; ¿dónde acaba la alanina?).
Solución
Solución de Ejercicio 19.8.
El ribosoma solo comprueba el apareamiento entre codón y anticodón; no puede ver el aminoácido. Si una cisteína unida a su ARNt se convierte químicamente en alanina, el ribosoma inserta alanina allí donde el mensaje dice cisteína: se lee el ARNt, no el aminoácido. Por tanto, la verdadera traductora es la sintetasa, que empareja cada aminoácido con el ARNt adecuado.
Ejercicio 19.9 ★★
Calcúlense el coste energético, en enlaces ricos en energía, de una proteína de residuos, y la fracción de ese coste que corresponde al ribosoma.
Solución
Solución de Ejercicio 19.9.
enlaces; los dos GTP por residuo del ribosoma son la mitad, y los dos de las sintetasas la otra mitad.
Ejercicio 19.10 ★★★
En las bacterias los ribosomas empiezan a traducir un mensaje mientras todavía se está transcribiendo; en los eucariotas no pueden. Explíquese por qué (dos razones), y qué hace posible esa diferencia en los eucariotas.
Solución
Solución de Ejercicio 19.10.
En los eucariotas el transcrito se fabrica en el núcleo y los ribosomas están en el citosol, separados por la envoltura; y el transcrito no es un mensajero hasta que se ha empalmado y se le ha puesto la caperuza. La separación hace posible la maduración misma: el empalme alternativo, el control de la exportación y la comprobación de que el mensaje está completo antes de leerlo.
Ejercicio 19.11 ★★★
Un gen de cinco exones puede empalmarse incluyendo o saltándose el exón 3 ( nucleótidos) y el exón 4 ( nucleótidos). Enumérense los mensajeros posibles y dígase cuáles conservan el marco de lectura del exón 5. ¿Qué muestra esto sobre el empalme alternativo?
Solución
Solución de Ejercicio 19.11.
Cuatro mensajeros: con los dos exones (190 nucleótidos añadidos), solo con el 3 (90), solo con el 4 (100) y con ninguno (0). El marco se conserva si la longitud añadida es múltiplo de 3: 0 y 90 lo conservan; 100 y 190 lo desplazan, de modo que los mensajeros con el exón 4 solo o con ambos exones leen el exón 5 fuera de marco y truncan la proteína. El empalme alternativo debe respetar el marco, y por esa razón los exones son a menudo múltiplos de tres.
Ejercicio 19.12 ★★★
“El código es un accidente congelado: arbitrario, pero demasiado costoso de cambiar.” Discútase en un párrafo: qué parece arbitrario en el código, qué parece optimizado (la tercera posición, codones parecidos para aminoácidos parecidos) y por qué una mutación que cambie la especificidad de una sintetasa es casi siempre letal.
Solución
Solución de Ejercicio 19.12.
Arbitrario: nada en la química dice que UUU deba significar Phe; las asignaciones son convenios que sostienen las sintetasas. Optimizado: la tercera posición es la más degenerada, de modo que los errores y las mutaciones que caen ahí son a menudo silenciosos, y los codones que difieren en una base tienden a codificar aminoácidos parecidos, con lo que una sustitución suele ser leve: el código minimiza el daño del error. Congelado: una sintetasa que cambiara su especificidad alteraría todas las proteínas de la célula a la vez, miles de ellas, en el mismo instante; casi ninguna célula sobrevive a eso, así que el código no puede derivar y está fijado desde el antepasado común de todos los seres vivos.
19.7 Problema: de un gen a una proteína
Problema 19.1
Problema de fin de semana — un gen de treinta kilobases seguido hasta una proteína de quinientos residuos: transcripción cronometrada, empalme pesado, ribosomas contados, energía y errores calculados, hasta llegar al coste en ATP de una proteína
Un gen humano abarca con ocho exones que suman nucleótidos de mensajero maduro, de los cuales codifican (500 residuos más la parada). La polimerasa II transcribe a nucleótidos por segundo; los ribosomas alargan a residuos por segundo y se espacian uno cada nucleótidos; la vida media del mensajero es de . Costes: dos enlaces ricos en energía por nucleótido transcrito y cuatro por residuo traducido; tómese un enlace rico en energía como un ATP. Tasas de error: por nucleótido transcrito y por codón traducido.
Parte I — Transcripción y empalme.
- ¿Cuánto tarda una polimerasa en transcribir el gen?
- ¿Qué fracción del transcrito primario retira el empalme?
- ¿Cuántos nucleótidos se transcriben por cada nucleótido de mensajero maduro?
- Calcúlese el ATP gastado en transcribir un transcrito primario.
- Si una polimerasa arranca cada , ¿cuántas polimerasas hay a la vez sobre el gen, y cuántos mensajeros produce el gen por hora?
- Calcúlense el número de intrones y su longitud media.
- El espliceosoma retira cada intrón en aproximadamente un minuto, en paralelo. ¿Qué fija el tiempo desde el gen hasta el mensajero, el empalme o la transcripción?
- Calcúlense la longitud física del gen y la del mensajero maduro ( por nucleótido).
Parte II — Traducción.
- ¿Cuánto tarda un ribosoma en traducir la proteína?
- ¿Cuántos ribosomas leen a la vez un mensajero?
- ¿Cuántas moléculas de proteína rinde un mensajero por hora?
- A lo largo de su vida media de , ¿cuántas rinde en total (un mensaje de vida media rinde, de promedio, horas de producción plena)?
- Calcúlese el ATP gastado en traducir una proteína.
- Calcúlese el ATP gastado en la transcripción por proteína, repartiendo el coste del transcrito entre las proteínas de la pregunta 12.
- Calcúlense el coste total de una proteína y la fracción debida a la traducción.
Parte III — Errores.
- Calcúlese la probabilidad de que un mensajero dado lleve al menos un error de transcripción en sus nucleótidos codificantes.
- Calcúlese la probabilidad de que una molécula dada de proteína lleve al menos un error de traducción.
- Alrededor de una cuarta parte de los cambios de nucleótido son silenciosos y un tercio de las sustituciones de aminoácido son inocuas. ¿Qué fracción de las moléculas de proteína fabricadas es defectuosa?
- Un mensajero defectuoso rinde proteínas defectuosas durante dos horas; una proteína defectuosa es una sola molécula. Explíquese por qué la célula puede permitirse una tasa de error de traducción diez veces la de transcripción, y ambas muy por encima de la de replicación.
Parte IV — El presupuesto de la célula. La célula fabrica copias de esta proteína por hora y, en total, residuos de proteína al día.
- ¿Cuántos mensajeros de este gen deben estar presentes a la vez (rindiendo cada uno la cantidad de la pregunta 11)?
- ¿Cuántos ribosomas ocupa esta proteína?
- Calcúlense el ATP diario que la célula gasta en toda su síntesis de proteínas (cuatro por residuo) y, a , la potencia en vatios para una célula de .
- Compárese con la potencia total de la célula si consume ATP por segundo.
- Un fármaco bloquea el espliceosoma. Predígase su efecto sobre esta proteína y sobre una proteína bacteriana.
- Enúnciese el resultado: el coste en ATP de una molécula de la proteína, repartido entre traducción y transcripción, y el tiempo desde el inicio de la transcripción hasta la primera proteína terminada.
Solución
Solución de Problema 19.1.
1. , unos . 2. . 3. . 4. ATP. 5. polimerasas sobre el gen; 360 mensajeros por hora. 6. Siete intrones, de longitud media nucleótidos. 7. La transcripción (); los intrones se empalman a medida que se fabrican, y el último añade solo un minuto. 8. Gen, ; mensajero, . 9. . 10. . 11. Una cadena termina cada : 180 por hora. 12. de producción plena: unas 520 proteínas. 13. ATP. 14. ATP por proteína. 15. Unos 2100 ATP, el de ellos en la traducción. 16. . 17. . 18. Transcripción: de mensajeros defectuosos y, por tanto, de proteínas; traducción: ; alrededor del de las moléculas. 19. Un error de proteína queda confinado a una molécula, que pronto se degrada; un error de mensajero se copia en cientos de proteínas; un error de replicación lo heredan todos los descendientes para siempre. El coste de un error, y por tanto la precisión por la que vale la pena pagar, sube en cada paso hacia atrás. 20. mensajeros presentes. 21. ribosomas. 22. ATP al día , al día, es decir, : por micrómetro cúbico. 23. ATP por segundo son al día: la síntesis de proteínas es la centésima parte en esta célula de renovación lenta (en una bacteria en división es la mitad). 24. No hay mensajero maduro: los transcritos primarios se acumulan en el núcleo y la proteína desaparece a medida que sus mensajeros se degradan, en cuestión de horas. La proteína bacteriana, cuyo gen no tiene intrones, no se ve afectada. 25. Unos 2100 ATP por molécula: 2000 para la traducción y un centenar por su parte del transcrito; la primera proteína, tras de transcripción, un minuto de maduración y exportación y de traducción: unos veinte minutos.